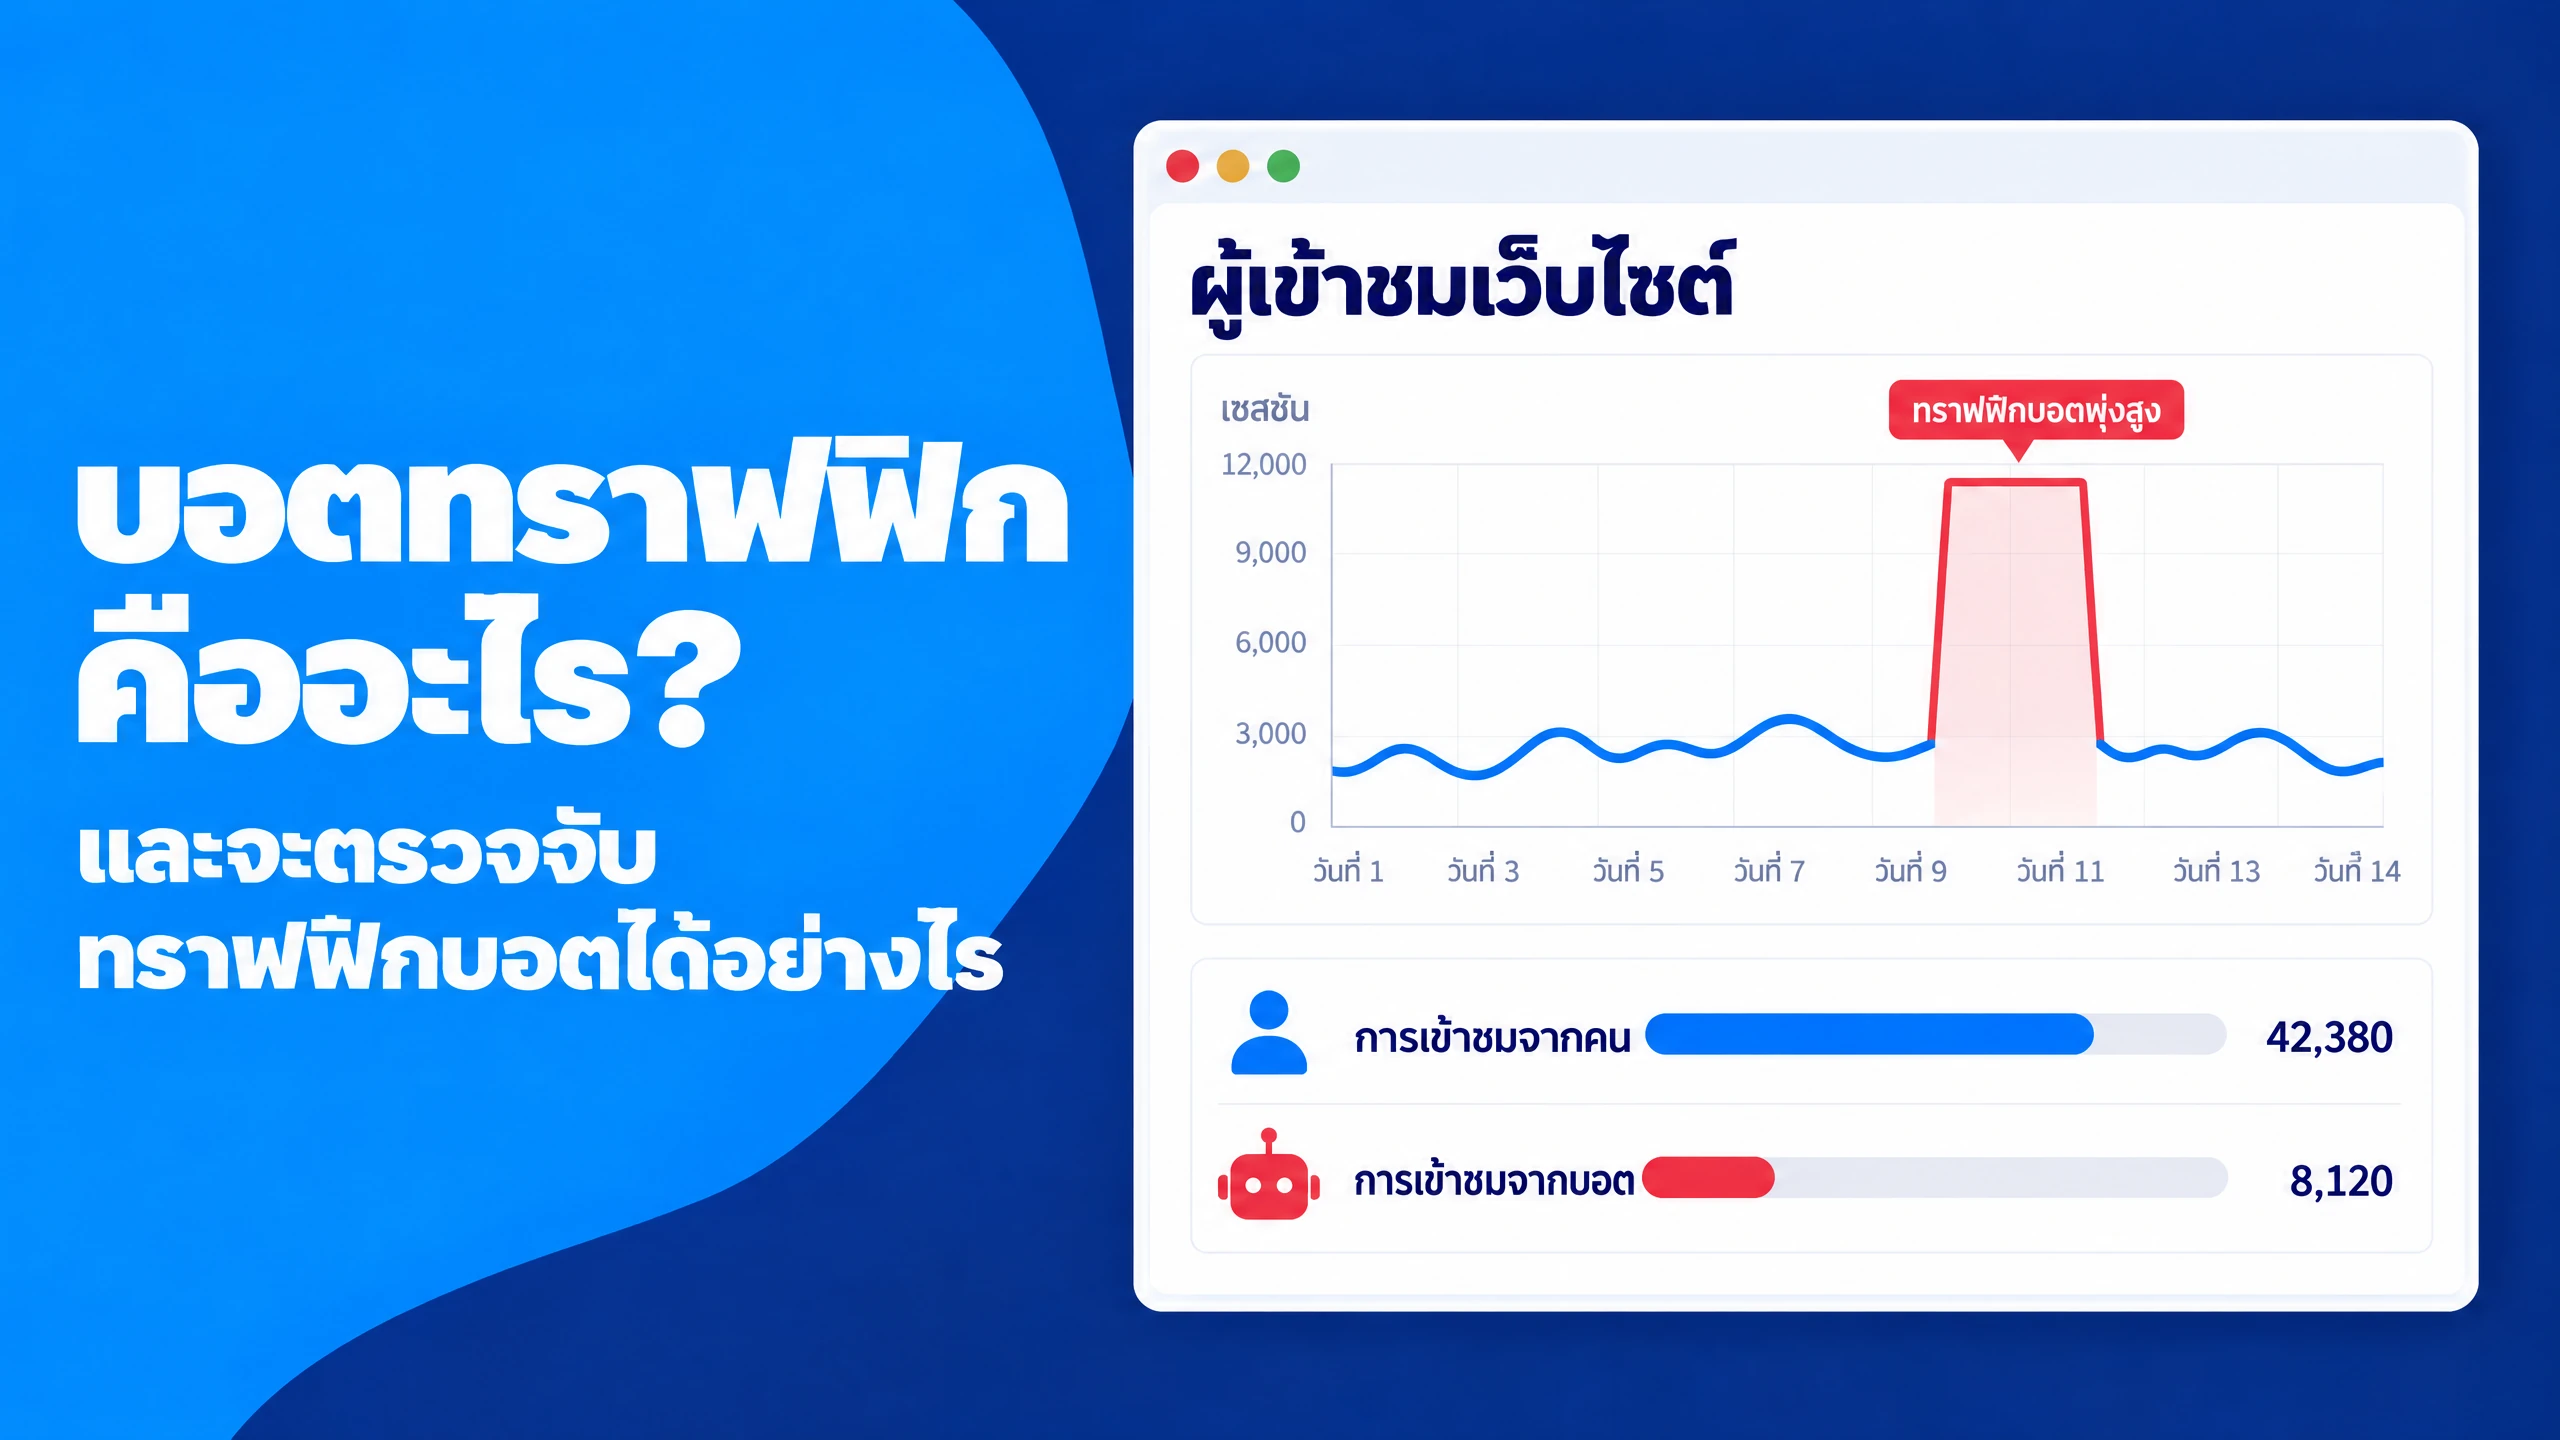
ทราฟฟิกบนเว็บมากกว่าครึ่งหนึ่งเกิดจากบอต ตามข้อมูลในบทความภาพรวมเกี่ยวกับบอตอินเทอร์เน็ตของ Wikipedia ระบบอัตโนมัติบางส่วนช่วยให้เว็บทำงานได้ตามปกติ บอตของเครื่องมือค้นหาเก็บข้อมูลหน้าเว็บเพื่อจัดทำดัชนี ส่วนระบบตรวจสอบสถานะเว็บไซต์ช่วยยืนยันว่าหน้าชำระเงินของคุณยังโหลดได้ตอนตี 3
แต่ทราฟฟิกอัตโนมัติในสัดส่วนที่เพิ่มขึ้นกลับทำอย่างอื่น นั่นคือเลียนแบบคนจริง ปั่นตัวเลข และผลาญงบโฆษณาที่ควรใช้กับลูกค้าจริง Juniper Research ประเมินว่าการฉ้อโกงโฆษณาทำให้ผู้ลงโฆษณาสูญเสีย $88 billion ในปี 2023 และการฉ้อโกงส่วนใหญ่นี้อาศัยการเข้าชมและคลิกแบบอัตโนมัติ
สำหรับนักการตลาดอย่างคุณ ความเสียหายที่ใหญ่กว่ามักมองไม่เห็น การตัดสินใจเรื่องงบประมาณ แผนคอนเทนต์ และ Landing Page อาจอิงกับการเข้าชมที่ไม่เคยเกิดจากคนจริงเลย
คู่มือนี้อธิบายว่าบอตปั่นทราฟฟิกคืออะไร ทำไมจึงมีทราฟฟิกจากบอต และคุณจะตรวจจับได้อย่างไรในข้อมูลวิเคราะห์และบันทึกเซิร์ฟเวอร์ เราจะเริ่มจากคำจำกัดความ ไปสู่ขั้นตอนตรวจจับที่นำไปใช้ได้จริง แล้วต่อด้วยแนวทางตรวจสอบเชิงลึก โดยมีหลักการเดียวตลอดทั้งบทความ: เครื่องมือค้นหาและระบบ AI อ่านหน้าเว็บของคุณ แต่กลุ่มเป้าหมายที่สำคัญคือคนจริงเสมอ
บอตปั่นทราฟฟิกคืออะไร?
คำว่า “บอตปั่นทราฟฟิก” มักถูกใช้ในความหมายกว้าง ๆ จนสร้างความสับสนตั้งแต่ยังไม่เริ่มวิเคราะห์ นักพัฒนาอาจใช้คำนี้หมายถึงสคริปต์ทดสอบโหลด ผู้ขายในตลาดฟรีแลนซ์อาจหมายถึงซอฟต์แวร์ที่สัญญาว่าจะส่ง “ผู้เข้าชม 10,000 คนต่อวัน” ส่วนทีมความปลอดภัยอาจหมายถึงทุกอย่างที่ไม่ใช่คน เมื่อคนสามคนในที่ประชุมใช้คำเดียวกันแต่หมายถึงคนละอย่าง ทีมจึงถกเถียงกันเรื่องคำเรียกแทนที่จะแก้ปัญหา
ในคู่มือนี้ บอตปั่นทราฟฟิกหมายถึงโปรแกรมซอฟต์แวร์ที่ส่งการเข้าชมแบบอัตโนมัติไปยังเว็บไซต์ แอป หรือโฆษณา เพื่อให้กิจกรรมนั้นดูเหมือนมาจากคนจริง โดยมักมีจุดประสงค์เพื่อปั่นตัวชี้วัด เช่น ยอดดูหน้าเว็บ การแสดงผลโฆษณา คลิก ยอดดูวิดีโอ หรือผู้ติดตาม บอตปั่นทราฟฟิกเป็นบอตอินเทอร์เน็ตประเภทหนึ่ง ซึ่งเป็นแอปพลิเคชันซอฟต์แวร์ที่ทำงานอัตโนมัติผ่านอินเทอร์เน็ต
บอตปั่นทราฟฟิกกับทราฟฟิกจากบอต
ทราฟฟิกจากบอตเป็นหมวดหมู่ที่กว้างกว่า ครอบคลุมการเข้าชมหรือคำขอทุกรายการที่โปรแกรมสร้างขึ้นแทนคน ไม่ว่าจะมีเจตนาอะไร เมื่อ Googlebot เก็บข้อมูลบล็อกของคุณ นั่นคือทราฟฟิกจากบอต แต่ไม่มีใครเรียก Googlebot ว่าบอตปั่นทราฟฟิก เพราะมันระบุตัวตน ปฏิบัติตามกฎการเก็บข้อมูลของคุณ และไม่ได้แสร้งเป็นผู้ซื้อ
ความแตกต่างนี้เป็นตัวกำหนดวิธีรับมือ ทราฟฟิกจากบอตเก็บข้อมูลที่ระบุตัวตนต้องได้รับการจัดการ โดยคุณตัดสินใจว่าจะให้เข้าถึงอะไรได้บ้าง ส่วนการเข้าชมจากบอตปั่นทราฟฟิกต้องได้รับการตรวจจับและคัดออก เพราะจุดประสงค์ของมันคือการแฝงตัวไปกับผู้เข้าชมที่เป็นคนจริง
บอตที่ดี บอตที่ไม่ดี และพื้นที่สีเทา
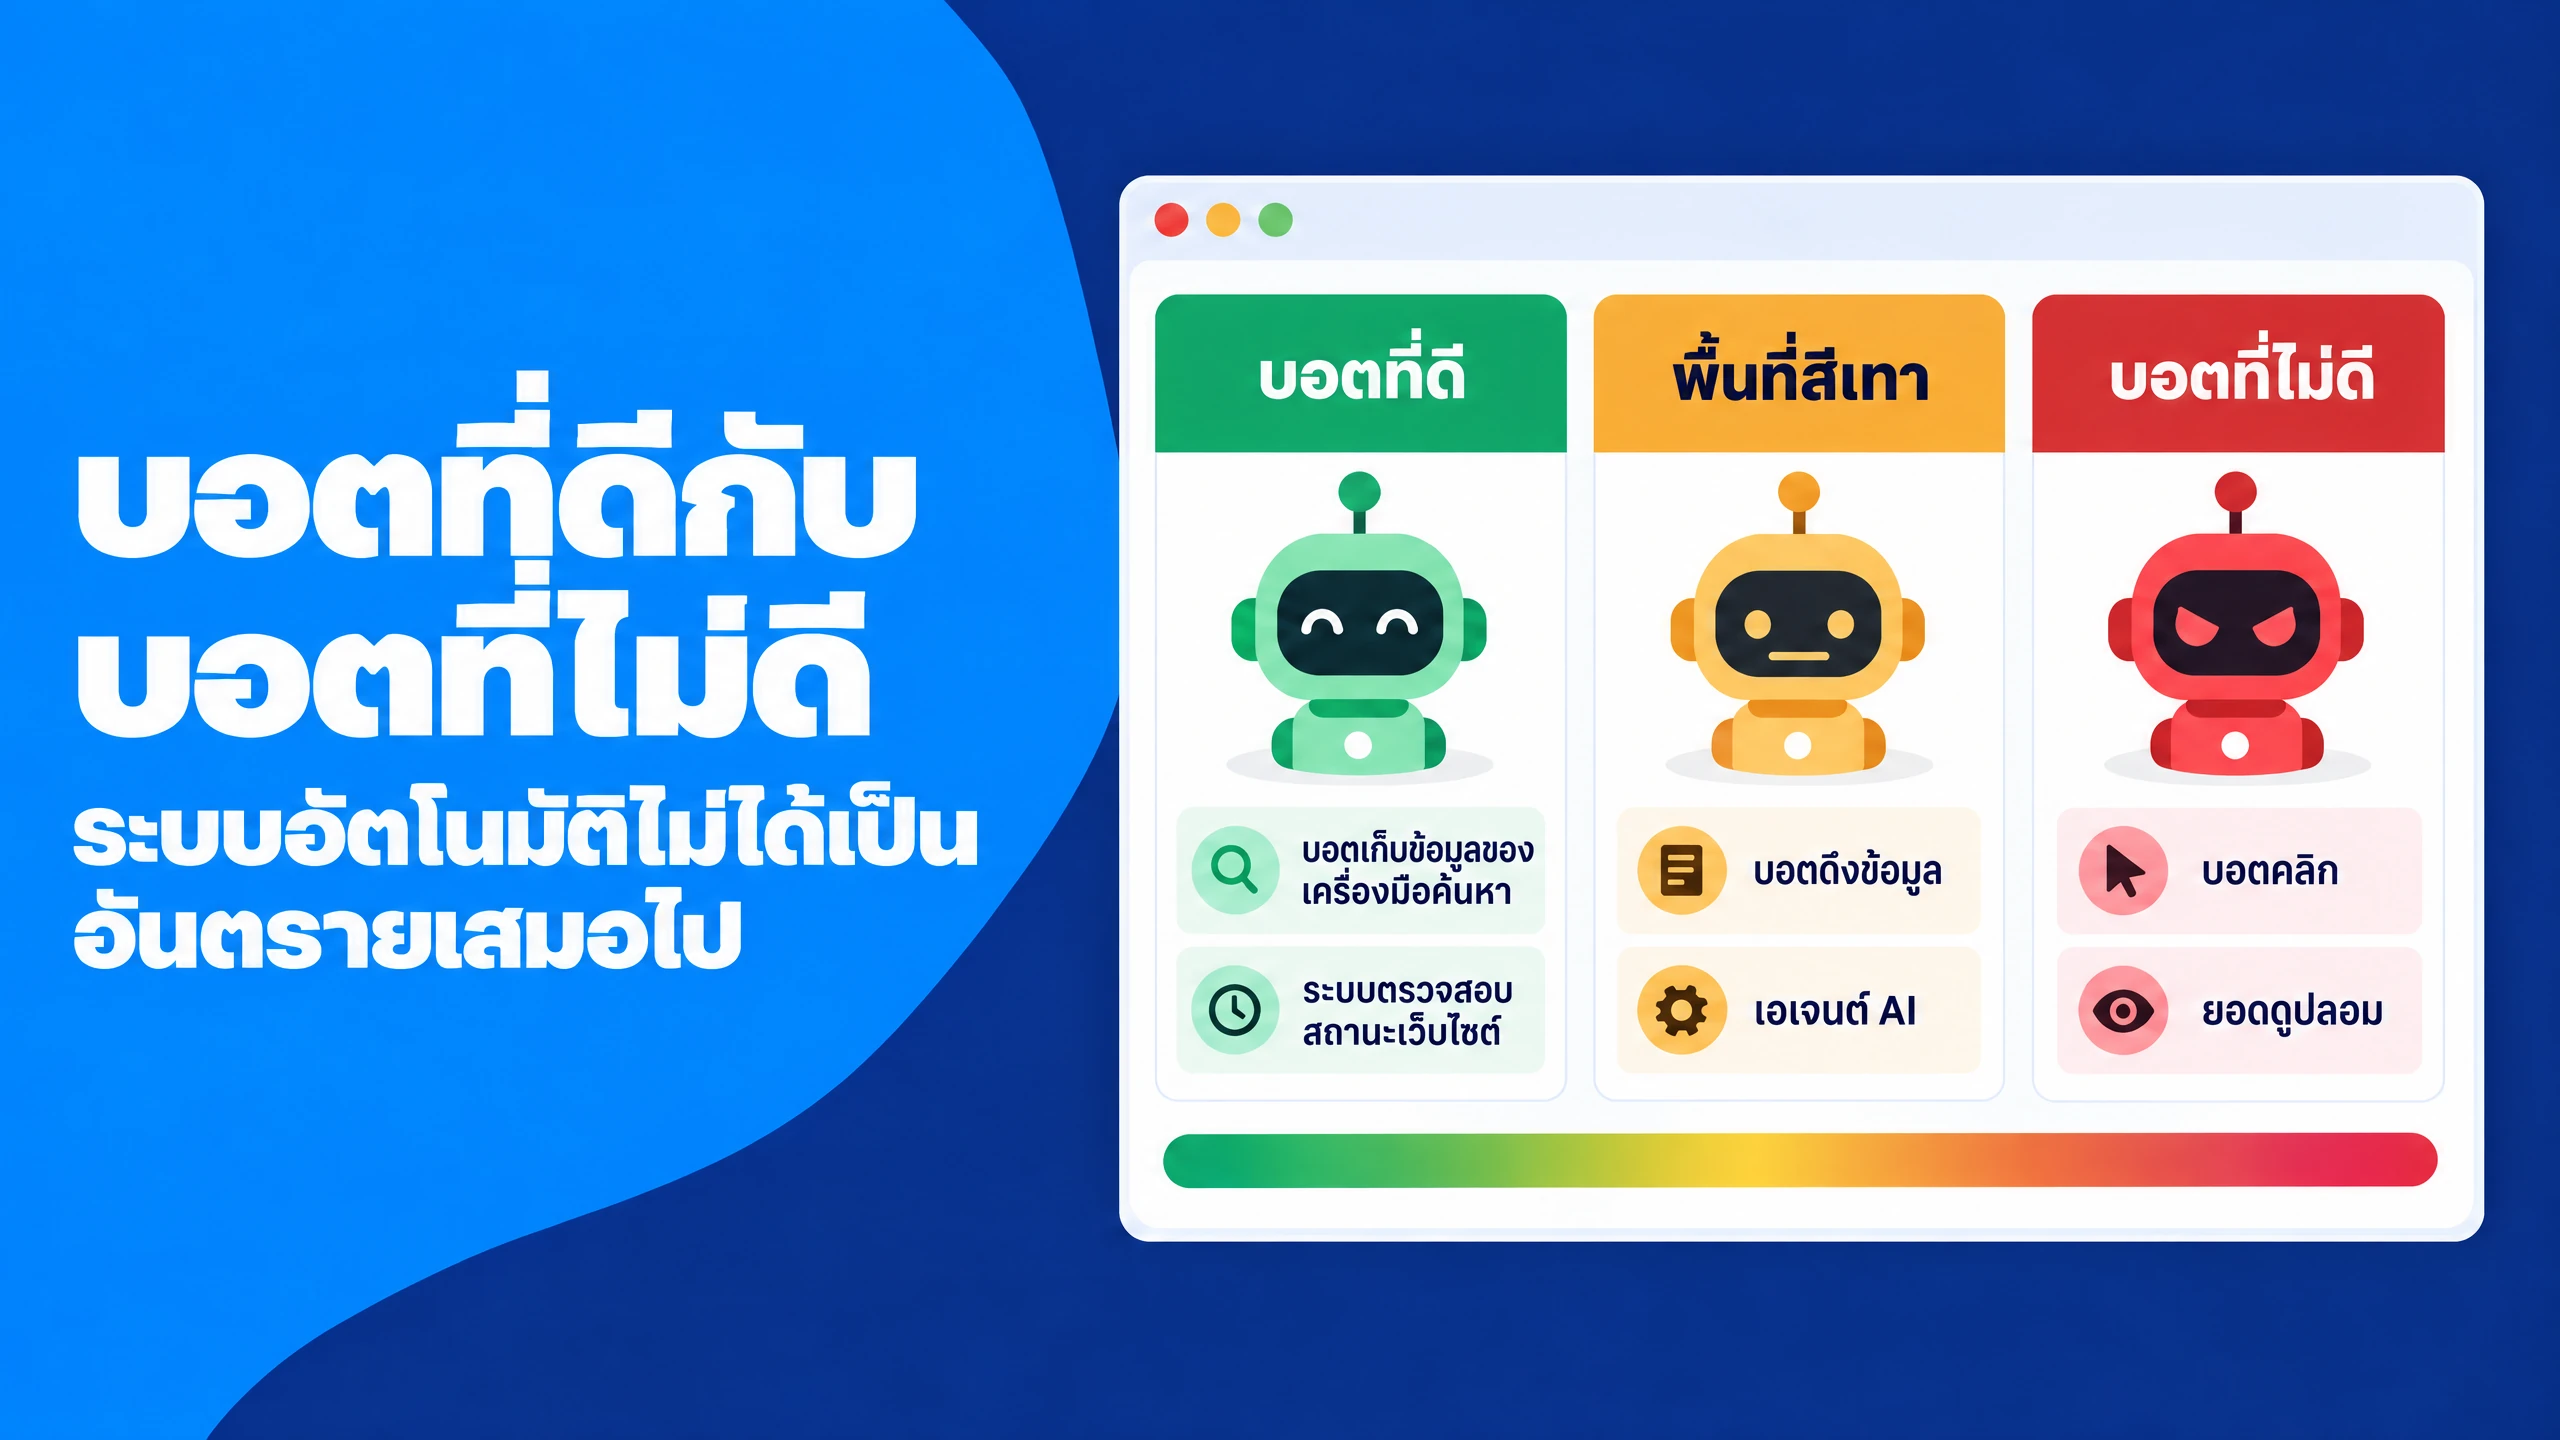
อุตสาหกรรมโฆษณามีคำศัพท์ที่ช่วยอธิบายเรื่องนี้ได้ชัดเจน Media Rating Council (MRC) ซึ่งเป็นหน่วยงานสหรัฐฯ ที่รับรองการวัดผลโฆษณา แบ่งทราฟฟิกที่ไม่ถูกต้องเป็นสองกลุ่มในมาตรฐานทราฟฟิกที่ไม่ถูกต้อง:
- ทราฟฟิกที่ไม่ถูกต้องทั่วไป (GIVT): บอตเก็บข้อมูลที่รู้จัก ทราฟฟิกจากศูนย์ข้อมูล และระบบอัตโนมัติอื่น ๆ ที่ตัวกรองตามรายการสามารถตรวจจับได้
- ทราฟฟิกที่ไม่ถูกต้องแบบซับซ้อน (SIVT): บอตที่เลียนแบบพฤติกรรมมนุษย์ อุปกรณ์ที่ถูกยึดควบคุม มัลแวร์ และกิจกรรมที่มีสิ่งจูงใจตอบแทน ซึ่งต้องวิเคราะห์เชิงลึกจึงจะระบุได้
ระหว่างบอตที่ดีอย่างชัดเจนกับบอตที่ไม่ดีอย่างชัดเจนยังมีพื้นที่สีเทา บอตดึงข้อมูลเพื่อติดตามราคา บอตเก็บข้อมูลของเครื่องมือ SEO บอตเก็บข้อมูลเพื่อฝึก AI และ AI agents ที่ท่องเว็บแทนคน ล้วนเป็นระบบอัตโนมัติ การจะยอมรับระบบเหล่านี้หรือไม่ขึ้นอยู่กับโมเดลธุรกิจของคุณ ไม่ใช่กฎตายตัวที่ใช้ได้กับทุกคน
ประเภทบอตปั่นทราฟฟิกที่พบบ่อย
บอตปั่นทราฟฟิกแบ่งได้เป็นกลุ่มที่มีลักษณะเฉพาะ การรู้จักแต่ละกลุ่มช่วยให้คุณคาดเดาได้ว่ากำลังเจอบอตประเภทใดจากรูปแบบที่มันทิ้งไว้:
- บอตคลิกคลิกโฆษณาหรือผลการค้นหาเพื่อผลาญงบของคู่แข่งหรือสร้างการมีส่วนร่วมปลอม พฤติกรรมนี้เรียกว่าการฉ้อโกงคลิก
- บอตปั่นการแสดงผลโหลดโฆษณาบนหน้าเว็บปลอมหรือหน้าเว็บที่อำพรางตัวตน ทำให้ผู้ลงโฆษณาต้องจ่ายเงินสำหรับการแสดงผลที่ไม่มีใครเห็น
- โปรแกรม Autosurf และ แลกเปลี่ยนทราฟฟิกแบบอัตโนมัติหมุนเวียนหน้าเว็บระหว่างสมาชิก ทำให้ทุกเว็บไซต์บันทึก “การเข้าชม” ที่ไม่มีใครอ่าน
- บอตสแปมแหล่งอ้างอิงแทรก URL ลงในรายงานแหล่งอ้างอิงของคุณเพื่อล่อให้คุณเข้าไปเยี่ยมชม กลยุทธ์นี้เรียกว่าสแปมแหล่งอ้างอิง
- Headless browsers คือเบราว์เซอร์เต็มรูปแบบที่ไม่มีหน้าจอแสดงผล นักพัฒนาใช้เพื่อทดสอบระบบ ส่วนผู้ฉ้อโกงนำไปใช้ในทางที่ผิดเพื่อปั่นการแสดงผลโฆษณา
- ฟาร์มคลิกใช้คนที่ได้รับค่าจ้างต่ำแทนโค้ด ในทางเทคนิคผู้เข้าชมเป็นมนุษย์ แต่เจตนาเป็นการสร้างกิจกรรมปลอม มาตรฐานการวัดผลจึงถือว่ากิจกรรมนั้นไม่ถูกต้อง
ขั้นตอนที่นำไปใช้ได้จริง: จุดเริ่มต้นที่มีประโยชน์คือการทำรายการระบบอัตโนมัติที่คุณอนุญาตให้เข้าถึงไว้ในหนึ่งหน้า ระบุบอตเก็บข้อมูลของเครื่องมือค้นหา ระบบตรวจสอบสถานะเว็บไซต์ บอตเก็บข้อมูล SEO, webhook การชำระเงิน และผู้ช่วย AI ที่คุณต้องการให้อ้างอิงเนื้อหาของคุณ พร้อม user agent ที่แต่ละระบบระบุ วิธีนี้ได้ผลเพราะการแจ้งเตือนผิดพลาดจำนวนมากเกิดจากเครื่องมือของคุณเอง เช่น การเก็บข้อมูล SEO ที่ตั้งเวลาไว้ตอนตี 3 จะดูเหมือนทราฟฟิกพุ่งสูงผิดปกติในตอนกลางคืนทุกประการ จนกว่าคุณจะตรวจสอบรายการนี้
ทำไมผู้เข้าชมจริงจึงทิ้งร่องรอยที่จำแนกได้
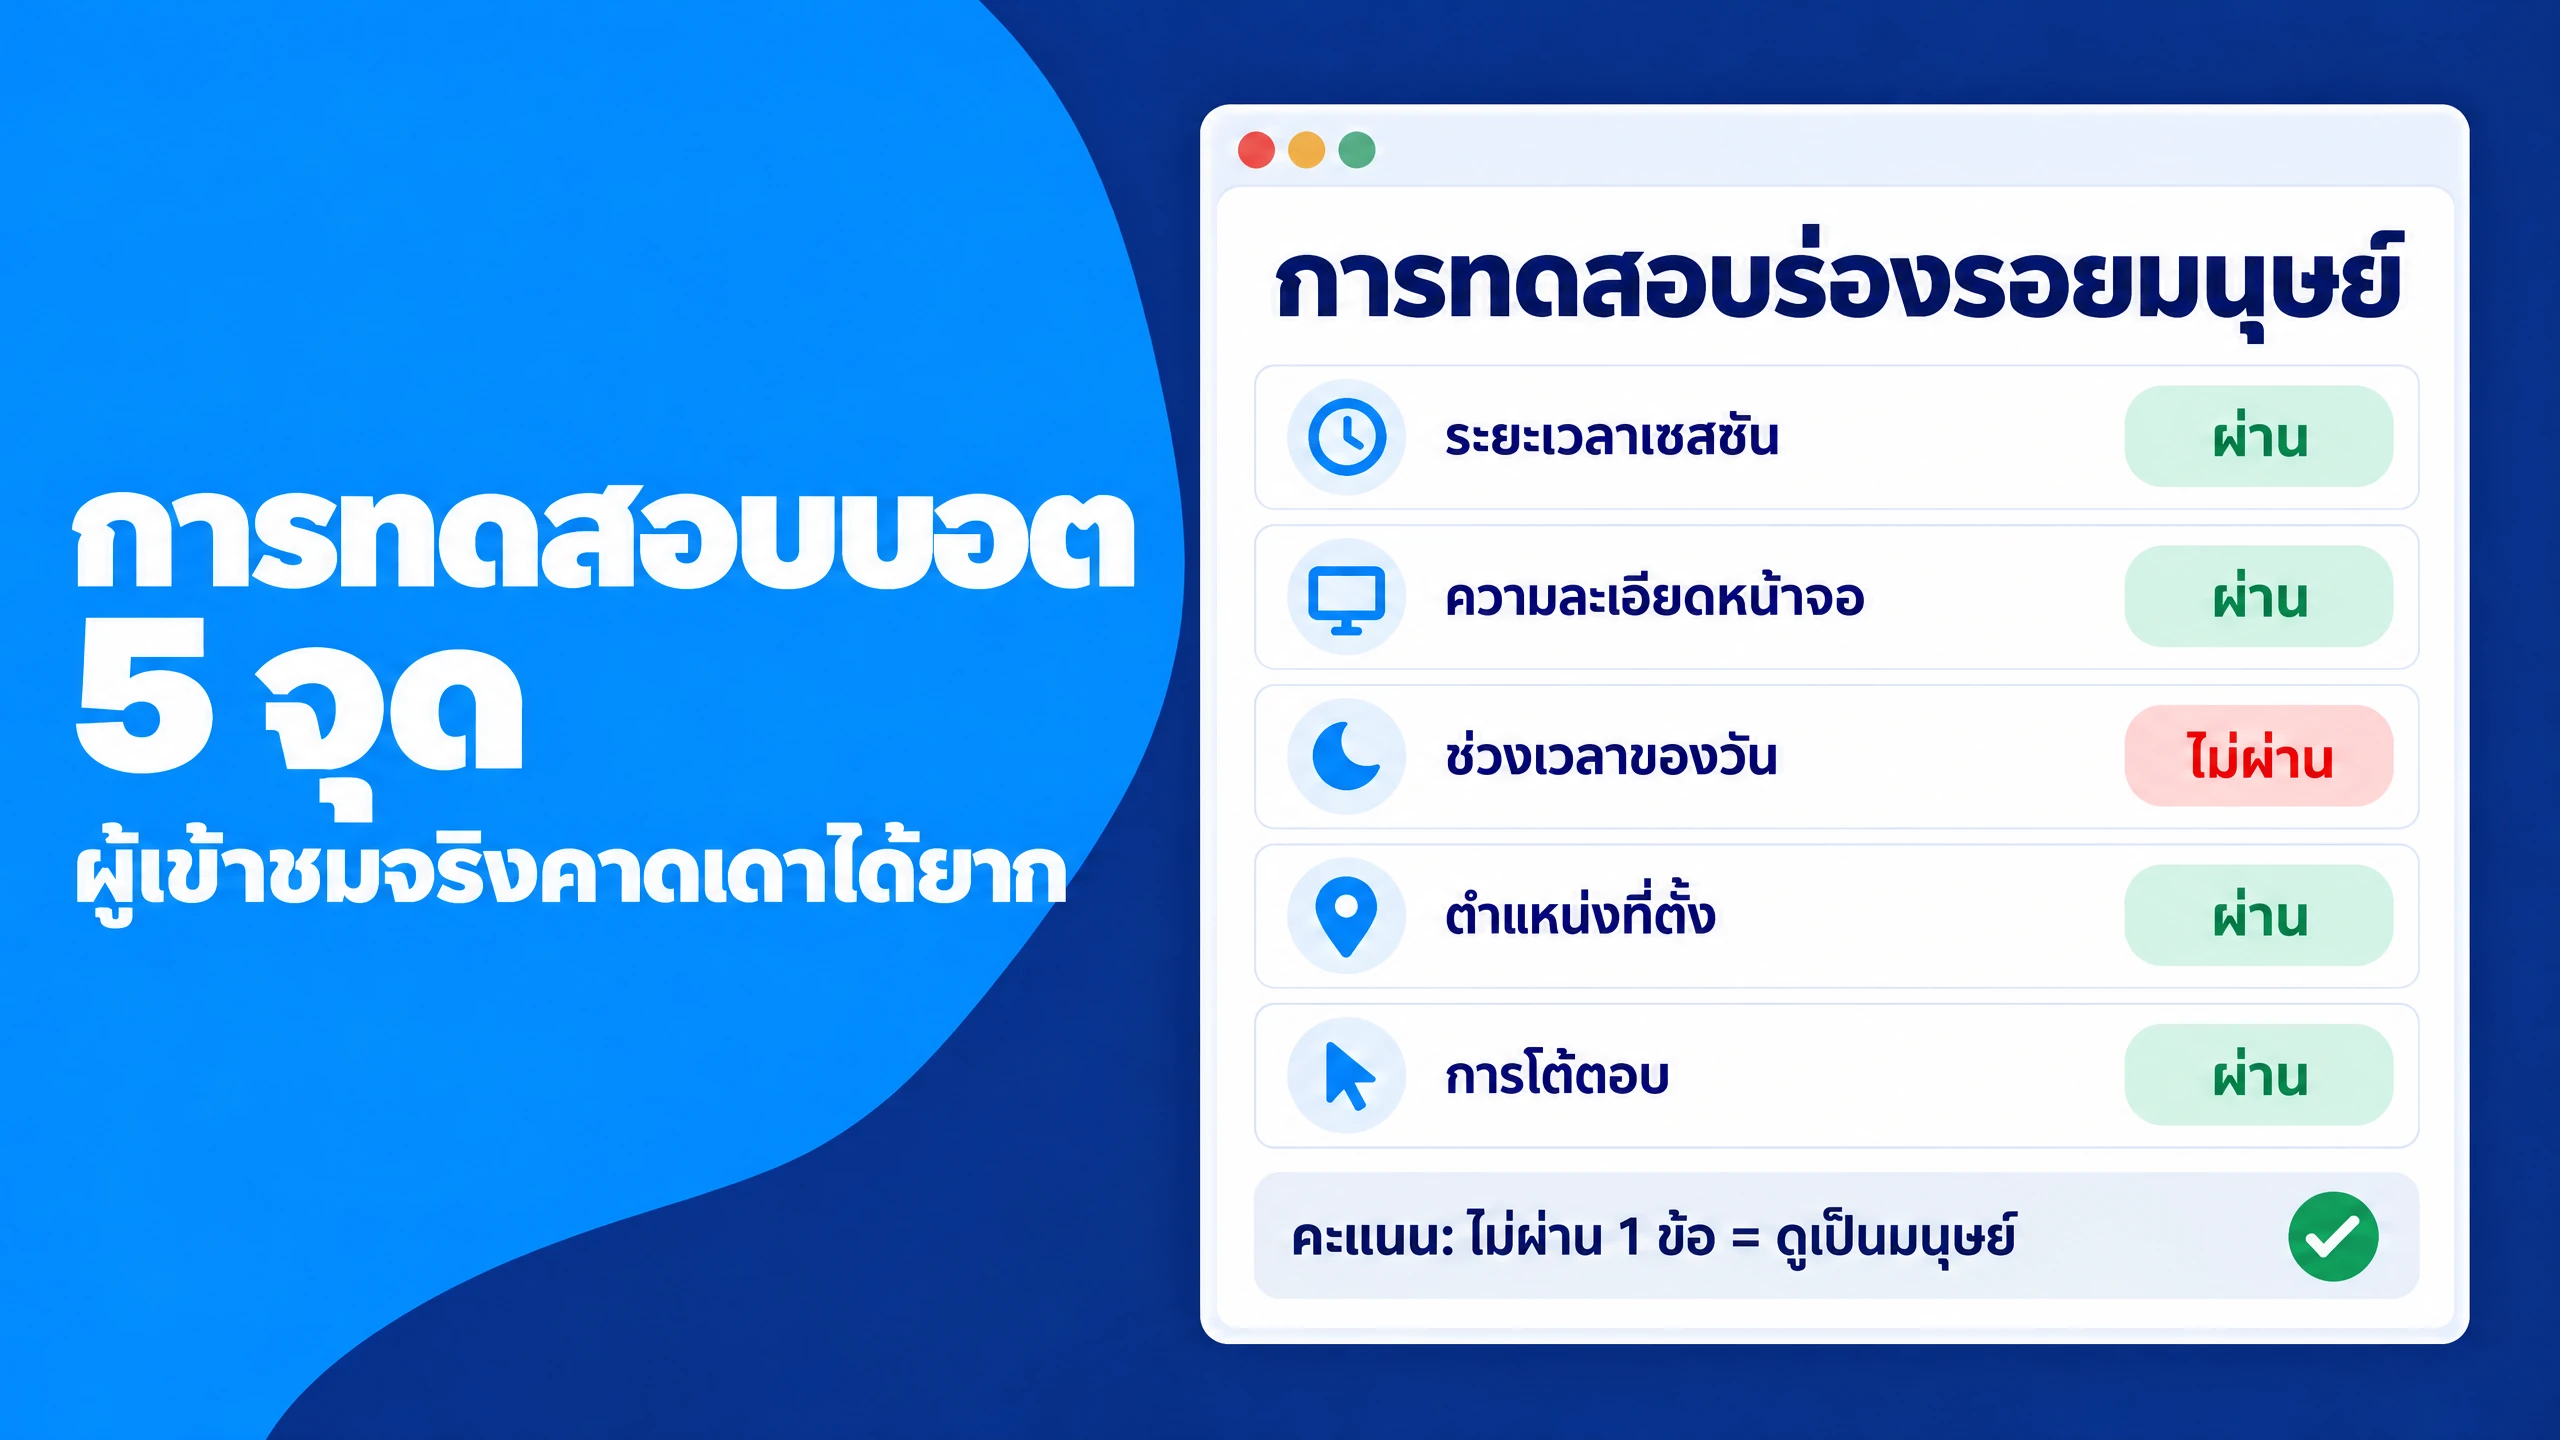
คำแนะนำส่วนใหญ่เกี่ยวกับทราฟฟิกจากบอตเริ่มจากสิ่งที่ดูผิดปกติ แต่จุดเริ่มต้นที่เชื่อถือได้กว่าคือการรู้ว่าทราฟฟิกปกติเป็นอย่างไร เพราะคุณไม่สามารถตัดสินความผิดปกติได้หากไม่มีข้อมูลพื้นฐานสำหรับเปรียบเทียบ
ผู้เข้าชมที่เป็นมนุษย์มีพฤติกรรมหลากหลายอย่างน่าทึ่ง คนหนึ่งอ่านหน้าราคาบนมือถือระหว่างเดินทางเป็นเวลา 40 วินาที อีกคนเปิดแท็บบนคอมพิวเตอร์ทิ้งไว้ 12 นาที ส่วนคนที่สามออกจากเว็บหลังผ่านไปสองวินาทีเพราะแตะผลการค้นหาผิด
ความไม่เป็นระเบียบนี้คือสัญญาณที่ทรงพลังที่สุดที่คุณมี การเข้าชมของคนจริงแต่ละครั้งมีความแตกต่างเล็ก ๆ หลายสิบอย่าง ทั้งขนาดหน้าจอ เวอร์ชันเบราว์เซอร์ เขตเวลา ความเร็วในการเลื่อนหน้า และจังหวะหยุดก่อนคลิก ทราฟฟิกอัตโนมัติเลียนแบบความหลากหลายทั้งหมดนี้ในวงกว้างได้ยาก เพราะความแตกต่างใหม่แต่ละอย่างต้องใช้เวลาในการพัฒนาและโครงสร้างพื้นฐานของผู้ควบคุมบอต เครือข่ายบอตอาจปลอมหนึ่งหรือสองด้านได้อย่างแนบเนียน แต่การปลอมทุกด้านพร้อมกันในหลายพันเซสชันมีต้นทุนสูง
SparkTraffic แพลตฟอร์มโฆษณาที่ส่งผู้เข้าชมเว็บไซต์ตามพื้นที่เป้าหมายผ่านโฆษณาบนเว็บไซต์ผู้เผยแพร่ที่เป็นพาร์ทเนอร์มาตั้งแต่ปี 2015 นำหลักความหลากหลายนี้มาใช้ในแบบทดสอบ 5 ข้อที่เผยแพร่ให้ผู้ลงโฆษณาของตน เหตุผลนั้นเรียบง่าย: ใครก็ตามที่จ่ายเงินเพื่อให้ได้การเข้าชมควรตรวจสอบได้ด้วยเครื่องมือวิเคราะห์มาตรฐาน โดยไม่ต้องใช้เครื่องมือพิเศษ ว่าการเข้าชมเหล่านั้นมีพฤติกรรมเหมือนคนจริง การตรวจสอบเดียวกันนี้ใช้ได้กับทุกแหล่งที่มา ทั้งแบบเสียเงินและแบบออร์แกนิก จึงเหมาะเป็นเกณฑ์พื้นฐานทั่วไปสำหรับรายงานของคุณเอง
แบบทดสอบร่องรอยผู้เข้าชมจริง 5 ข้อ
การตรวจสอบแต่ละข้อเปรียบเทียบพฤติกรรมด้านหนึ่งกับความหลากหลายที่ควรพบในคนจริง เกณฑ์ถูกตั้งไว้อย่างผ่อนปรนโดยเจตนา เพื่อไม่ให้กลุ่มตัวอย่างขนาดเล็กและความผันผวนตามปกติทำให้เกิดการแจ้งเตือนผิดพลาด:
- ระยะเวลาเซสชัน: ทราฟฟิกปกติมีระยะเวลากระจายตั้งแต่น้อยกว่า 10 วินาทีไปจนถึงมากกว่าสองนาที สัญญาณเตือนคือเซสชันมากกว่าครึ่งกระจุกอยู่ในช่วงเวลาเดียวกันที่กว้างเพียงห้าวินาที
- ความละเอียดหน้าจอ: ทราฟฟิกปกติมีความละเอียดหน้าจอหลายแบบ สัญญาณเตือนคือความละเอียดแบบเดียวคิดเป็นมากกว่าครึ่งหนึ่งของเซสชัน
- ช่วงเวลาของวัน: ทราฟฟิกปกติสอดคล้องกับรูปแบบกิจกรรมช่วงกลางวันในพื้นที่ สัญญาณเตือนคือทราฟฟิกช่วง 01:00 ถึง 05:00 น. ตามเวลาท้องถิ่นมีระดับเท่ากับช่วงกลางวัน
- ตำแหน่งที่ตั้ง: ทราฟฟิกที่กำหนดเป้าหมายได้ตามปกติมีการเข้าชมมากกว่า 90% มาจากพื้นที่เป้าหมาย สัญญาณเตือนคือมากกว่า 10% มาจากพื้นที่ที่คุณไม่ได้กำหนดเป้าหมาย
- ปฏิสัมพันธ์: ทราฟฟิกปกติมีการเลื่อนหน้า คลิก หรือเริ่มกรอกแบบฟอร์มบ้าง สัญญาณเตือนคือไม่มีปฏิสัมพันธ์เลยใน 300 เซสชัน
หากไม่ผ่านการตรวจสอบศูนย์หรือหนึ่งข้อ แสดงว่าทราฟฟิกมีพฤติกรรมคล้ายคนจริง หากไม่ผ่านตั้งแต่สองข้อขึ้นไป ควรหยุดรับทราฟฟิกจากแหล่งนั้นชั่วคราว ส่งออกข้อมูลประมาณ 20 เซสชันเป็นหลักฐาน และขอให้ผู้ให้บริการตรวจสอบ วิธีให้คะแนนนี้ได้ผลเพราะตัวชี้วัดที่ผิดปกติเพียงตัวเดียวมักมีสาเหตุที่ไม่ได้เป็นปัญหา เช่น แคมเปญเฉพาะมือถือที่ทำให้ขนาดหน้าจอมีความหลากหลายน้อยลง แต่การไม่ผ่านหลายข้อพร้อมกันแทบไม่เกิดจากสาเหตุเช่นนั้น
สร้างเกณฑ์พื้นฐานของผู้เข้าชมจริงสำหรับเว็บคุณ
เกณฑ์ทั่วไปเป็นเพียงจุดเริ่มต้น ไม่ใช่ข้อสรุป บล็อกสูตรอาหาร เว็บไซต์เอกสาร SaaS และเว็บไซต์ทันตแพทย์ในพื้นที่ ต่างมีระยะเวลาเซสชันและรูปแบบกิจกรรมรายวันที่แตกต่างกัน เซสชันเฉลี่ยห้านาทีอาจน่าสงสัยบนหน้าค้นหาสาขา แต่เป็นเรื่องปกติอย่างยิ่งสำหรับบทสอนแบบยาว
ขั้นตอนที่นำไปใช้ได้จริง: เกณฑ์เปรียบเทียบที่น่าเชื่อถือที่สุดคือช่องทางหนึ่งที่คุณไว้วางใจอยู่แล้ว เช่น คลิกจากจดหมายข่าวหรือลูกค้าที่เข้าสู่ระบบ การบันทึกการกระจายตัวของข้อมูลทั้งห้าด้านข้างต้นเป็นเวลา 30 วันจะช่วยสร้างเกณฑ์พื้นฐาน จากนั้นคุณสามารถนำแหล่งทราฟฟิกใหม่ที่ดูผิดปกติมาเทียบกับเกณฑ์นี้แทนค่าเฉลี่ยอุตสาหกรรม วิธีนี้ได้ผลเพราะช่องทางที่คุณไว้วางใจสะท้อนกลุ่มเป้าหมาย อุปกรณ์ และเขตเวลาของคุณอยู่แล้ว ความแตกต่างอย่างมากจึงชี้ไปที่แหล่งทราฟฟิกมากกว่าตัวเว็บไซต์
ทำไมจึงมีบอตปั่นทราฟฟิก และคุณเสียอะไรบ้าง
บอตปั่นทราฟฟิกมีอยู่เพราะมีคนได้กำไรจากกิจกรรมปลอม กำไรอาจมาจากทางตรง เช่น การฉ้อโกงโฆษณา หรือทางอ้อม เช่น ผู้ให้บริการที่ขาย “ทราฟฟิก” เพื่อให้แดชบอร์ดดูคึกคัก การเข้าใจแรงจูงใจช่วยให้คุณคาดการณ์รูปแบบได้: ผู้ฉ้อโกงต้องการการแสดงผลและคลิก ผู้ขายตัวเลขที่ดูดีต้องการยอดดูหน้าเว็บ ส่วนผู้ส่งสแปมต้องการความสนใจจากคุณ
การฉ้อโกงโฆษณาขนาดใหญ่
ตัวอย่างที่มีหลักฐานชัดเจนที่สุดคือ Methbot ตามข้อมูลจากกระทรวงยุติธรรมสหรัฐฯ ปฏิบัติการนี้ใช้เซิร์ฟเวอร์มากกว่า 1,900 เครื่อง และที่อยู่ IP มากกว่า 650,000 รายการ เพื่อโหลดโฆษณาบนเว็บไซต์ปลอมแปลงมากกว่า 5,000 แห่ง และทำเงินไปมากกว่า $7 million ส่วนแผนการที่เกี่ยวข้องอย่าง 3ve ใช้คอมพิวเตอร์ที่ติดมัลแวร์ประมาณ 1.7 ล้านเครื่อง และทำเงินไปมากกว่า $29 million
บอตเหล่านี้ถูกสร้างให้ดูเหมือนคนจริง ประกาศการพิพากษาลงโทษของ DOJ อธิบายถึงบอตที่ปลอมการเคลื่อนไหวเมาส์ การเลื่อนหน้า และการเข้าสู่ระบบโซเชียลเน็ตเวิร์ก โดยผู้ควบคุมหลักได้รับโทษจำคุก 10 ปี บทเรียนสำหรับนักการตลาดคือ “การมีส่วนร่วมที่ดูสมจริง” เพียงอย่างเดียวพิสูจน์อะไรไม่ได้ เพราะ Methbot ถูกออกแบบมาเพื่อสร้างสิ่งนั้นโดยเฉพาะ
ความนิยมปลอมและตัวชี้วัดที่ดูดีแต่ไร้คุณค่า
แรงจูงใจที่สองคือการสร้างภาพว่ามีความนิยม ผู้ให้บริการบางรายขายซอฟต์แวร์บอตปั่นทราฟฟิกหรือ “แพ็กเกจผู้เข้าชม” ที่เพิ่มยอดดูหน้าเว็บ ยอดดูวิดีโอ หรือจำนวนผู้ติดตามให้สูงเกินจริง ในยุคแรกของเว็บ ตัวนับจำนวนการเข้าชมดิบ ๆ ทำให้คนประทับใจ และตัวเลขที่ปั่นขึ้นให้ผลตอบแทนในระยะสั้น แต่ปัจจุบันเครื่องมือค้นหา ผู้ลงโฆษณา และนักลงทุนพิจารณาการมีส่วนร่วม คอนเวอร์ชัน และรายได้ ปริมาณปลอมจึงไม่ได้ช่วยอะไร และยังทำให้ข้อมูลที่คุณต้องใช้ปนเปื้อน
ปัจจุบันหน่วยงานกำกับดูแลถือว่าความนิยมปลอมเป็นการหลอกลวง ในเดือนสิงหาคม 2024 คณะกรรมาธิการการค้าแห่งสหรัฐฯ ได้ออกกฎฉบับสมบูรณ์ที่ห้ามขายหรือซื้อตัวชี้วัดอิทธิพลบนโซเชียลมีเดียปลอม เช่น ผู้ติดตามหรือยอดดูที่สร้างโดยบอต ข้อห้ามนี้ใช้ในกรณีที่ผู้ซื้อรู้หรือควรรู้ว่าตัวชี้วัดนั้นเป็นของปลอม และนำไปใช้เพื่อวัตถุประสงค์ทางการค้า นโยบายโฆษณาของ Google ยังห้ามโปรโมตบริการที่ขายกิจกรรมผู้ใช้ปลอม เช่น คลิกที่ไม่ถูกต้องด้วย
สแปมแหล่งอ้างอิงและทราฟฟิกผี
แรงจูงใจที่สามคือความสนใจ บอตสแปมแหล่งอ้างอิงเข้าเว็บไซต์ของคุณ หรือส่งข้อมูลตรงไปยังพร็อพเพอร์ตีในระบบวิเคราะห์ของคุณ พร้อม URL อ้างอิงปลอม เมื่อคุณเห็นโดเมนที่ไม่คุ้นเคยในรายงานแหล่งอ้างอิง ความอยากรู้ก็ทำให้คุณเข้าไปดู และผู้ส่งสแปมก็ได้การเข้าชมหรือยอดขาย บทความเรื่องสแปมแหล่งอ้างอิงของ Wikipedia อธิบายว่ากลยุทธ์นี้ย้ายจากบันทึกเซิร์ฟเวอร์เข้าสู่เครื่องมือวิเคราะห์ได้อย่างไร
ความเสียหายที่แท้จริง: การตัดสินใจบนข้อมูลปลอม
ต้นทุนโดยตรงของทราฟฟิกจากบอตคือค่าโฆษณาที่สูญเปล่าและภาระของเซิร์ฟเวอร์ ส่วนต้นทุนทางอ้อมมักสูงกว่า ลองนึกถึงการทดสอบ A/B ที่เวอร์ชัน B ได้รับเซสชันจากบอตเพิ่ม 600 เซสชันโดยไม่มีคอนเวอร์ชันเลย อัตราคอนเวอร์ชันของ B ลดลง คุณจึงเก็บหน้าเว็บที่ด้อยกว่าไว้ และไม่มีใครรู้เลยว่าทำไม หรือทีมคอนเทนต์ที่ทุ่มเทกับหัวข้อหนึ่งมากขึ้นเป็นสองเท่า เพราะบอตดึงข้อมูลเข้ามาเก็บบทความเหล่านั้นทุกชั่วโมง
ขั้นตอนที่นำไปใช้ได้จริง: การประเมินต้นทุนจากข้อมูลปนเปื้อนช่วยให้เห็นปัญหาอย่างเป็นรูปธรรม โดยนำสัดส่วนเซสชันที่ไม่ผ่านการตรวจสอบอย่างน้อย 2 ใน 5 ข้อ มาคูณกับค่าใช้จ่ายสื่อโฆษณาในไตรมาสนั้น จากนั้นแจกแจงทุกการตัดสินใจที่อาศัยรายงานเหล่านั้น เช่น การโยกงบประมาณ การเลือกตัวทดสอบที่ชนะ และการจัดลำดับความสำคัญของคอนเทนต์ วิธีนี้ได้ผลเพราะเปลี่ยนปัญหาคุณภาพข้อมูลที่ดูเป็นนามธรรมให้กลายเป็นตัวเลขงบประมาณ ทำให้ขออนุมัติเวลาและเครื่องมือได้ง่ายขึ้นมาก
วิธีตรวจจับทราฟฟิกบอตใน Google Analytics 4
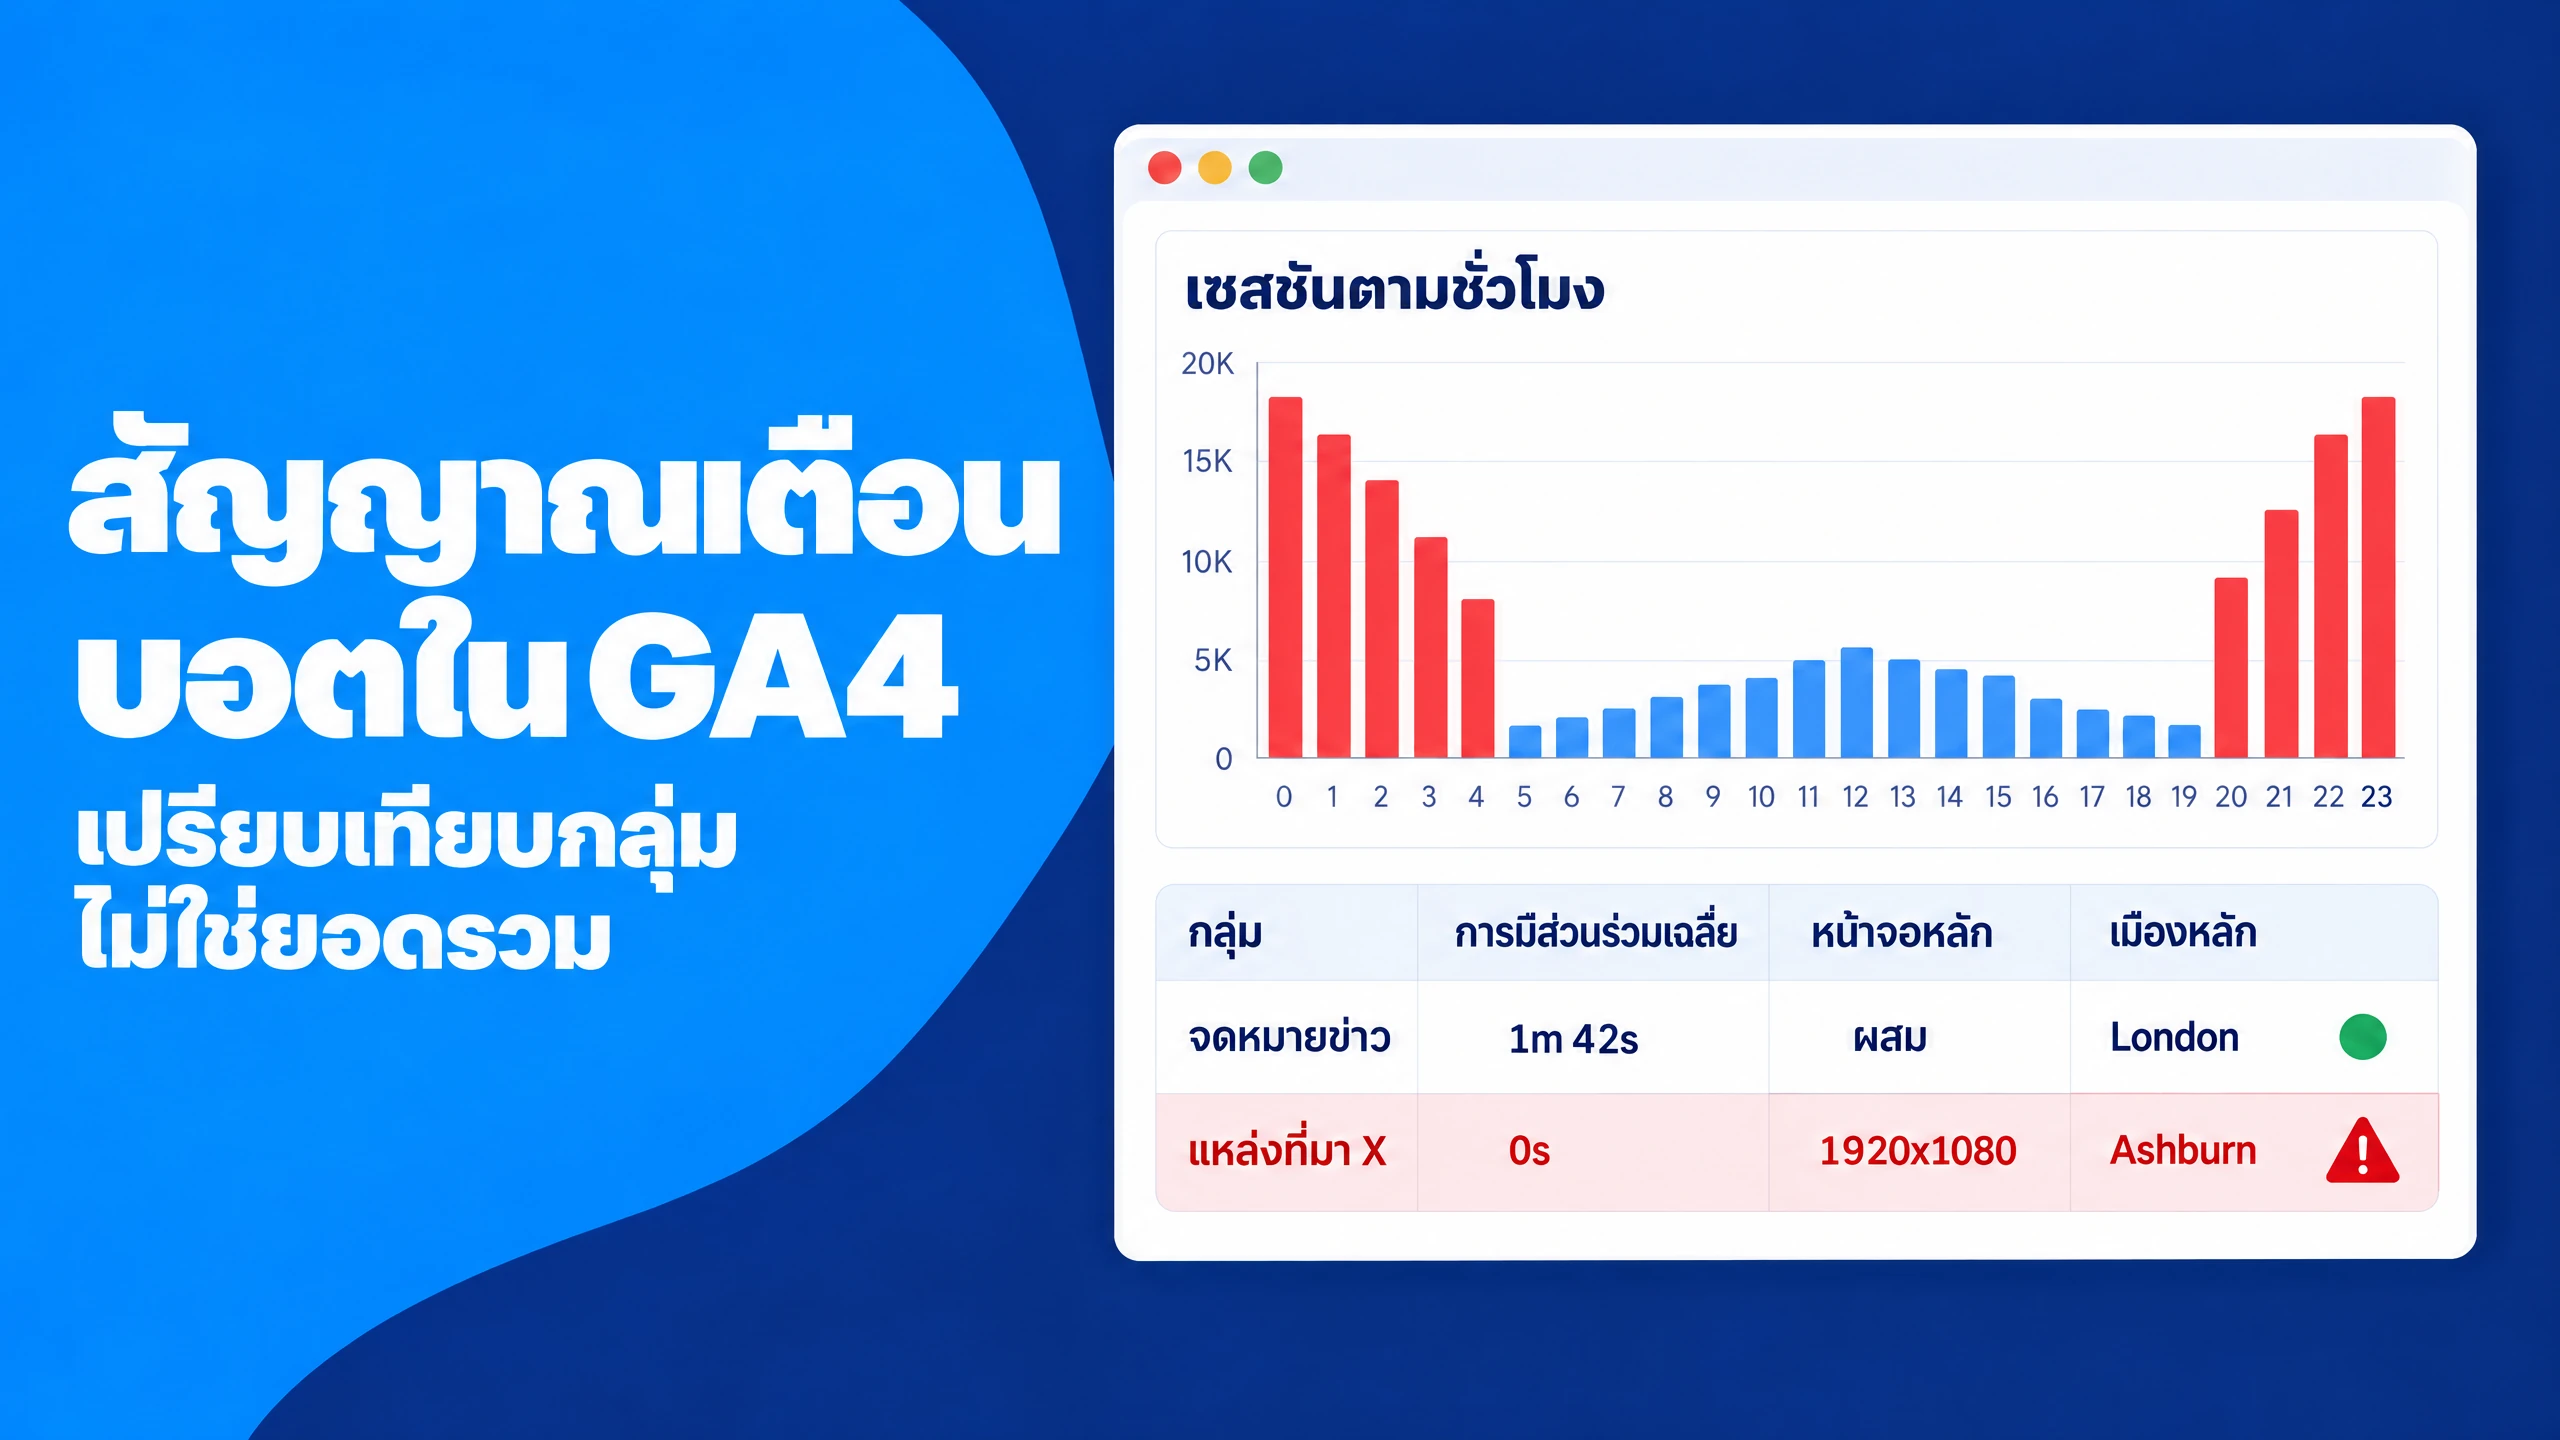
Google Analytics 4 (GA4) กรองบอตที่รู้จักออกโดยอัตโนมัติอยู่แล้ว โดยอาศัยงานวิจัยของ Google เองและ IAB/ABC International Spiders and Bots List คุณไม่สามารถปิดฟังก์ชันนี้ได้ และไม่สามารถดูได้ว่าระบบกรองทราฟฟิกออกไปเท่าไร แม้จะฟังดูน่าอุ่นใจ แต่ก็หมายความว่าบอตที่ยังอยู่ในรายงานของคุณคือบอตที่ไม่อยู่ในรายชื่อใด ๆ การตรวจจับทราฟฟิกบอตนอกเหนือจากรายชื่อนั้นจึงเป็นหน้าที่ของคุณ
ข่าวดีคือบอตที่ยังไม่เป็นที่รู้จักก็ยังทิ้งรูปแบบให้สังเกตได้ มักเข้ามาเป็นระลอก ใช้อุปกรณ์เพียงไม่กี่แบบ ไม่เดินตามเส้นทางคอนเวอร์ชัน และกระจุกตัวในพื้นที่ที่ลูกค้าของคุณไม่ได้อาศัยอยู่ คุณระบุทราฟฟิกบอตได้ด้วยการเปรียบเทียบเซกเมนต์ ไม่ใช่จ้องดูยอดรวม
เริ่มจากรูปแบบของทราฟฟิกที่พุ่งขึ้น
ทราฟฟิกที่พุ่งขึ้นตามธรรมชาติมีทั้งสาเหตุและรูปแบบ จดหมายข่าว โพสต์โซเชียล หรือการกล่าวถึงในสื่อ ทำให้ทราฟฟิกเพิ่มขึ้นอย่างรวดเร็วแล้วค่อย ๆ ลดลงในช่วงหลายชั่วโมงหรือหลายวัน พร้อมกับคอนเวอร์ชันที่เพิ่มขึ้น ส่วนทราฟฟิกบอตที่พุ่งขึ้นมักมีรูปแบบต่างออกไป เช่น เพิ่มขึ้นแล้วทรงตัวเป็นแนวราบ เริ่มและหยุดตรงเวลาเต็มชั่วโมง และเซสชันเพิ่มขึ้นแต่เหตุการณ์สำคัญกลับไม่เพิ่มตาม
เมื่อทราฟฟิกพุ่งขึ้น คำถามแรกคือ “ตอนนั้นเกิดอะไรขึ้น?” หากไม่มีแคมเปญ การกล่าวถึง หรือเหตุการณ์ตามฤดูกาลที่อธิบายได้ ควรมองว่าทราฟฟิกส่วนนี้ยังไม่ได้รับการยืนยัน จนกว่าการเปรียบเทียบเซกเมนต์ด้านล่างจะชี้ให้เห็นเป็นอย่างอื่น
8 สัญญาณเตือนในรายงานของคุณ
ควรตรวจสอบรูปแบบเหล่านี้ทุกครั้งที่แหล่งที่มาหรือหน้า Landing Page ดูผิดปกติ:
- เวลาการมีส่วนร่วมใกล้ศูนย์: เซสชันจำนวนมากแทบไม่มีเวลาการมีส่วนร่วม หรือมีระยะเวลากระจุกตัวอยู่ในช่วงไม่กี่วินาทีเท่า ๆ กัน
- Direct หรือ Unassigned พุ่งขึ้น: ทราฟฟิก Direct หรือ Unassigned เพิ่มขึ้นอย่างฉับพลันไปยังหน้า Landing Page ที่ไม่มีลิงก์จากที่ใดอย่างชัดเจน
- ชื่อโฮสต์ที่ไม่รู้จัก: มีการบันทึกฮิตบนโดเมนที่ไม่ใช่ของคุณ ซึ่งเกิดขึ้นได้เมื่อมีคนคัดลอก Measurement ID ของคุณไปใส่ในเว็บไซต์อื่น
- โปรไฟล์อุปกรณ์แบบเดียว: ทราฟฟิกจากแหล่งหนึ่งส่วนใหญ่ใช้ความละเอียดหน้าจอ เวอร์ชันเบราว์เซอร์ หรือระบบปฏิบัติการแบบเดียวกัน
- ตำแหน่งที่ตั้งศูนย์ข้อมูล: ทราฟฟิกกระจุกตัวในเมืองที่ขึ้นชื่อว่ามีเซิร์ฟเวอร์ฟาร์ม เช่น แอชเบิร์น รัฐเวอร์จิเนีย แทนที่จะเป็นพื้นที่ที่ลูกค้าของคุณอาศัยอยู่
- ทราฟฟิกกะดึก: ปริมาณทราฟฟิกช่วง 01.00 ถึง 05.00 น. ตามเวลาท้องถิ่นเท่ากับช่วงกลางวัน
- แหล่งอ้างอิงแปลก ๆ: โดเมนที่ไม่คุ้นเคย โดยเฉพาะโดเมนที่โฆษณาบริการ SEO หรือบริการทราฟฟิก
- คอนเวอร์ชันไม่เพิ่ม: เซสชันเพิ่มขึ้นแต่การสมัคร การซื้อ หรือลีดที่มีคุณภาพไม่เพิ่มตาม หรือข้อมูลที่ส่งผ่านแบบฟอร์มเต็มไปด้วยข้อความที่ไม่มีความหมาย
สร้าง Exploration เพื่อตรวจสอบบอต
ส่วน Explore ใน GA4 ช่วยให้คุณสร้างรายงานที่นำกลับมาใช้ซ้ำสำหรับงานนี้ได้ การสำรวจแบบ Free-form ที่เลือกมิติข้อมูลเหมาะสมช่วยตอบคำถามส่วนใหญ่ได้ในไม่กี่นาที และการบันทึกเทมเพลตไว้ช่วยให้การตรวจสอบครั้งต่อไปไม่ต้องเริ่มจากศูนย์:
- การตั้งค่า: สร้างการสำรวจแบบ Free-form โดยใช้มิติข้อมูล session source / medium, landing page, hostname, screen resolution, city และ hour
- เมตริก: sessions, engaged sessions, average engagement time per session และ key events
- เซกเมนต์: สร้างหนึ่งเซกเมนต์สำหรับแหล่งที่มาที่น่าสงสัย และอีกเซกเมนต์สำหรับช่องทางที่เชื่อถือได้เพื่อใช้เป็นฐานเปรียบเทียบ
- การเปรียบเทียบ: วางสองเซกเมนต์เทียบกันทีละมิติข้อมูล โดยใช้การตรวจสอบทั้ง 5 ข้อเป็นแนวทาง
- หลักฐาน: ส่งออกข้อมูลเซสชันที่น่าสงสัยประมาณ 20 เซสชันพร้อมคุณลักษณะต่าง ๆ เพื่อเตรียมส่งให้ผู้ให้บริการหรือแพลตฟอร์มโฆษณา
วิธีนี้ได้ผลเพราะบอตมักไม่ได้ผิดปกติเพียงมิติเดียว การวางเซกเมนต์เทียบกันช่วยให้เห็นโปรไฟล์อุปกรณ์ที่จำกัด ช่วงเวลาที่ผิดปกติ และคอนเวอร์ชันที่ขาดหายไปพร้อมกัน คู่มือการใช้ Analytics เพื่อเพิ่มประสิทธิภาพทราฟฟิกเว็บไซต์ของเราครอบคลุมรายงานหลักของ GA4 และคู่มือการระบุแหล่งที่มาของทราฟฟิก AIอธิบายวิธีอ่านทราฟฟิก Direct โดยไม่ด่วนสรุป
ใช้ Data filters ของ GA4 อย่างระมัดระวัง
Data filters เป็นวิธีหลักในการกรองทราฟฟิกบอตออกจาก GA4 เมื่อคุณรู้แล้วว่ามาจากที่ใด ตัวกรองเหล่านี้สามารถตัดทราฟฟิกภายใน ทราฟฟิกของนักพัฒนา และล่าสุดคือฮิตจากชื่อโฮสต์ที่คุณไม่ได้เป็นเจ้าของ ตัวกรองชื่อโฮสต์ที่รับเฉพาะโดเมนของคุณเป็นวิธีแก้ปัญหา Measurement ID ถูกคัดลอกไปยังเว็บไซต์อื่นได้อย่างตรงจุด ตัวกรองมีประสิทธิภาพสูง แต่ไม่เปิดโอกาสให้แก้พลาด: เมื่อเปิดใช้งานตัวกรองแล้ว ข้อมูลที่ถูกตัดออกจะหายไปถาวร
ขั้นตอนที่นำไปใช้ได้จริง: แนวปฏิบัติที่ปลอดภัยที่สุดคือให้ตัวกรองใหม่ทุกตัวทำงานในโหมด Testing อย่างน้อยหนึ่งสัปดาห์ และเปรียบเทียบผลลัพธ์ที่กรองกับผลลัพธ์ที่ไม่กรองก่อนเปิดใช้งาน วิธีนี้ช่วยป้องกันการลบข้อมูลลูกค้าจริงเพราะพิมพ์ชื่อโดเมนผิดหรือกำหนดกฎกว้างเกินไป
วิธียืนยันตัวตนบอตในระดับเซิร์ฟเวอร์
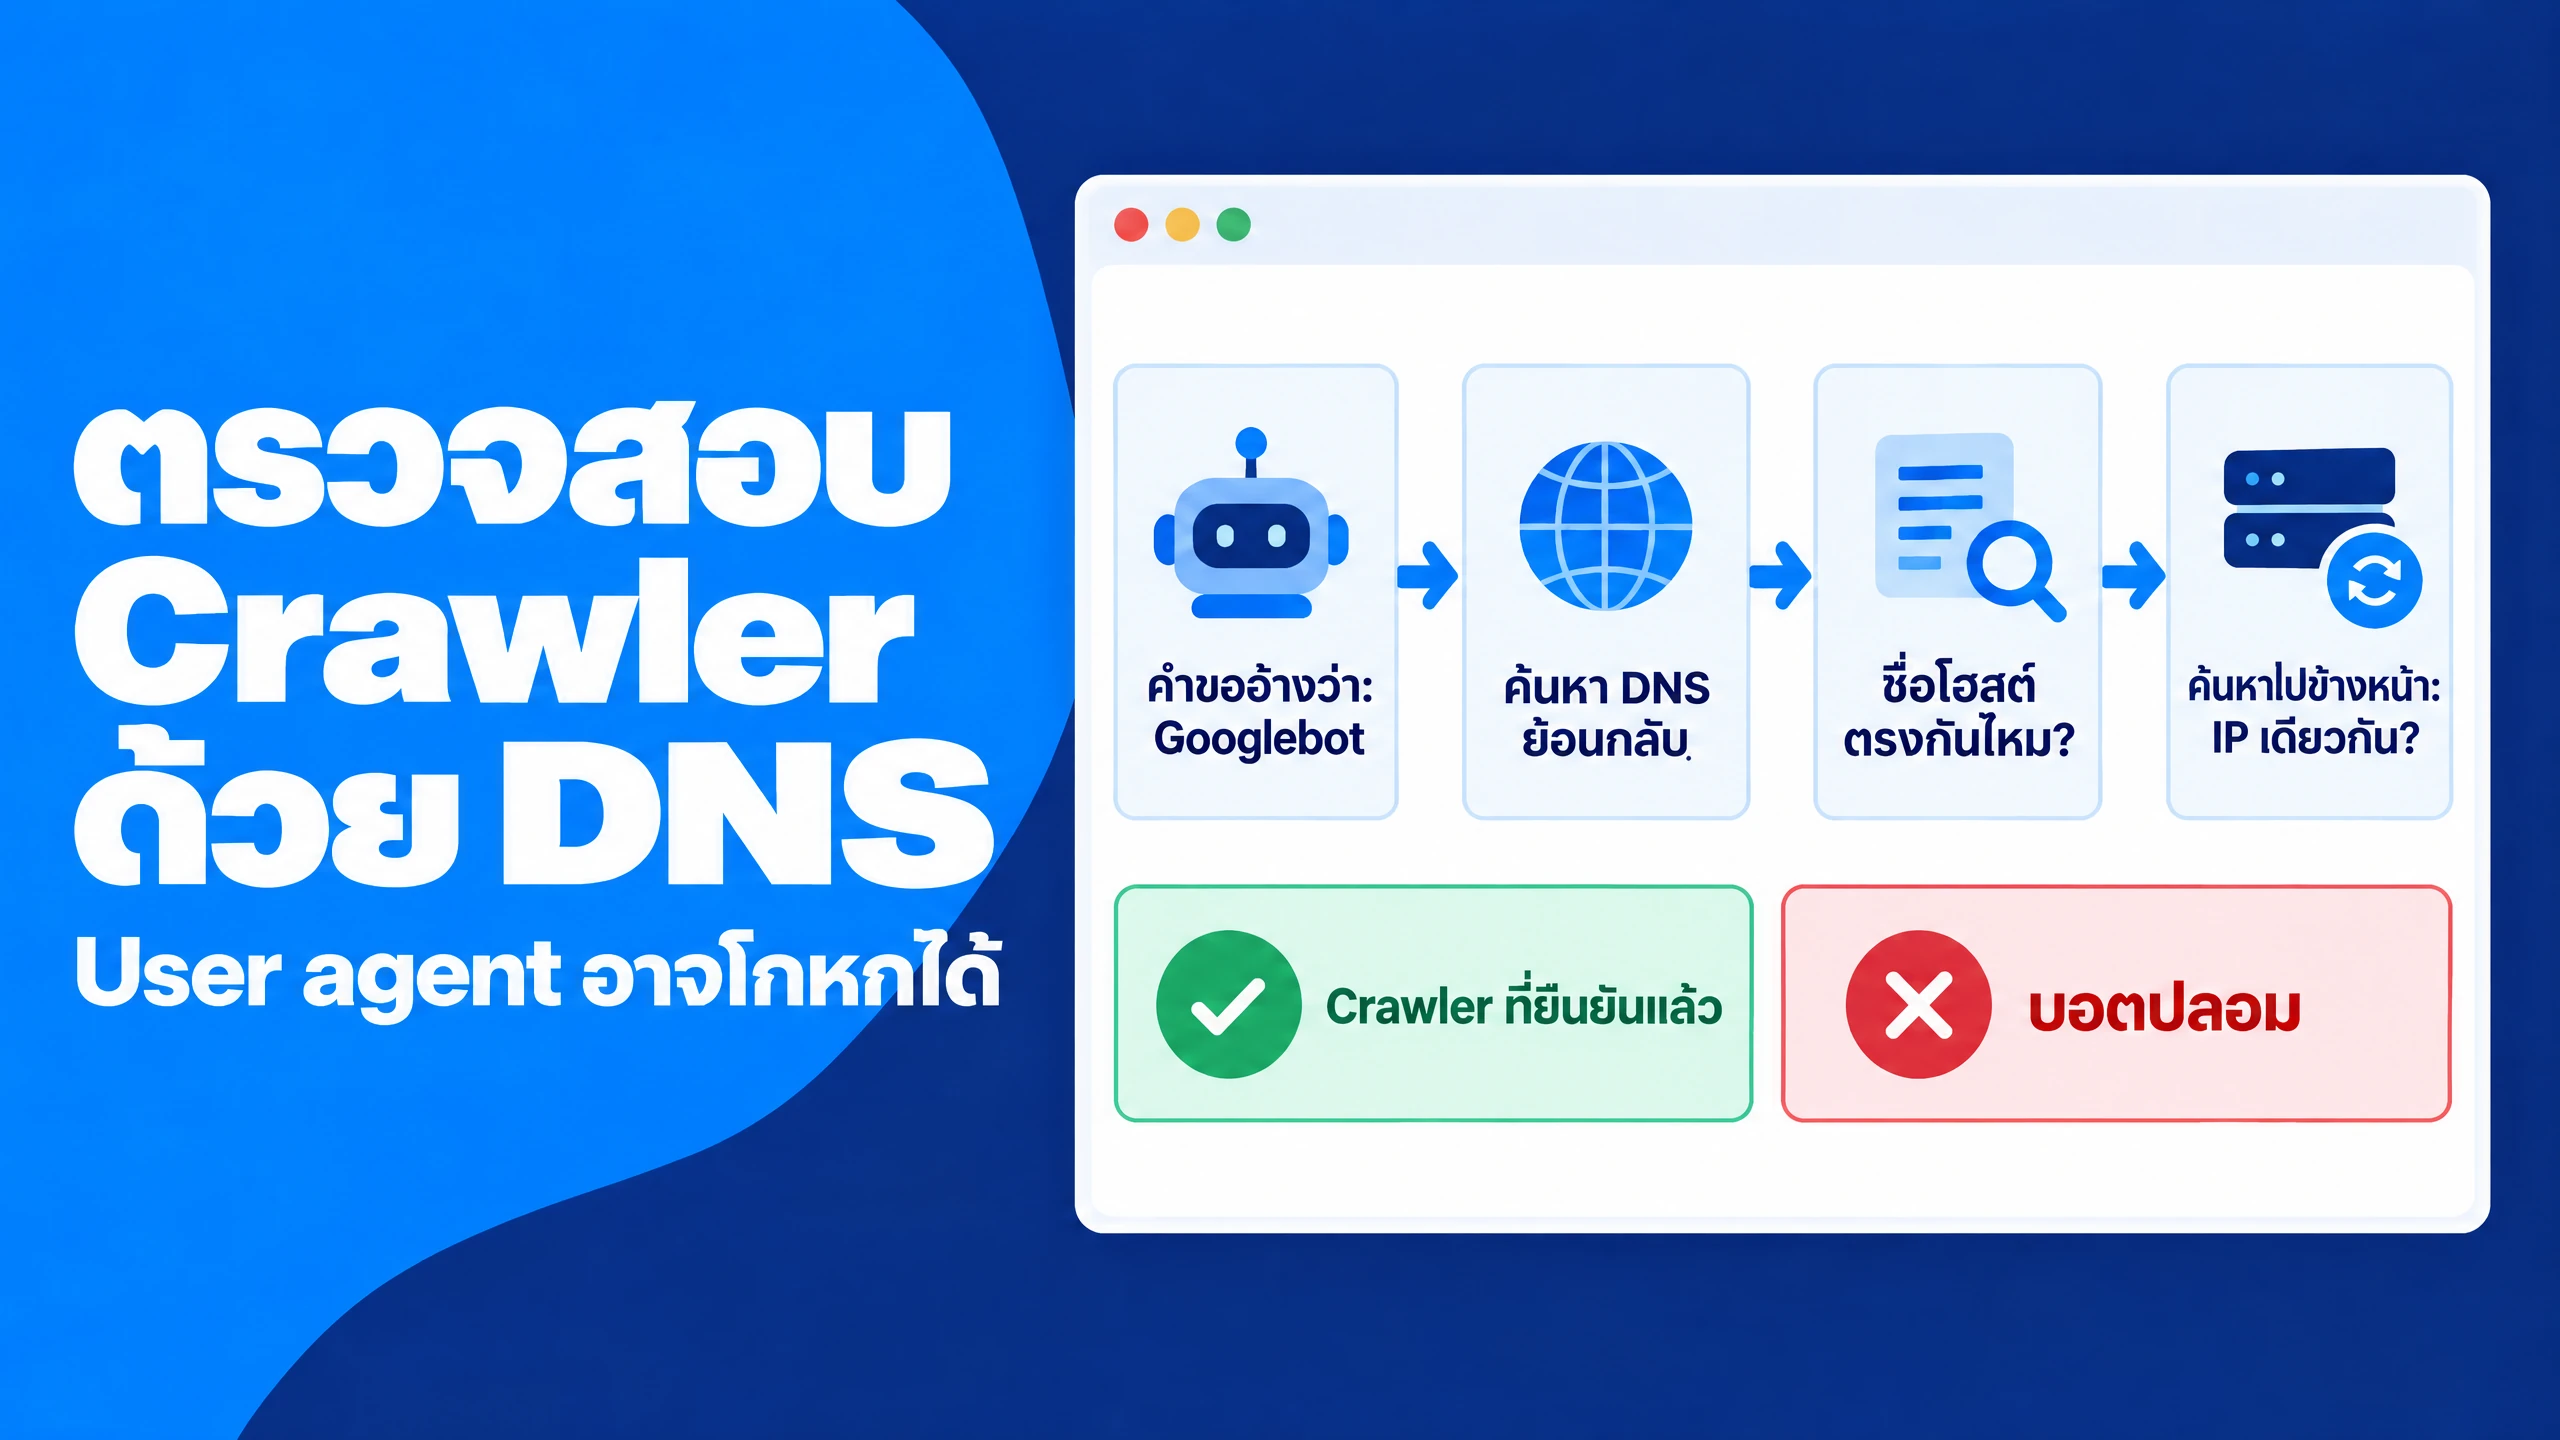
เครื่องมือ Analytics มองเห็นเฉพาะผู้เข้าชมที่รันโค้ดติดตามของคุณ บอตจำนวนมากไม่รัน JavaScript จึงไม่ปรากฏใน GA4 แต่ยังคงใช้แบนด์วิดท์ ดึงเนื้อหา และทดสอบช่องโหว่ของแบบฟอร์มเข้าสู่ระบบ Log ของเซิร์ฟเวอร์ Log ของ CDN หรือแดชบอร์ดโฮสติ้งแสดงทุกคำขอ จึงเป็นจุดที่ใช้ยืนยันได้ว่าใครกำลังเข้าชมจริง ๆ
ทำไม User agent จึงพิสูจน์ตัวตนไม่ได้
ทุกคำขอมีสตริง user agent ที่ระบุชื่อเบราว์เซอร์หรือบอต แต่ข้อควรระวังคือผู้เข้าชมเป็นผู้เขียนข้อมูลนี้เอง โปรแกรมดึงข้อมูลสามารถอ้างว่าเป็น Googlebot, Chrome บน iPhone หรืออะไรก็ได้ด้วยโค้ดเพียงบรรทัดเดียว การใช้ user agent เป็นหลักฐานยืนยันตัวตนจึงเหมือนยอมรับป้ายชื่อแทนหนังสือเดินทาง
ยืนยัน Crawler ด้วย Forward-confirmed reverse DNS
วิธีมาตรฐานในการตรวจสอบผู้ที่อ้างว่าเป็น Crawler คือ forward-confirmed reverse DNS ซึ่งต้องค้นหาสองครั้ง การค้นหา DNS ย้อนกลับจากที่อยู่ IP ของผู้เข้าชมจะได้ชื่อโฮสต์ ซึ่งต้องอยู่ภายใต้โดเมนของผู้ดำเนินการที่อ้างถึง จากนั้นการค้นหา DNS แบบไปข้างหน้าจากชื่อโฮสต์นั้นต้องได้ที่อยู่ IP เดิมกลับมา ดังนั้น Googlebot ปลอมจึงไม่ผ่าน เพราะที่อยู่ IP ของมันไม่สามารถย้อนกลับไปยังโดเมนของ Google ได้
ขั้นตอนที่นำไปใช้ได้จริง: การสุ่มตรวจ Log ทุกเดือนช่วยให้งานนี้จัดการได้ง่าย ดึง user agent 20 รายการที่ส่งคำขอมากที่สุด แล้วตรวจสอบรายการที่อ้างว่าเป็นเครื่องมือค้นหาหรือ AI Crawler รายใหญ่ ใช้เวลาเพียงไม่กี่นาที วิธีนี้ได้ผลเพราะผู้แอบอ้างมักรวมตัวอยู่ในจุดที่ให้ผลตอบแทนสูงสุด: การปลอมเป็น Crawler ที่เชื่อถือได้เป็นวิธีที่ง่ายที่สุดในการผ่านข้อจำกัดอัตราคำขอและไฟร์วอลล์
robots.txt คือคำขอ ไม่ใช่ตัวล็อก
ไฟล์ robots.txt บอก Crawler ว่าสามารถเข้าถึงอะไรได้บ้าง โดยมีรูปแบบมาตรฐานตาม RFC 9309 การปฏิบัติตามเป็นเรื่องสมัครใจ Crawler ที่ทำงานอย่างเหมาะสมจะเคารพข้อกำหนดนี้ ขณะที่บอตทราฟฟิกและโปรแกรมดึงข้อมูลจำนวนมากจะเพิกเฉยหรือเปลี่ยนชื่อเพื่อหลบการบล็อก
robots.txt ยังมีประโยชน์ เพราะช่วยแยกบอตที่เคารพกฎของคุณออกจากบอตที่ไม่เคารพ Wikipedia ระบุว่าในปี 2023 เว็บไซต์ 306 แห่งจาก 1,000 เว็บไซต์ที่มีผู้เข้าชมมากที่สุดบล็อก GPTBot ของ OpenAI ซึ่งสะท้อนว่าเจ้าของเว็บไซต์ใช้ไฟล์นี้เป็นการประกาศนโยบายในปัจจุบัน บอตที่ส่งคำขอไปยังหน้าที่คุณห้ามเข้าถึงได้เผยข้อมูลสำคัญเกี่ยวกับเจตนาของมันแล้ว
การยืนยันตัวตนบอตด้วยลายเซ็นกำลังมา
ทางแก้ระยะยาวสำหรับการแอบอ้างคือการยืนยันตัวตนด้วยการเข้ารหัส Internet Engineering Task Force (IETF) ได้จัดตั้งคณะทำงาน Web Bot Auth เพื่อกำหนดมาตรฐานวิธีที่บอตใช้พิสูจน์ตัวตน โดยต่อยอดจาก HTTP Message Signatures บอตที่ใช้ลายเซ็นจะแนบลายเซ็นที่ตรวจสอบได้กับทุกคำขอ ทำให้เว็บไซต์ยืนยันผู้ดำเนินการได้โดยไม่ต้องอาศัยรายชื่อ IP การติดตามงานนี้ตั้งแต่ตอนนี้ช่วยให้คุณวางแผนได้ว่าจะอนุญาตผู้เข้าชมอัตโนมัติประเภทใด เมื่อการใช้ลายเซ็นแพร่หลาย
วิธีหยุดทราฟฟิกบอตโดยไม่บล็อกผู้ใช้จริง
การบล็อกบอตฟังดูง่าย จนกระทั่งลูกค้าจริงติดร่างแหไปด้วย การใช้ CAPTCHA อย่างเข้มงวดสร้างความหงุดหงิดให้ผู้ที่ใช้โทรศัพท์ช้า และสร้างอุปสรรคให้ผู้ใช้เทคโนโลยีสิ่งอำนวยความสะดวก การบล็อกทั้งประเทศหรือศูนย์ข้อมูลแบบเหมารวมอาจทำให้นักเดินทาง ผู้ใช้ VPN ขององค์กร และผู้เข้าชมที่ให้ความสำคัญกับความเป็นส่วนตัวเข้าใช้งานไม่ได้ ทุกครั้งที่ระบบระบุผู้ใช้จริงผิดว่าเป็นบอต คุณจะเสียลีดที่ไม่มีวันปรากฏในรายงานใด
แนวทางสมัยใหม่ยังต้องคำนึงถึงระบบอัตโนมัติที่มีประโยชน์ด้วย ผู้ช่วย AI เข้ามาดึงหน้าเว็บ เปรียบเทียบสินค้า และกรอกแบบฟอร์มแทนคนมากขึ้นเรื่อย ๆ การมองว่าทุกคำขอที่ไม่ได้มาจากมนุษย์เป็นภัยอาจตัดโอกาสรับการเข้าชมที่ลูกค้าจริงเป็นผู้ร้องขอ
เลือกมาตรการให้เหมาะกับบอต
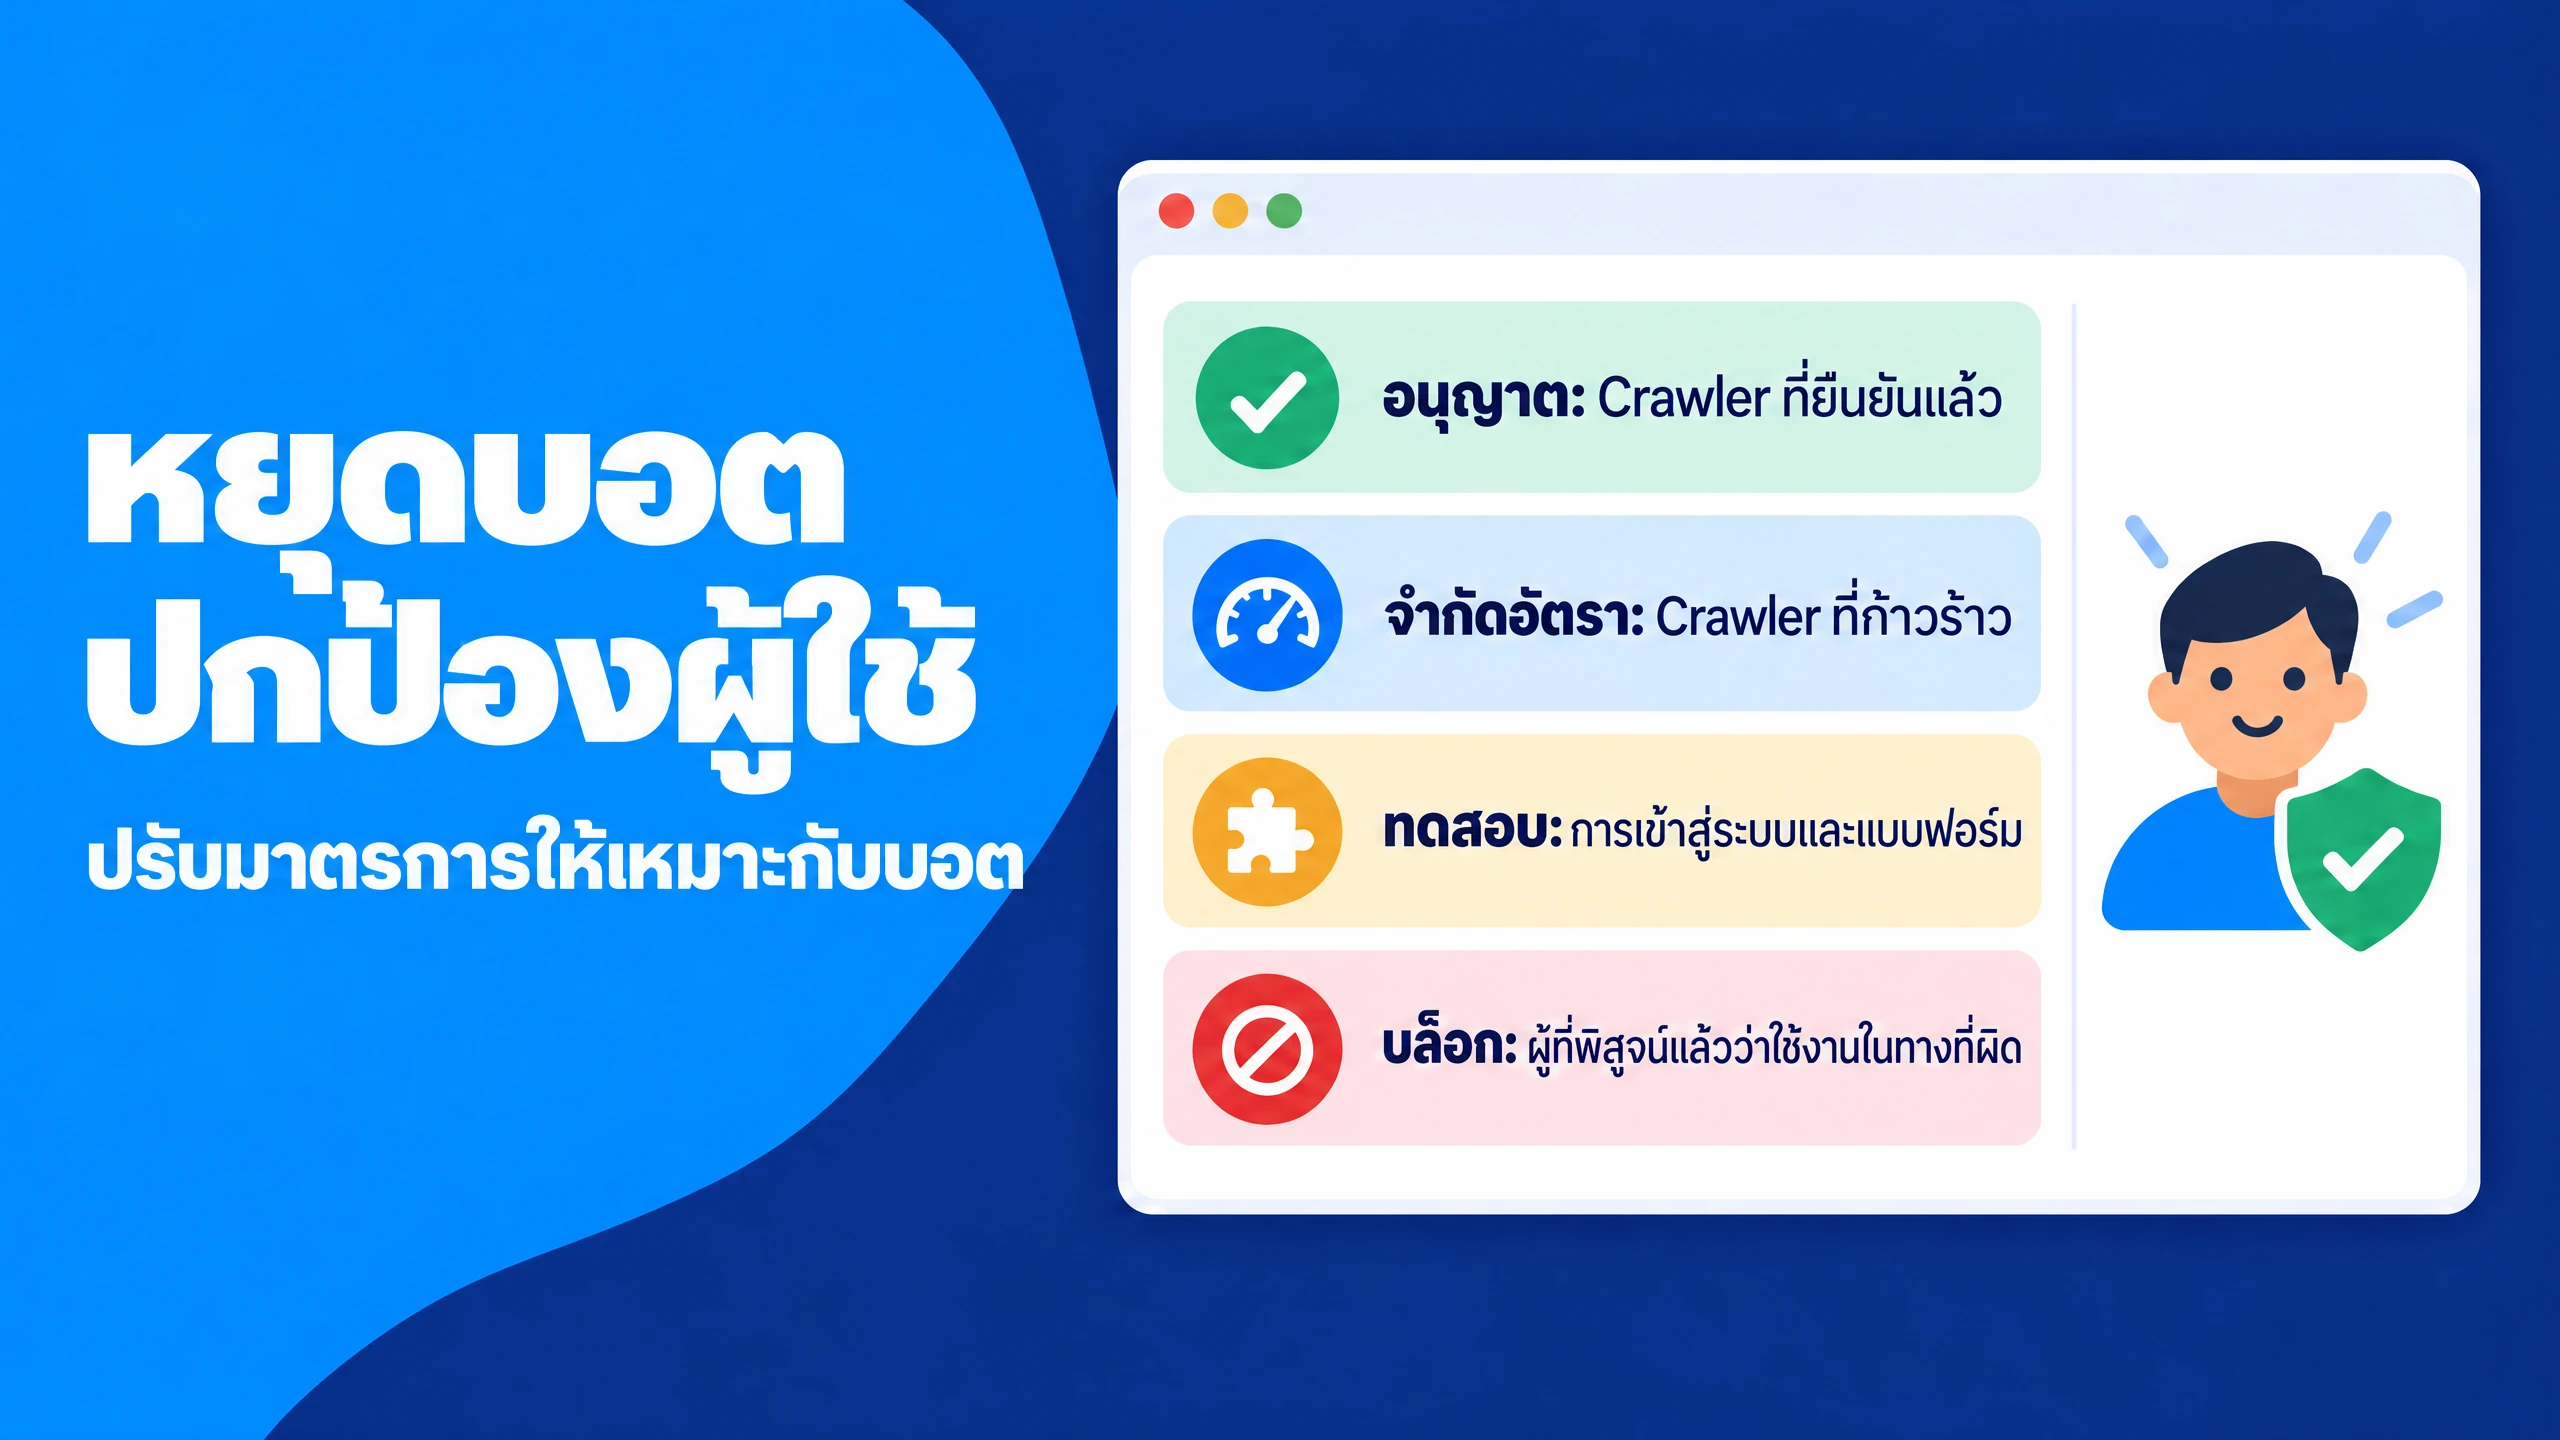
การป้องกันที่มีประสิทธิภาพที่สุดใช้มาตรการตามระดับ ไม่ใช่อนุญาตทั้งหมดหรือบล็อกทั้งหมด ผู้เข้าชมอัตโนมัติแต่ละประเภทควรได้รับมาตรการที่เบาที่สุดซึ่งยังแก้ปัญหาได้:
- Crawler ที่ยืนยันแล้วและคุณต้องการ: อนุญาต เพราะช่วยให้ปรากฏในผลการค้นหาและได้รับการอ้างอิงจาก AI
- Crawler ที่ถูกต้องแต่ส่งคำขอมากเกินไป: จำกัดอัตราคำขอ เพื่อปกป้องประสิทธิภาพเซิร์ฟเวอร์โดยไม่ทำให้การทำงานใดเสียหาย
- ทราฟฟิกที่ยังไม่ยืนยันบนหน้าที่มีความอ่อนไหว: ให้ผ่าน CAPTCHA หรือการทดสอบคล้ายกันเฉพาะหน้าเข้าสู่ระบบ สมัครสมาชิก และชำระเงิน ซึ่งเป็นจุดที่การใช้งานในทางที่ผิดสร้างต้นทุนสูงที่สุด
- ผู้ที่พิสูจน์แล้วว่าใช้งานในทางที่ผิด: บล็อกตามช่วง IP เครือข่าย หรือลักษณะเฉพาะที่ตรวจจับได้ เมื่อมีหลักฐานชัดเจน
การแบ่งระดับนี้ได้ผลเพราะเพิ่มขั้นตอนเฉพาะจุดที่การใช้งานในทางที่ผิดสร้างความเสียหายจริง และทำให้ส่วนที่เหลือของเว็บไซต์ยังรวดเร็วและเปิดให้คนเข้าใช้งานได้
ปกป้องแบบฟอร์ม การสมัคร และการชำระเงิน
แบบฟอร์มคือจุดที่บอตสร้างความเสียหายยาวนานที่สุด การสมัครปลอมทำให้ข้อมูลใน CRM ปนเปื้อน กระตุ้นให้ส่งอีเมลต้อนรับไปยังที่อยู่ที่ตีกลับ และทำลายชื่อเสียงผู้ส่ง ลีดปลอมทำให้ทีมขายเสียเวลาและบิดเบือนรายงานต้นทุนต่อลีด
ขั้นตอนที่นำไปใช้ได้จริง: การป้องกันชั้นแรกที่เรียบง่ายคือช่อง honeypot ซึ่งเป็นช่องในแบบฟอร์มที่ซ่อนจากคนแต่บอตมองเห็น จึงสามารถปฏิเสธการส่งแบบฟอร์มที่กรอกช่องนี้ได้ การตรวจสอบข้อมูลฝั่งเซิร์ฟเวอร์ การจำกัดอัตราคำขอต่อที่อยู่ IP และการยืนยันสมัครรับอีเมลแบบ Double opt-in ช่วยเพิ่มชั้นการป้องกัน วิธีนี้ได้ผลเพราะแต่ละชั้นหยุดบอตคนละประเภท ขณะที่ผู้ใช้จริงไม่สังเกตเห็นขั้นตอนเหล่านี้เลย
เปิดทางให้ AI Agent ที่ทำงานแทนคน
การเข้าชมอัตโนมัติบางส่วนในปัจจุบันสะท้อนความต้องการจริง AI Agent ที่ตรวจสอบราคาหรือจองเดโมให้ผู้ใช้คือการปฏิสัมพันธ์กับลูกค้าที่ดำเนินการผ่านซอฟต์แวร์ การบล็อกทันทีอาจทำให้เสียยอดขาย แต่การปล่อยผ่านโดยไม่ตรวจสอบก็อาจบิดเบือนเมตริกการมีส่วนร่วม
ทางสายกลางที่นำไปใช้ได้จริงคือระบุ Agent เหล่านี้แยกต่างหาก อนุญาตให้เข้าถึงหน้าสาธารณะ และวัดผลในเซกเมนต์เฉพาะ คู่มือทราฟฟิกจาก Agentic AIของเราอธิบายว่าการเข้าชมที่มี Agent ช่วยดำเนินการปรากฏใน Analytics อย่างไร และควรเตรียมหน้าเว็บให้รองรับอย่างไร
วิธีดูแลแคมเปญทราฟฟิกแบบเสียเงินให้ปลอดบอต
ทราฟฟิกแบบเสียเงินเป็นจุดที่ทราฟฟิกบอตกระทบงบประมาณโดยตรงที่สุด ทุกคลิกหรือการแสดงผลที่ไม่ถูกต้องคือเงินที่จ่ายไปโดยไม่มีผู้ชมจริง ความเสี่ยงสูงที่สุดอยู่ที่พื้นที่โฆษณาราคาถูกที่เข้าถึงกลุ่มกว้าง และผู้ให้บริการที่บอกไม่ได้ว่าการเข้าชมมาจากไหน เพราะแรงจูงใจของพวกเขาคือปริมาณ ไม่ใช่ผลลัพธ์
ข้อเสนอบางอย่างคือบอตทราฟฟิกที่ปลอมตัวมา สัญญาณเตือนได้แก่การสัญญาว่าการเข้าชมจะ “ตรวจจับไม่ได้” หรือ “ดูเหมือนคนจริง” การรับประกันอันดับการค้นหาที่ดีขึ้น ผู้เข้าชมไม่จำกัดในราคาเหมาจ่าย และการนำเครือข่าย Residential proxy มาเสนอเป็นจุดเด่น ในทางกลับกัน แพลตฟอร์มโฆษณาที่ถูกต้องจะพูดถึงการกำหนดกลุ่มเป้าหมาย ตำแหน่งโฆษณา การตรวจสอบหน้า Landing Page และการวัดผล การซื้อการเข้าชมจากบอตส่งผลเสียกลับมาทุกครั้ง: การเข้าชมเหล่านี้ไม่สร้างคอนเวอร์ชัน ทำให้ผลทดสอบปนเปื้อน เครือข่ายโฆษณาอาจแบนเว็บไซต์ที่สร้างรายได้จากโฆษณาและได้รับทราฟฟิกเหล่านี้ อีกทั้งการซื้อเองอาจละเมิดข้อกำหนดด้านการคุ้มครองผู้บริโภค
ติดแท็กทุกแหล่งทราฟฟิกแบบเสียเงิน
ทราฟฟิกแบบเสียเงินที่ไม่ติดแท็กจะปะปนอยู่ใน Direct และ Referral ซึ่งบอตซ่อนตัวได้ง่าย UTM parameters คือแท็กที่เพิ่มลงในลิงก์เพื่อบอกเครื่องมือ Analytics อย่างชัดเจนว่าการเข้าชมนั้นมาจากแหล่งที่มา แคมเปญ และตำแหน่งโฆษณาใด
ขั้นตอนที่นำไปใช้ได้จริง: กติกา UTM ง่าย ๆ ช่วยแก้ช่องว่างในการระบุแหล่งที่มาส่วนใหญ่ได้ โดยกำหนดค่า source, medium และ campaign แยกให้แต่ละแคมเปญโฆษณา และบันทึกไว้ในชีตมาตรฐานการตั้งชื่อที่ใช้ร่วมกัน วิธีนี้ได้ผลเพราะการตรวจสอบทั้ง 5 ข้อต้องอาศัยกลุ่มข้อมูลที่แยกชัดเจน หากการเข้าชมจากโฆษณาปะปนอยู่ใน Direct คุณจะระบุไม่ได้ว่าผู้ให้บริการรายใดส่งเซสชันที่น่าสงสัยมา
ทดสอบเล็ก ๆ ก่อนขยายผล
งบทดสอบเล็กน้อยช่วยให้รู้ว่าแหล่งทราฟฟิกมีพฤติกรรมเหมือนคนจริงหรือไม่ ก่อนทุ่มเงินจริงจัง เซสชันเพียงไม่กี่ร้อยครั้งก็เพียงพอสำหรับการตรวจสอบทั้ง 5 ข้อ และข้อมูลหนึ่งสัปดาห์ช่วยให้เห็นรูปแบบในแต่ละวัน แนวทางที่เป็นระบบนี้ยังช่วยปรับปรุงงานแลนดิ้งเพจได้ด้วย ดังที่อธิบายไว้ในคู่มือเรื่อง การทำ A/B testing แลนดิ้งเพจด้วยทราฟฟิกจากโฆษณา
รูปแบบโฆษณาก็สำคัญเช่นกัน ทราฟฟิกจากโฆษณา Popunder, Native และ Push ต่างสร้างรูปแบบการมีส่วนร่วมที่แตกต่างกัน เพราะผู้เข้าชมจาก Popunder มีพฤติกรรมต่างจากคนที่เลือกคลิกโฆษณา Native การประเมินแต่ละรูปแบบเทียบกับค่าฐานของตัวเองช่วยหลีกเลี่ยงการแจ้งเตือนที่ผิดพลาด
ใช้นโยบายคืนเงินและให้เครดิตเป็นสัญญาณคุณภาพ
แพลตฟอร์มที่น่าเชื่อถือคาดหวังให้คุณตรวจสอบทราฟฟิกของตน และอธิบายว่าจะดำเนินการอย่างไรเมื่อพบสิ่งผิดปกติ แพลตฟอร์มที่ดีมีกระบวนการชัดเจนว่า ต้องใช้หลักฐานอะไร ตรวจสอบรายงานอย่างไร และให้เครดิตชดเชยกิจกรรมที่ไม่ถูกต้องหรือไม่ ผู้ให้บริการที่ปฏิเสธการตรวจสอบทุกกรณี หรืออ้างว่าทราฟฟิกของตนเป็น "คนจริง 100%" กำลังส่งสัญญาณบางอย่างให้คุณ แม้แต่ MRC ยังหลีกเลี่ยงการเรียกทราฟฟิกที่ผ่านการกรองว่า "คนจริง" และเลือกใช้คำว่า "ถูกต้อง" เพราะไม่มีตัวกรองใดรับประกันได้ว่าการเข้าชมทุกครั้งที่เหลืออยู่มาจากคน
กลยุทธ์ขั้นสูง: ตรวจสอบทราฟฟิกบอตทุกเดือน
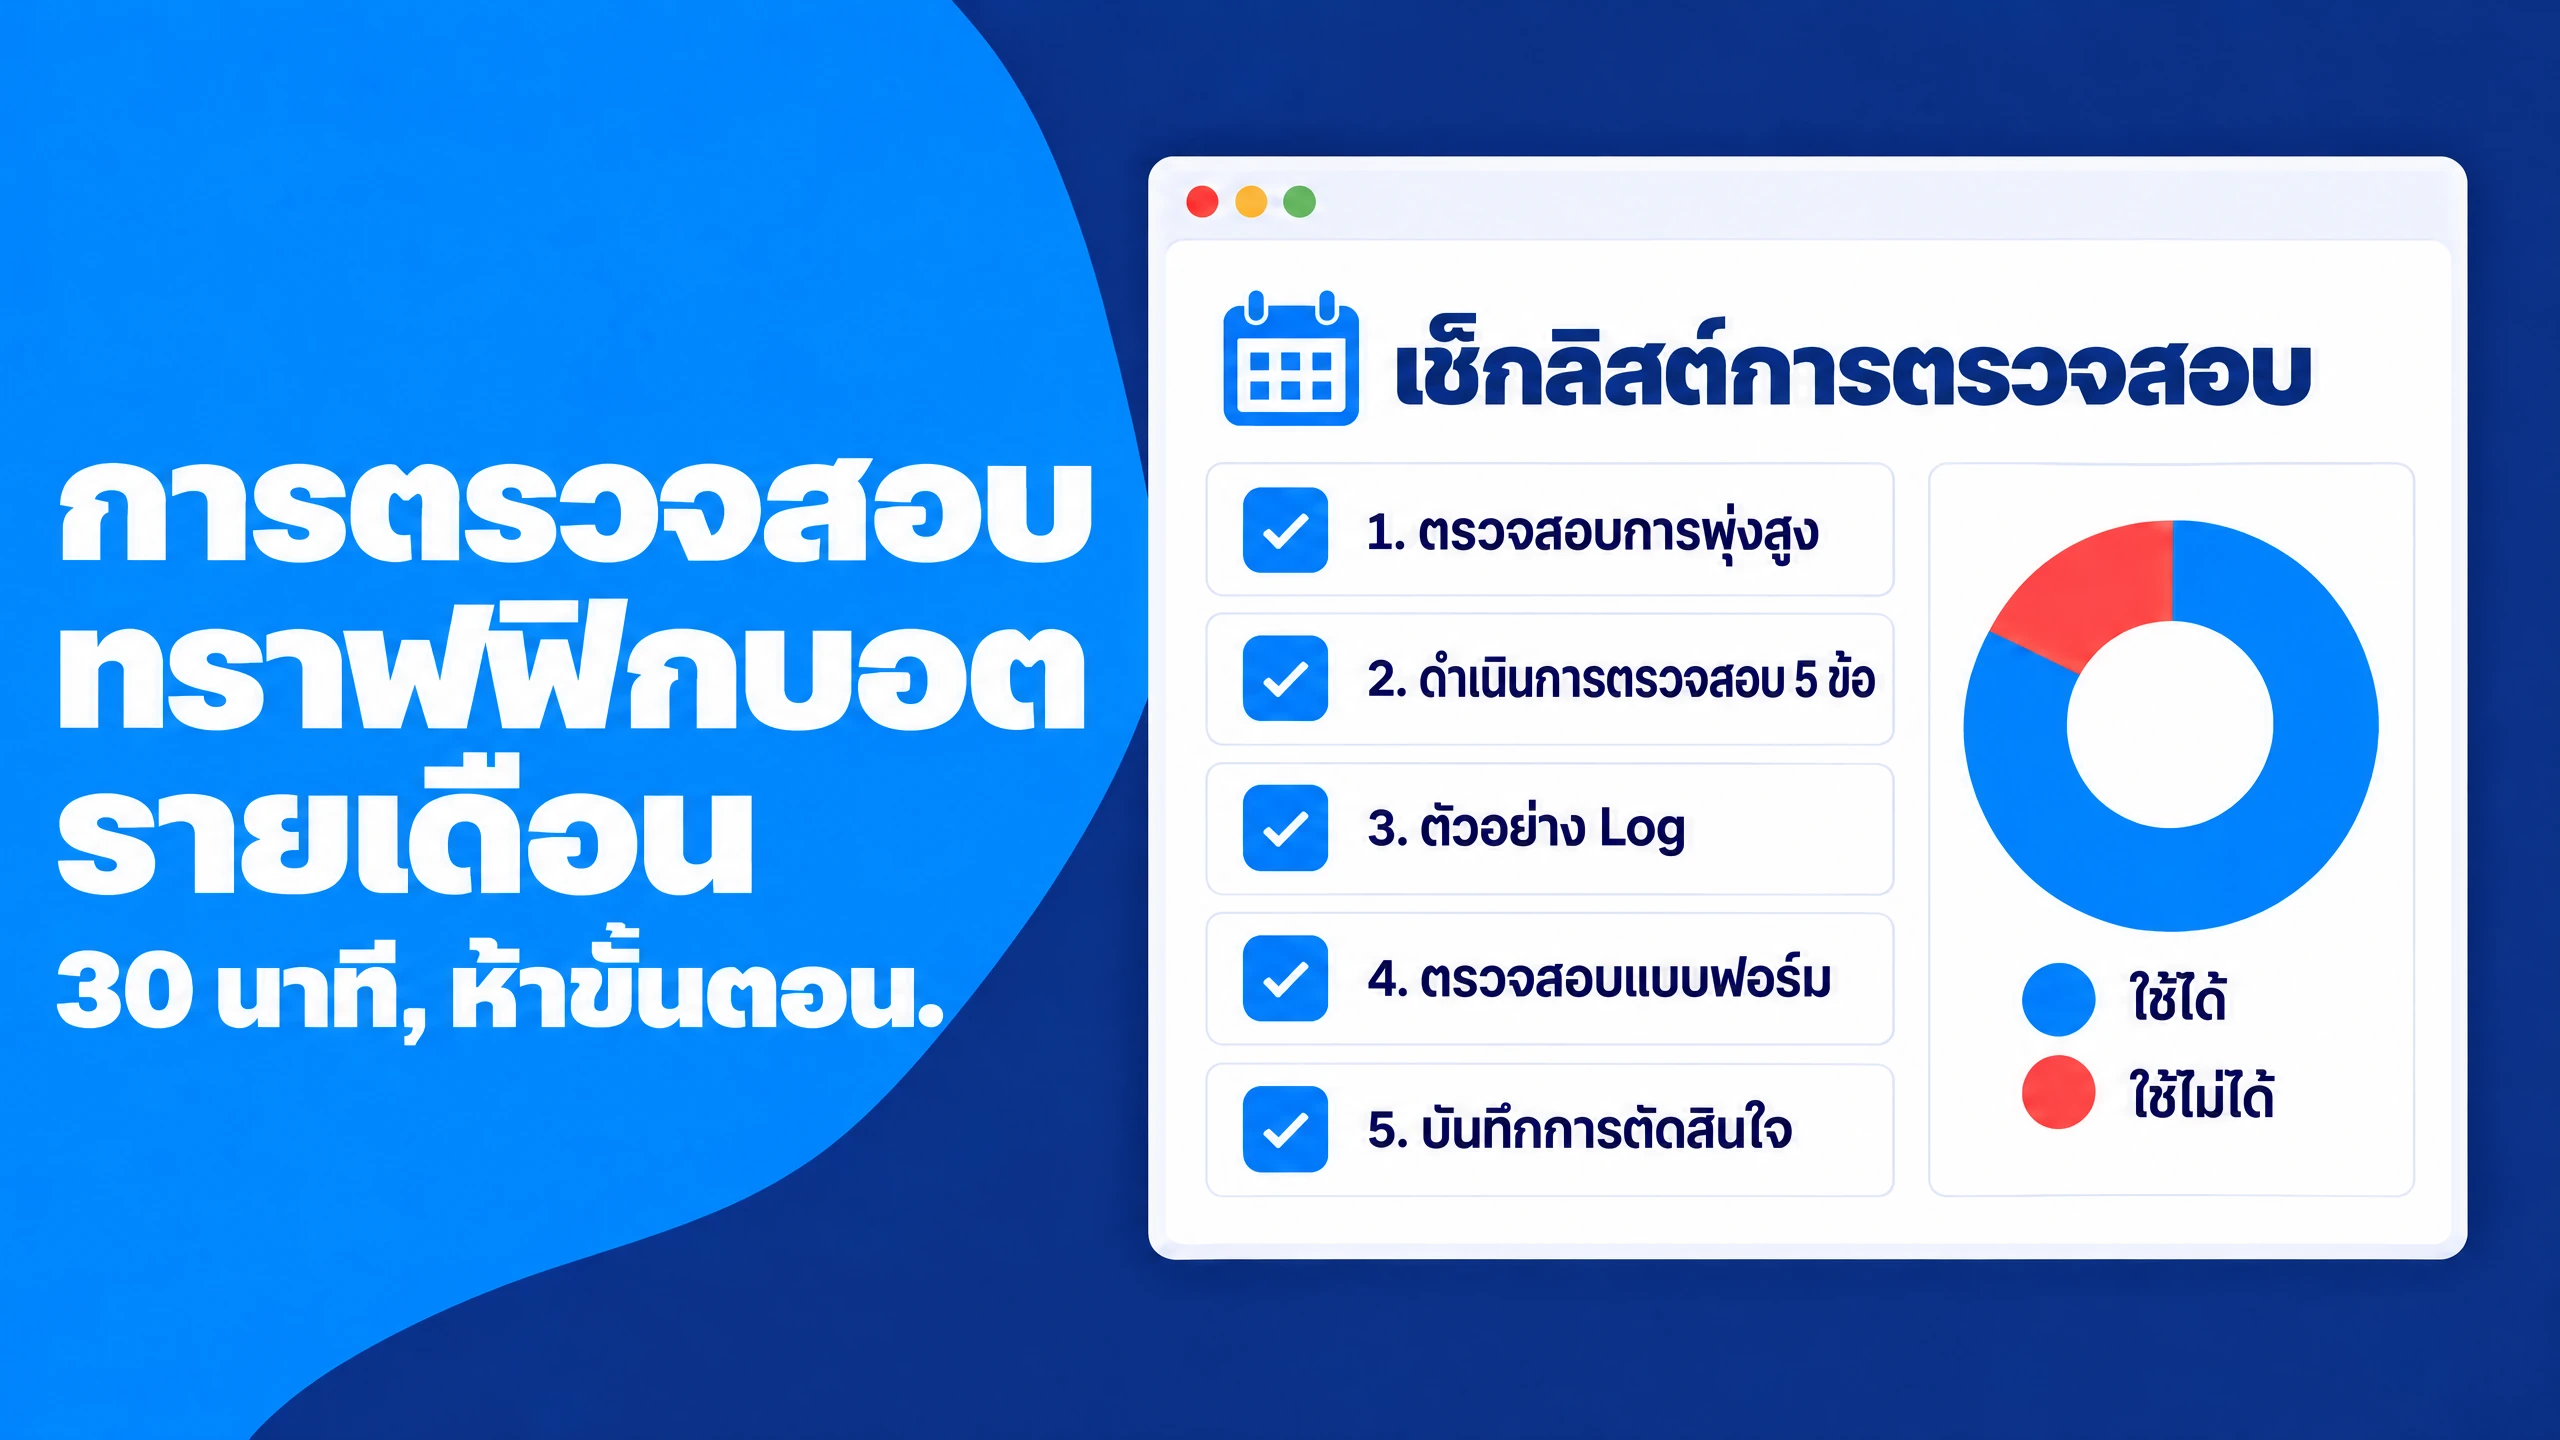
การตรวจสอบเป็นครั้งคราวแก้ปัญหาได้เป็นครั้ง ๆ บอตเปลี่ยน แคมเปญเปลี่ยน และเครื่องมือของคุณเองก็เปลี่ยน การตรวจสอบสั้น ๆ เป็นประจำทุกเดือนจึงช่วยพบปัญหาก่อนที่จะบิดเบือนการตัดสินใจตลอดทั้งไตรมาส เป้าหมายไม่ใช่การทำให้ทราฟฟิกบอตเป็นศูนย์ ซึ่งเป็นไปไม่ได้ แต่คือการรู้ว่าทราฟฟิกบอตมีอะไรบ้าง วัดผลได้ และมีบันทึกไว้
กิจวัตรรายเดือนใน 30 นาที
การตรวจสอบเป็นประจำได้ผลดีที่สุดเมื่อทำตามขั้นตอนเดิมทุกครั้ง เพื่อให้มองเห็นแนวโน้มได้ชัดเจน:
- ทบทวนทราฟฟิกที่พุ่งสูง: ระบุสาเหตุของทุกช่วงที่ทราฟฟิกพุ่งสูงในเดือนที่ผ่านมา หรือทำเครื่องหมายว่ายังหาคำอธิบายไม่ได้
- ตรวจสอบ 5 ข้อ: ให้คะแนนแหล่งทราฟฟิกและแคมเปญหลักแต่ละรายการตามเกณฑ์ตรวจสอบทั้ง 5 ข้อ
- สุ่มตรวจ Log: ตรวจสอบ Crawler ที่อ้างตัวและมีจำนวนมากที่สุด ด้วยการตรวจสอบ reverse DNS และยืนยันกลับด้วย forward DNS
- ตรวจสอบแบบฟอร์ม: ตรวจสอบการสมัครและลีดว่ามีชื่อเหมือนกัน โดเมนอีเมลแบบใช้แล้วทิ้ง หรือจำนวนที่เพิ่มขึ้นฉับพลันหรือไม่
- บันทึกการตัดสินใจ: บันทึกว่าคุณกรอง บล็อก หรือรายงานอะไร และเพราะเหตุใด
กิจวัตรนี้ได้ผลเพราะทำให้การตรวจจับบอตกลายเป็นนิสัยที่มีหลักฐานบันทึกไว้ เมื่อผู้มีส่วนเกี่ยวข้องถามว่าทำไมตัวเลขเดือนมีนาคมจึงเปลี่ยนไป คุณก็มีคำตอบ
เขียนนโยบายทราฟฟิกที่ไม่ถูกต้องในหนึ่งหน้า
แม้แต่ผู้เชี่ยวชาญก็ยังนิยามทราฟฟิกที่ไม่ถูกต้องให้ชัดเจนได้ยาก Tuzhilin Report ซึ่งเป็นการตรวจสอบอิสระเกี่ยวกับการตรวจจับคลิกทุจริตของ Google และมีอธิบายไว้ใน บทความ Wikipedia เรื่องคลิกทุจริต สรุปว่า "ไม่มีนิยามเชิงแนวคิดของคลิกที่ไม่ถูกต้องที่สามารถนำไปใช้ปฏิบัติได้" ยกเว้นกรณีที่เห็นได้ชัด หากทั้งอุตสาหกรรมยังตกลงใช้นิยามเดียวกันไม่ได้ การมีนิยามของตัวเองก็เป็นประโยชน์ต่อทีมคุณ
ขั้นตอนที่นำไปใช้ได้จริง: นโยบายหนึ่งหน้าช่วยยุติข้อถกเถียงส่วนใหญ่ได้ล่วงหน้า โดยระบุว่าคุณอนุญาตผู้เข้าชมอัตโนมัติประเภทใด เกณฑ์ใดที่ต้องเริ่มตรวจสอบ ใครเป็นผู้ตัดสินใจ และรายงานผลให้เอเจนซีและผู้ให้บริการอย่างไร วิธีนี้ได้ผลเพราะกติกาที่เป็นลายลักษณ์อักษรช่วยแทนที่การถกเถียงเป็นรายกรณี และทำให้พาร์ตเนอร์มีมาตรฐานที่ชัดเจนให้ปฏิบัติตาม
ติดตามตัวชี้วัดที่บอตปลอมได้ยากและมีต้นทุนสูง
ยอดดูหน้าเว็บและเซสชันปลอมได้ด้วยต้นทุนต่ำ แต่รายได้ ลีดที่มีคุณภาพ การซื้อซ้ำ คำร้องขอความช่วยเหลือ และผู้ใช้ที่กลับมาโดยเข้าสู่ระบบ มีต้นทุนสูงในการปลอม หรือไม่สามารถปลอมในปริมาณมากได้ แหล่งทราฟฟิกที่เพิ่มเซสชันแต่ไม่เคยทำให้ตัวเลขเหล่านี้ขยับควรได้รับการตรวจสอบอย่างละเอียด ไม่ว่าการมีส่วนร่วมจะดูดีเพียงใด
การยึดตัวชี้วัดผลลัพธ์เหล่านี้เป็นหลักในการรายงานคือแนวป้องกันระยะยาวที่แข็งแกร่งที่สุด ช่วยให้ทุกการตัดสินใจเรื่องทราฟฟิกสอดคล้องกับสิ่งที่คนทำจริง และขจัดแรงจูงใจของทุกฝ่ายในห่วงโซ่การจัดหาทราฟฟิกที่จะเพิ่มตัวเลขให้ดูสูงเกินจริง
คำถามที่พบบ่อยเกี่ยวกับบอตทราฟฟิก
บอตทราฟฟิกคืออะไร อธิบายง่าย ๆ?
บอตทราฟฟิกคือซอฟต์แวร์ที่เข้าเว็บไซต์หรือคลิกโฆษณาโดยอัตโนมัติ เพื่อให้กิจกรรมนั้นดูเหมือนมาจากคนจริง โดยทั่วไปจะทำให้ตัวชี้วัด เช่น ยอดดูหน้าเว็บ คลิก ยอดดูวิดีโอ หรือผู้ติดตาม สูงเกินจริง
ทราฟฟิกบอตทุกประเภทเป็นอันตรายหรือไม่?
ไม่ใช่ Crawler ของเครื่องมือค้นหา เครื่องมือตรวจสอบสถานะเว็บไซต์ และ AI Crawler จำนวนมากมีประโยชน์ ทราฟฟิกบอตกลายเป็นปัญหาเมื่อแสร้งเป็นคนจริง ทำให้งบโฆษณาสูญเปล่า ดึงเนื้อหาไปโดยขัดกับกฎของคุณ หรือบิดเบือนข้อมูลวิเคราะห์
ทราฟฟิกบอตส่งผลเสียต่อ SEO หรือไม่?
การเข้าชมปลอมไม่ได้ช่วยให้อันดับดีขึ้น เพราะเครื่องมือค้นหาใช้สัญญาณคุณภาพหลายอย่าง ไม่ใช่แค่จำนวนการเข้าชมดิบ อย่างไรก็ตาม ทราฟฟิกบอตอาจส่งผลเสียทางอ้อมด้วยการทำให้เซิร์ฟเวอร์ช้าลง คัดลอกเนื้อหาของคุณ และทำให้คุณเลือกปรับปรุงผิดหน้าโดยอาศัยข้อมูลที่ปนเปื้อน
Google Analytics 4 กรองทราฟฟิกบอตโดยอัตโนมัติหรือไม่?
ใช่ GA4 ยกเว้นบอตและ Spider ที่รู้จักโดยอัตโนมัติ และคุณไม่สามารถปิดการทำงานนี้หรือดูว่าระบบตัดออกไปเท่าใด บอตที่ไม่รู้จักและบอตที่ซับซ้อนยังอาจปรากฏในรายงานได้ จึงยังจำเป็นต้องเปรียบเทียบกลุ่มข้อมูลและตรวจสอบทั้ง 5 ข้อ
ทราฟฟิกบอตมากแค่ไหนถือว่าปกติ?
ไม่มีตัวเลขที่ใช้ได้กับทุกเว็บไซต์ ทราฟฟิกบนเว็บมากกว่าครึ่งเป็นทราฟฟิกอัตโนมัติ แต่ส่วนใหญ่ไม่เคยเรียกใช้โค้ดวิเคราะห์ของคุณ เกณฑ์เปรียบเทียบที่ใช้งานได้จริงคือช่องทางที่คุณเชื่อถือและใช้เป็นค่าฐาน แหล่งทราฟฟิกที่แตกต่างจากค่าฐานนี้มากควรได้รับการตรวจสอบเพิ่มเติม
จะหยุดทราฟฟิกบอตบนเว็บไซต์ได้อย่างไร?
แนวทางที่มีประสิทธิภาพที่สุดคือจัดการเป็นระดับ อนุญาต Crawler ที่ยืนยันแล้ว จำกัดอัตราการเข้าถึงของ Crawler ที่ทำงานหนักเกินไป ให้ทราฟฟิกที่ยังไม่ยืนยันผ่านขั้นตอนตรวจสอบเฉพาะที่หน้าเข้าสู่ระบบและแบบฟอร์ม และบล็อกผู้ที่พิสูจน์แล้วว่าใช้งานในทางที่ผิด ฟิลด์ Honeypot การตรวจสอบข้อมูลฝั่งเซิร์ฟเวอร์ รวมถึงตัวกรอง hostname และทราฟฟิกภายในของ GA4 ช่วยให้ทั้งแบบฟอร์มและรายงานของคุณปราศจากข้อมูลรบกวน
จะรู้ได้อย่างไรว่าทราฟฟิกเว็บไซต์มาจากบอต?
วิธีที่เร็วที่สุดคือเปรียบเทียบแหล่งทราฟฟิกที่น่าสงสัยกับช่องทางที่คุณเชื่อถือใน 5 ด้าน ได้แก่ ระยะเวลาเซสชัน ความละเอียดหน้าจอ ช่วงเวลาของวัน ตำแหน่งที่ตั้ง และการโต้ตอบ หากพบความผิดปกติชัดเจนตั้งแต่ 2 ด้านขึ้นไป เช่น ระยะเวลาเซสชันเท่ากันทุกครั้ง และปริมาณทราฟฟิกกลางคืนเท่ากับกลางวัน ก็เป็นสัญญาณหนักแน่นว่าเป็นทราฟฟิกอัตโนมัติ จากนั้นใช้ Log ของเซิร์ฟเวอร์และการตรวจสอบ reverse DNS ที่ยืนยันกลับด้วย forward DNS เพื่อยืนยันว่า Crawler ที่อ้างตัวเป็นของจริงหรือไม่
การซื้อทราฟฟิกบอตถูกกฎหมายหรือไม่?
กฎแตกต่างกันไปในแต่ละประเทศ แต่การซื้อการมีส่วนร่วมปลอมเพื่อใช้เชิงพาณิชย์มีความเสี่ยงทางกฎหมายและธุรกิจอย่างแท้จริง ในสหรัฐอเมริกา กฎของ FTC ปี 2024 (พ.ศ. 2567) ห้ามซื้อหรือขายตัวชี้วัดอิทธิพลบนโซเชียลมีเดียปลอม เช่น ผู้ติดตามหรือยอดดูที่สร้างโดยบอต เพื่อวัตถุประสงค์เชิงพาณิชย์ เครือข่ายโฆษณาก็ห้ามทราฟฟิกปลอมไว้ในนโยบายเช่นกัน
สรุป: วัดผลจากคน ไม่ใช่แค่ตัวเลข
บอตทราฟฟิกมีอยู่เพราะกิจกรรมปลอมสร้างได้ด้วยต้นทุนต่ำและขายได้ง่าย แนวป้องกันของคุณคือการเห็นภาพชัดเจนว่าคนจริงมีพฤติกรรมอย่างไรบนเว็บไซต์ การตรวจสอบ 5 ข้อ ค่าฐานที่เชื่อถือได้ การยืนยันระดับเซิร์ฟเวอร์ และการตรวจสอบรายเดือนช่วยให้คุณเห็นภาพนั้นได้โดยไม่ต้องใช้เครื่องมือราคาแพง
เว็บในอดีตให้รางวัลกับตัวเลขสูง ๆ แต่เว็บในปัจจุบันให้รางวัลกับความน่าเชื่อถือ ทั้งเครื่องมือค้นหา ผู้ลงโฆษณา ระบบ AI และลูกค้า ล้วนตอบสนองต่อการมีส่วนร่วมจริง เมื่อคุณปกป้องข้อมูลจากบอต คุณก็ปกป้องทุกการตัดสินใจที่อาศัยข้อมูลนั้น และยังคงมุ่งความสนใจไปยังกลุ่มผู้ชมที่ซื้อ สมัคร และกลับมาอีกครั้ง นั่นคือคนจริง