Plus de la moitié de tout le trafic web est généré par des bots, selon l’article Wikipédia sur les bots informatiques. Une partie de cette automatisation permet au web de fonctionner. Les robots des moteurs de recherche indexent vos pages, et les outils de surveillance de disponibilité confirment que votre paiement se charge encore à 3 h du matin.
Une part croissante du trafic automatisé fait autre chose. Il imite les personnes, gonfle vos chiffres et épuise des budgets publicitaires destinés à de vrais clients. Juniper Research a estimé que la fraude publicitaire a coûté 88 milliards de dollars aux annonceurs en 2023, et une grande partie de cette fraude repose sur des visites et des clics automatisés.
Pour vous, en tant que spécialiste marketing, le coût le plus important reste souvent invisible. Vos budgets, vos plans de contenu et vos décisions concernant les pages de destination peuvent reposer sur des visites qu’aucun humain n’a jamais effectuées.
Ce guide explique ce qu’est un bot de trafic, pourquoi le trafic de bots existe et comment le détecter dans vos analyses et vos journaux serveur. Nous passons des définitions à une routine de détection pratique, puis à des habitudes d’audit avancées. Un principe guide l’ensemble : les moteurs de recherche et les systèmes d’IA lisent vos pages, mais l’audience qui compte est toujours composée de vraies personnes.
Qu’est-ce qu’un bot de trafic ?
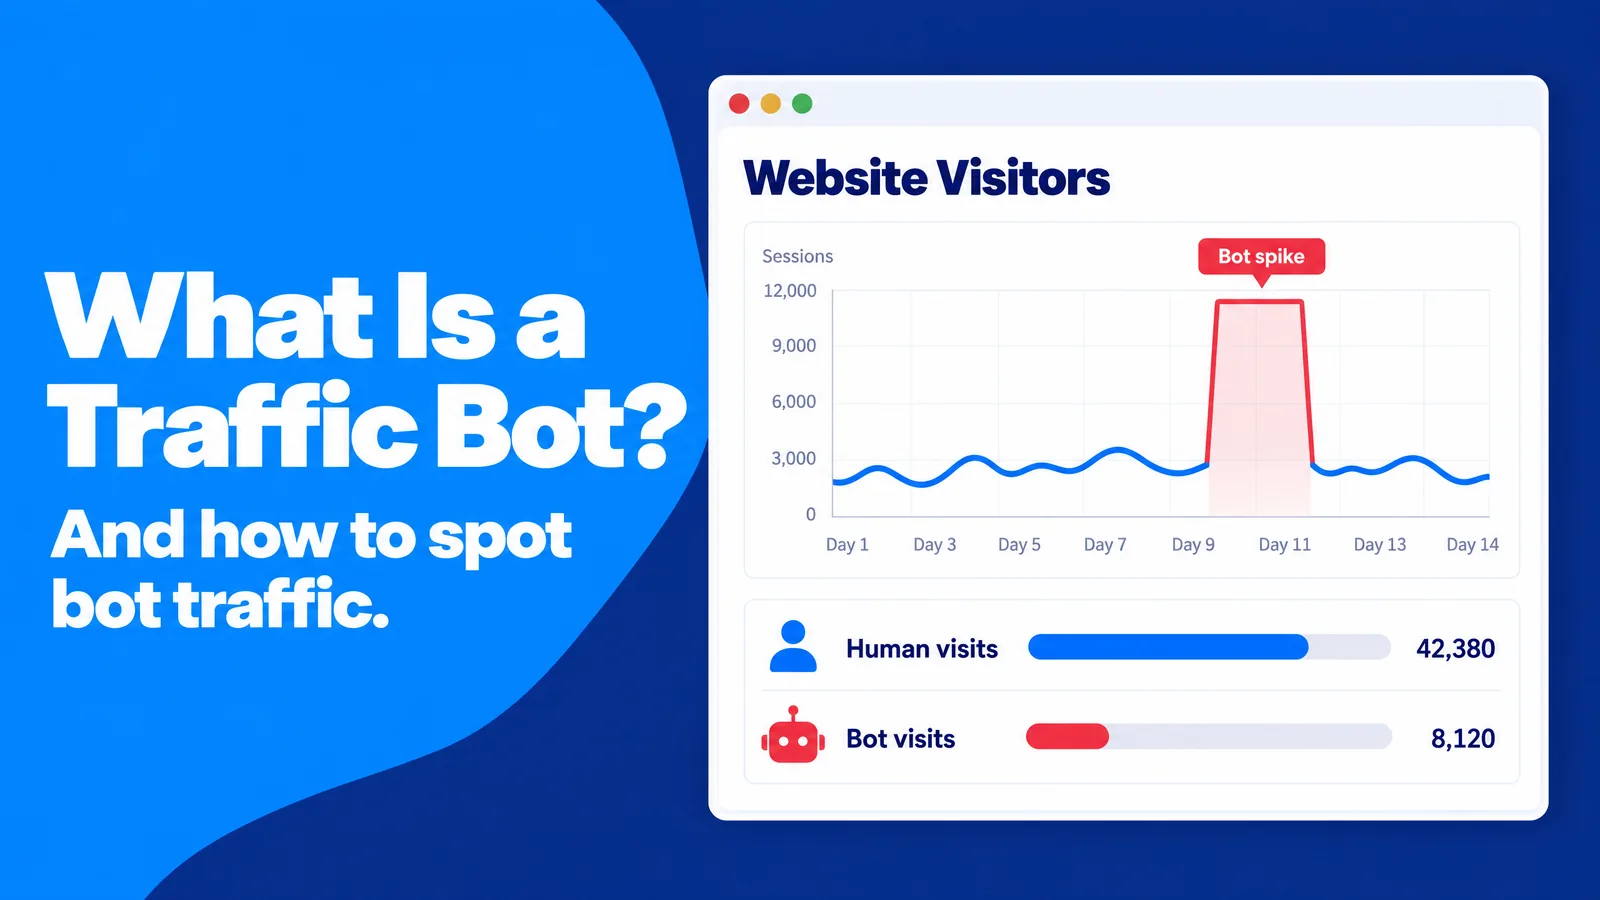
Le terme « bot de trafic » est employé de façon vague, ce qui crée de la confusion avant même le début de l’analyse. Un développeur peut l’utiliser pour désigner un script de test de charge. Un vendeur sur une place de marché de freelances peut l’utiliser pour un logiciel qui promet « 10 000 visiteurs par jour ». Une équipe de sécurité peut l’utiliser pour tout ce qui n’est pas une personne. Lorsque trois personnes en réunion lui donnent trois sens différents, l’équipe débat des étiquettes au lieu de résoudre le problème.
Dans ce guide, un bot de trafic est un programme logiciel qui envoie des visites automatisées vers un site web, une application ou une publicité afin que l’activité semble provenir de personnes. Son objectif est généralement de gonfler une métrique telle que les pages vues, les impressions publicitaires, les clics, les vues de vidéos ou les abonnés. Un bot de trafic est un type de bot informatique, une application logicielle qui exécute des tâches automatisées sur internet.
Dans ce guide, un bot de trafic est un programme logiciel qui envoie des visites automatisées vers un site web, une application ou une publicité afin que l’activité semble provenir de personnes. Son objectif est généralement de gonfler une métrique telle que les pages vues, les impressions publicitaires, les clics, les vues de vidéos ou les abonnés. Un bot de trafic est un type de bot informatique, une application logicielle qui exécute des tâches automatisées sur internet.
Bot de trafic vs trafic de bots
Le trafic de bots est la catégorie la plus large. Il couvre chaque visite ou requête effectuée par un programme plutôt que par une personne, quelle que soit son intention. Lorsque Googlebot explore votre blog, c’est du trafic de bots. Personne ne qualifierait toutefois Googlebot de bot de trafic, car il s’annonce, respecte vos règles d’exploration et ne prétend pas être un acheteur.
Cette différence détermine votre réponse. Le trafic de bots issu d’un crawler déclaré doit être géré : vous décidez de ce à quoi il peut accéder. Les visites d’un bot de trafic doivent être détectées et exclues, car tout l’objectif d’un bot de trafic est de se fondre parmi vos visiteurs humains.
Cette différence détermine votre réponse. Le trafic de bots issu d’un crawler déclaré doit être géré : vous décidez de ce à quoi il peut accéder. Les visites d’un bot de trafic doivent être détectées et exclues, car tout l’objectif d’un bot de trafic est de se fondre parmi vos visiteurs humains.
Les bons bots, les mauvais bots et la zone grise
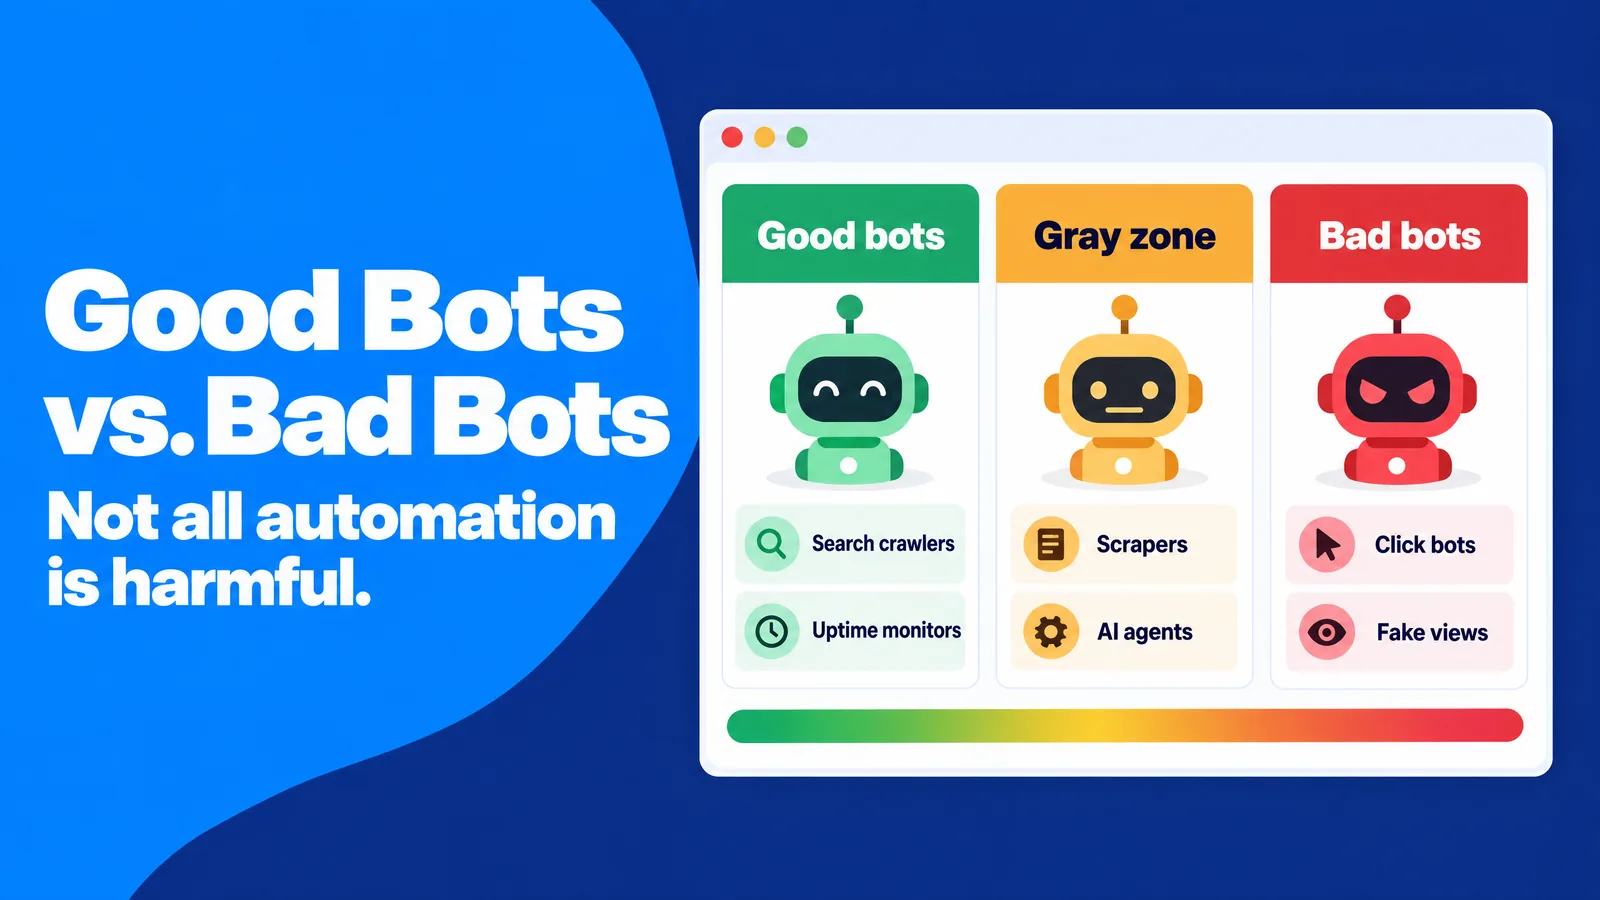
Le secteur publicitaire dispose d’un vocabulaire utile pour cela. Le Media Rating Council (MRC), l’organisme américain qui accrédite la mesure publicitaire, divise le trafic non valide en deux groupes dans ses normes relatives au trafic non valide :
- Trafic non valide général (GIVT) : les crawlers connus, le trafic des centres de données et les autres automatisations que des filtres fondés sur des listes peuvent intercepter.
- Trafic non valide sophistiqué (SIVT) : les bots qui imitent le comportement humain, les appareils détournés, les logiciels malveillants et les activités incitées, qui exigent une analyse plus approfondie pour être identifiés.
Entre ce qui est clairement bon et clairement mauvais se trouve une zone grise. Les scrapers de surveillance des prix, les crawlers d’outils SEO, les crawlers d’entraînement d’IA et les agents d’IA qui naviguent pour le compte d’une personne sont tous automatisés. Leur présence est souhaitable ou non selon votre modèle économique, et non selon une règle universelle.
Types courants de bots de trafic
Les bots de trafic appartiennent à quelques familles reconnaissables. Les connaître vous aide à deviner lequel vous affrontez d’après la trace qu’il laisse :
- Bots de clics cliquent sur des publicités ou des résultats de recherche pour épuiser le budget d’un concurrent ou simuler de l’engagement, une pratique appelée fraude au clic.
- Bots d’impressions chargent des publicités sur des pages factices ou déguisées afin que les annonceurs paient pour des vues que personne n’a vues.
- Les programmes d’autosurf et d’échange de trafic font tourner des pages entre membres afin que chaque site enregistre des « visites » que personne ne lit.
- Bots de spam de référent placent une URL dans vos rapports de référence pour vous inciter à la visiter, une tactique appelée spam de référent.
- Navigateurs headless sont des navigateurs complets sans écran. Les développeurs les utilisent pour les tests, et des fraudeurs les ont détournés pour gonfler les impressions publicitaires.
- Fermes à clics emploient des personnes peu rémunérées plutôt que du code. Les visiteurs sont techniquement humains, mais l’intention est factice. Les normes de mesure traitent donc cette activité comme non valide.
Étape pratique : Commencez utilement par un inventaire sur une page des automatisations que vous invitez. Listez vos crawlers de recherche, vos moniteurs de disponibilité, vos crawlers SEO, vos webhooks de paiement et les assistants d’IA dont vous souhaitez obtenir des citations, avec le user agent déclaré par chacun. Cette démarche fonctionne car beaucoup de fausses alertes proviennent de vos propres outils : une exploration SEO programmée à 3 h du matin ressemble exactement à un pic nocturne suspect jusqu’à ce que vous vérifiiez l’inventaire.
Pourquoi les vrais visiteurs laissent une empreinte reconnaissable
La plupart des conseils sur le trafic de bots commencent par ce qui semble anormal. Un point de départ plus fiable consiste à comprendre ce qui est normal, car vous ne pouvez pas évaluer une anomalie sans référence.
Les visiteurs humains sont merveilleusement incohérents. Une personne lit votre page de tarifs sur son téléphone pendant un trajet pendant 40 secondes. Une autre laisse un onglet de bureau ouvert pendant 12 minutes, et une troisième part après deux secondes parce qu’elle a touché le mauvais résultat.
Cette variabilité est le signal le plus fort dont vous disposez. Chaque visite humaine comporte des dizaines de petites variations : taille d’écran, version du navigateur, fuseau horaire, vitesse de défilement, pause avant un clic. Le trafic automatisé peine à reproduire toute cette diversité à grande échelle, car chaque nouvelle variation coûte du temps d’ingénierie et de l’infrastructure à l’opérateur du bot. Un réseau de bots peut simuler une ou deux dimensions de façon convaincante, mais les simuler toutes en même temps, sur des milliers de sessions, coûte cher.
SparkTraffic, une plateforme publicitaire qui diffuse depuis 2015 des visites de sites web géociblées via des publicités sur les sites d’éditeurs partenaires, s’appuie sur ce principe de diversité dans un test à cinq vérifications qu’elle publie pour ses propres annonceurs. Le raisonnement est simple : toute personne qui paie pour des visites devrait pouvoir confirmer, avec des analyses standard et sans outils particuliers, que ces visites se comportent comme des personnes. Les mêmes vérifications fonctionnent pour toute source, payante ou organique, ce qui en fait une bonne référence générale pour vos propres rapports.
Le test de l’empreinte humaine en cinq vérifications
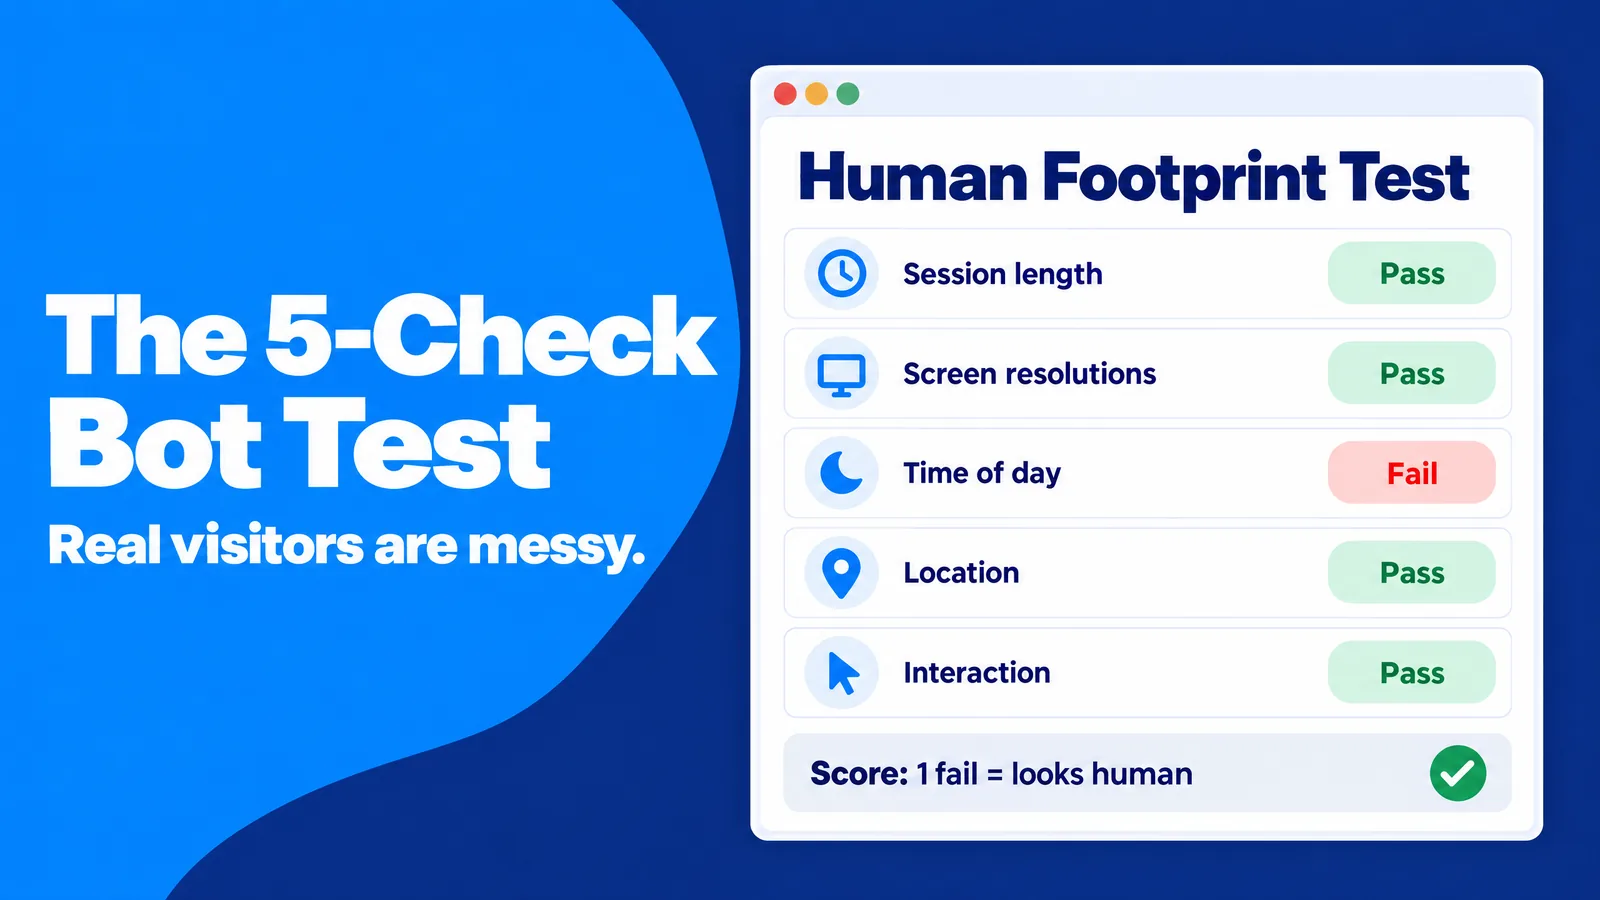
Chaque vérification compare une dimension du comportement à la diversité que vous attendez de vraies personnes. Les seuils sont volontairement souples afin que de petits échantillons et des fluctuations normales ne déclenchent pas de fausses alertes :
- Durée de session : un trafic sain s’étend de moins de 10 secondes à plus de deux minutes. Un signe d’alerte est que plus de la moitié des sessions se situent dans la même plage de cinq secondes.
- Résolutions d’écran : un trafic sain affiche de nombreuses résolutions différentes. Un signe d’alerte est qu’une résolution représente plus de la moitié des sessions.
- Heure de la journée : un trafic sain suit les rythmes diurnes locaux. Un signe d’alerte est que le volume local de 1 h à 5 h du matin égale celui de la journée.
- Emplacement : un trafic ciblé sain envoie plus de 90 % des visites depuis la zone ciblée. Un signe d’alerte est que plus de 10 % arrivent d’endroits que vous n’avez pas ciblés.
- Interaction : un trafic sain inclut des défilements, clics ou débuts de formulaire. Un signe d’alerte est zéro interaction sur 300 sessions.
Zéro ou une vérification échouée suggère que le trafic se comporte comme des personnes. Deux échecs ou plus justifient de suspendre la source, d’exporter environ 20 sessions comme preuves et de demander un examen au fournisseur. Cette notation fonctionne car une métrique étrange isolée a souvent une cause innocente, comme une campagne réservée au mobile qui réduit les tailles d’écran, tandis que plusieurs échecs simultanés sont rarement anodins.
Créez votre propre référence humaine
Les seuils génériques sont un point de départ, pas un verdict. Un blog de recettes, un site de documentation SaaS et un dentiste local ont tous des durées de session et des rythmes quotidiens différents. Une durée moyenne de session de cinq minutes peut être suspecte sur une page de localisation de magasin et parfaitement normale dans un long tutoriel.
Étape pratique : La référence la plus fiable est un canal auquel vous faites déjà confiance, comme les clics d’une newsletter ou les clients connectés. Enregistrer sa distribution sur les cinq dimensions ci-dessus pendant 30 jours vous donne une référence, et toute nouvelle source qui semble étrange peut être comparée à elle plutôt qu’à une moyenne du secteur. Cette méthode fonctionne car votre canal de confiance reflète déjà votre audience, vos appareils et vos fuseaux horaires, donc un écart important pointe vers la source plutôt que vers votre site.
Étape pratique : La référence la plus fiable est un canal auquel vous faites déjà confiance, comme les clics d’une newsletter ou les clients connectés. Enregistrer sa distribution sur les cinq dimensions ci-dessus pendant 30 jours vous donne une référence, et toute nouvelle source qui semble étrange peut être comparée à elle plutôt qu’à une moyenne du secteur. Cette méthode fonctionne car votre canal de confiance reflète déjà votre audience, vos appareils et vos fuseaux horaires, donc un écart important pointe vers la source plutôt que vers votre site.
Pourquoi les bots de trafic existent et ce qu’ils vous coûtent
Les bots de trafic existent parce que quelqu’un tire profit d’une activité factice. Le profit peut être direct, comme dans la fraude publicitaire, ou indirect, comme chez un fournisseur qui vend du « trafic » pour donner à un tableau de bord une apparence d’activité. Comprendre le motif vous aide à prévoir le schéma : un fraudeur veut des impressions et des clics, un vendeur de métriques de vanité veut des pages vues, et un spammeur veut votre attention.
La fraude publicitaire à l’échelle industrielle
L’exemple le mieux documenté est Methbot. Selon le ministère de la Justice des États-Unis, l’opération a utilisé plus de 1 900 serveurs et plus de 650 000 adresses IP pour charger des publicités sur plus de 5 000 sites web usurpés, récoltant plus de 7 millions de dollars. Un système associé, 3ve, a fonctionné sur environ 1,7 million d’ordinateurs infectés et a rapporté plus de 29 millions de dollars.
Les bots étaient conçus pour paraître humains. L’annonce de condamnation du DOJ décrit des bots qui simulaient des mouvements de souris, le défilement et des connexions à des réseaux sociaux, et l’opérateur principal a reçu une peine de prison de 10 ans. La leçon pour les spécialistes marketing est qu’un « engagement réaliste » ne prouve rien à lui seul, car Methbot a été conçu pour produire exactement cela.
Les bots étaient conçus pour paraître humains. L’annonce de condamnation du DOJ décrit des bots qui simulaient des mouvements de souris, le défilement et des connexions à des réseaux sociaux, et l’opérateur principal a reçu une peine de prison de 10 ans. La leçon pour les spécialistes marketing est qu’un « engagement réaliste » ne prouve rien à lui seul, car Methbot a été conçu pour produire exactement cela.
Fausse popularité et métriques de vanité
Un deuxième motif est l’apparence de popularité. Certains fournisseurs vendent des logiciels de bots de trafic ou des « packs de visiteurs » qui gonflent les pages vues, les vues de vidéos ou le nombre d’abonnés. Aux débuts du web, les compteurs de visites brutes impressionnaient les gens, et les chiffres gonflés procuraient un avantage à court terme. Aujourd’hui, les moteurs de recherche, les annonceurs et les investisseurs regardent l’engagement, les conversions et les revenus. Le faux volume ne rapporte donc rien et contamine les données dont vous avez besoin.
Les autorités de réglementation considèrent désormais la fausse popularité comme une tromperie. En août 2024, la Federal Trade Commission américaine a finalisé une règle qui interdit de vendre ou d’acheter de faux indicateurs d’influence sur les réseaux sociaux, tels que des abonnés ou des vues générés par des bots. L’interdiction s’applique lorsque l’acheteur savait ou aurait dû savoir que ces indicateurs étaient faux et les utilisait à des fins commerciales. Les politiques publicitaires de Google interdisent également de promouvoir des services qui vendent des activités utilisateur falsifiées, comme les clics non valides.
Les autorités de réglementation considèrent désormais la fausse popularité comme une tromperie. En août 2024, la Federal Trade Commission américaine a finalisé une règle qui interdit de vendre ou d’acheter de faux indicateurs d’influence sur les réseaux sociaux, tels que des abonnés ou des vues générés par des bots. L’interdiction s’applique lorsque l’acheteur savait ou aurait dû savoir que ces indicateurs étaient faux et les utilisait à des fins commerciales. Les politiques publicitaires de Google interdisent également de promouvoir des services qui vendent des activités utilisateur falsifiées, comme les clics non valides.
Spam de référent et trafic fantôme
Un troisième motif est l’attention. Les bots de spam de référent visitent votre site, ou envoient directement des données vers votre propriété d’analyse, avec une URL de référence factice. Lorsque vous voyez un domaine inconnu dans votre rapport de références, la curiosité fait le reste et le spammeur obtient une visite ou une vente. L’article Wikipédia sur le spam de référent explique comment cette tactique est passée des journaux serveur aux outils d’analyse.
Le vrai coût : des décisions fondées sur de fausses données
Le coût direct du trafic de bots est constitué des dépenses publicitaires gâchées et de la charge serveur. Le coût indirect est généralement plus important. Imaginez un test A/B dans lequel la variante B reçoit 600 sessions de bots supplémentaires avec zéro conversion : le taux de conversion de B chute, vous conservez la page la moins performante et personne ne découvre jamais pourquoi. Ou imaginez une équipe de contenu qui redouble d’efforts sur un sujet parce qu’un scraper a exploré ces articles toutes les heures.
Étape pratique : Une estimation du coût de contamination rend le problème concret. Multipliez la part des sessions qui ont échoué à deux vérifications ou plus par vos dépenses médias payantes du trimestre. Listez ensuite chaque décision, comme les déplacements de budget, les gagnants de tests et les priorités de contenu, qui s’est appuyée sur ces rapports. Cette démarche transforme un problème abstrait de qualité des données en montant budgétaire, ce qui facilite grandement l’obtention du temps et des outils nécessaires.
Étape pratique : Une estimation du coût de contamination rend le problème concret. Multipliez la part des sessions qui ont échoué à deux vérifications ou plus par vos dépenses médias payantes du trimestre. Listez ensuite chaque décision, comme les déplacements de budget, les gagnants de tests et les priorités de contenu, qui s’est appuyée sur ces rapports. Cette démarche transforme un problème abstrait de qualité des données en montant budgétaire, ce qui facilite grandement l’obtention du temps et des outils nécessaires.
Comment détecter le trafic de bots dans Google Analytics 4
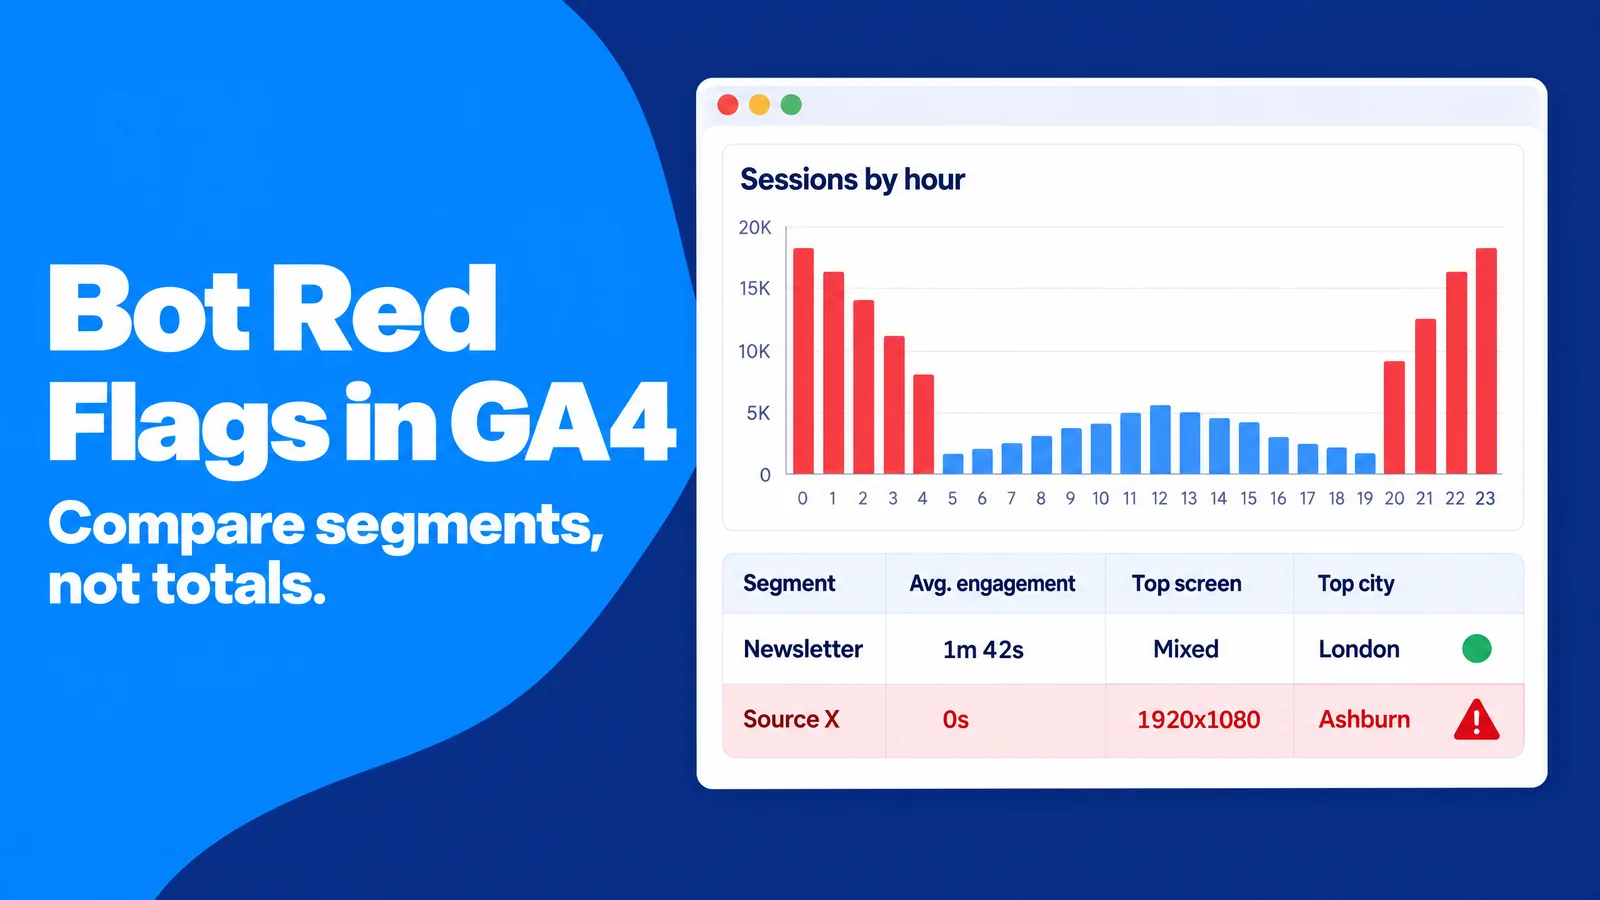
Google Analytics 4 (GA4) exclut déjà automatiquement les bots connus, grâce aux propres recherches de Google et à la liste internationale IAB/ABC des spiders et bots. Vous ne pouvez pas désactiver cette fonction et vous ne pouvez pas savoir quelle part de trafic elle a supprimée. Cela paraît rassurant, mais cela signifie que les bots restant dans vos rapports sont, par définition, ceux qui ne figurent sur aucune liste. C’est à vous de détecter le trafic de bots au-delà de cette liste.
La bonne nouvelle est que les bots inconnus laissent encore des schémas. Ils arrivent souvent par rafales, utilisent un ensemble réduit d’appareils, ignorent vos parcours de conversion et se regroupent dans des lieux où vos clients ne vivent pas. Vous identifiez le trafic de bots en comparant des segments, pas en fixant les totaux.
La bonne nouvelle est que les bots inconnus laissent encore des schémas. Ils arrivent souvent par rafales, utilisent un ensemble réduit d’appareils, ignorent vos parcours de conversion et se regroupent dans des lieux où vos clients ne vivent pas. Vous identifiez le trafic de bots en comparant des segments, pas en fixant les totaux.
Commencez par la forme du pic
Les pics de trafic naturels ont une cause et une forme. Une newsletter, une publication sociale ou une mention dans la presse produit une forte hausse suivie d’un déclin progressif sur des heures ou des jours, et les conversions augmentent avec elle. Les pics de bots sont souvent différents : des plateaux à sommet plat, des débuts et des arrêts à des heures rondes, et des sessions qui montent pendant que les événements clés restent stables.
Lorsqu’un pic apparaît, la première question est : « que s’est-il passé à ce moment-là ? » Si aucune campagne, mention ou période saisonnière ne l’explique, il vaut mieux le considérer comme non vérifié jusqu’à ce que la comparaison de segments ci-dessous démontre le contraire.
Lorsqu’un pic apparaît, la première question est : « que s’est-il passé à ce moment-là ? » Si aucune campagne, mention ou période saisonnière ne l’explique, il vaut mieux le considérer comme non vérifié jusqu’à ce que la comparaison de segments ci-dessous démontre le contraire.
Huit signaux d’alerte dans vos rapports
Ces schémas méritent d’être vérifiés dès qu’une source ou une page de destination semble inhabituelle :
- Temps d’engagement proche de zéro : de nombreuses sessions avec presque aucun temps d’engagement, ou des durées regroupées dans les mêmes quelques secondes.
- Pics Direct ou Non attribué : croissance soudaine du trafic Direct ou Non attribué vers une page de destination qui n’est reliée à rien d’évident.
- Noms d’hôte inconnus : des accès enregistrés sur des domaines qui ne vous appartiennent pas, ce qui arrive lorsque quelqu’un copie votre identifiant de mesure sur un autre site.
- Un seul profil d’appareil : une seule résolution d’écran, version de navigateur ou système d’exploitation domine une source.
- Emplacements de centres de données : des regroupements dans des villes connues pour leurs fermes de serveurs, comme Ashburn, Virginie, plutôt que là où vivent vos clients.
- Trafic de nuit : un volume local de 1 h à 5 h du matin égal au volume de la journée.
- Référents étranges : des domaines inconnus, surtout ceux qui font la publicité de services SEO ou de trafic.
- Conversions stables : les sessions augmentent tandis que les inscriptions, achats ou prospects qualifiés restent stables, ou des soumissions de formulaire remplies de charabia.
Créez une exploration d’investigation des bots
La section Explorer de GA4 vous permet de créer un rapport réutilisable pour ce travail. Une exploration libre avec les bonnes dimensions répond à la plupart des questions en quelques minutes, et un modèle enregistré évite de repartir de zéro lors de la prochaine enquête :
- Configuration : une exploration libre avec les dimensions source / support de la session, page de destination, nom d’hôte, résolution d’écran, ville et heure.
- Métriques : sessions, sessions avec engagement, temps d’engagement moyen par session et événements clés.
- Segments : un pour la source suspecte et un pour votre canal de référence de confiance.
- Comparaison : les deux segments côte à côte, dimension par dimension, en utilisant les cinq vérifications comme guide.
- Preuves : une exportation d’environ 20 sessions suspectes avec leurs attributs, prête à être partagée avec un fournisseur ou une plateforme publicitaire.
Cette approche fonctionne parce que les bots échouent rarement sur une seule dimension isolée. Les segments côte à côte révèlent en même temps le profil d’appareil étroit, les heures étranges et les conversions absentes. Notre guide sur l’utilisation des analyses pour améliorer votre trafic web couvre les rapports GA4 essentiels, et le guide sur l’attribution du trafic IA explique comment lire le trafic Direct sans tirer de conclusions hâtives.
Utilisez les filtres de données GA4 avec prudence
Les filtres de données sont le principal moyen d’exclure le trafic de bots dans GA4 une fois que vous savez d’où il vient. Ils peuvent supprimer le trafic interne, le trafic des développeurs et, plus récemment, les accès provenant de noms d’hôte qui ne vous appartiennent pas. Un filtre de nom d’hôte incluant uniquement vos propres domaines est une solution propre pour les identifiants de mesure copiés sur d’autres sites. Les filtres sont puissants mais impitoyables : une fois un filtre actif, les données exclues sont perdues pour de bon.
Étape pratique : L’habitude la plus sûre consiste à exécuter chaque nouveau filtre en mode Test pendant au moins une semaine et à comparer les résultats filtrés et non filtrés avant de l’activer. Cela vous protège de la suppression de véritables données clients à cause d’une faute de frappe dans un nom de domaine ou d’une règle trop large.
Étape pratique : L’habitude la plus sûre consiste à exécuter chaque nouveau filtre en mode Test pendant au moins une semaine et à comparer les résultats filtrés et non filtrés avant de l’activer. Cela vous protège de la suppression de véritables données clients à cause d’une faute de frappe dans un nom de domaine ou d’une règle trop large.
Comment vérifier les bots au niveau du serveur
Les outils d’analyse ne voient que les visiteurs qui exécutent votre code de suivi. De nombreux bots n’exécutent jamais JavaScript, ils n’apparaissent donc jamais dans GA4, mais ils consomment tout de même de la bande passante, récupèrent du contenu et sondent les formulaires de connexion. Vos journaux serveur, journaux CDN ou tableau de bord d’hébergement affichent chaque requête, ce qui en fait l’endroit où confirmer qui visite réellement votre site.
Pourquoi les user agents ne prouvent rien
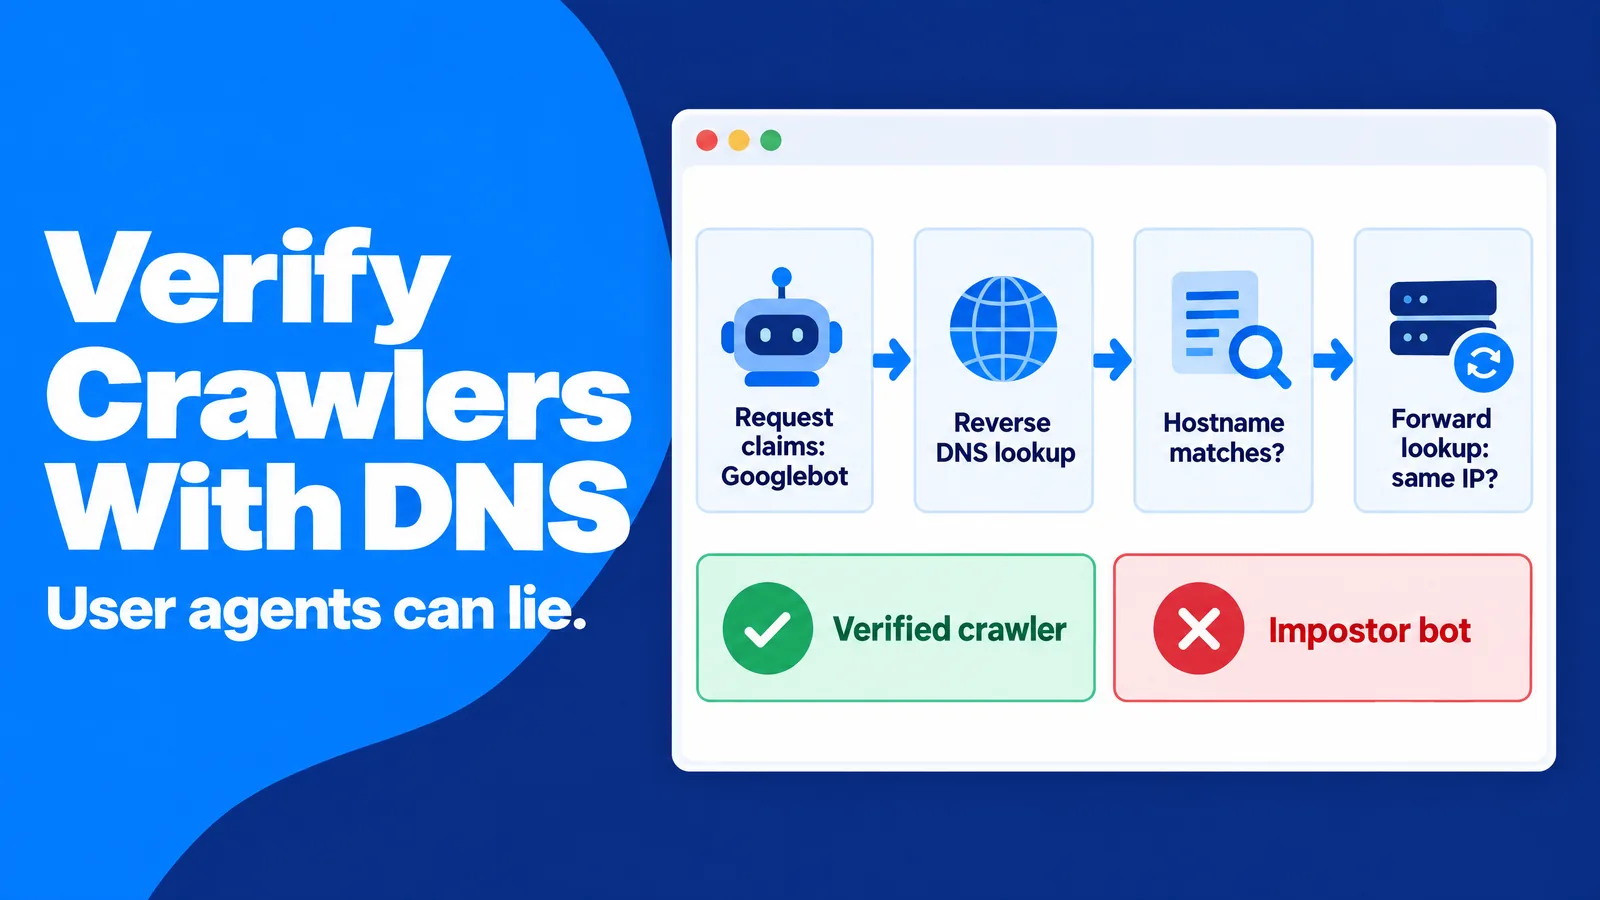
Chaque requête contient une chaîne user agent qui indique le navigateur ou le bot. Le problème est que le visiteur l’écrit lui-même. Un scraper peut prétendre être Googlebot, Chrome sur un iPhone ou n’importe quoi d’autre avec une ligne de code. Considérer le user agent comme une identité revient donc à accepter un badge nominatif comme passeport.
Confirmez les crawlers avec le forward-confirmed reverse DNS
La méthode standard pour vérifier un crawler qui s’auto-déclare est le forward-confirmed reverse DNS. Elle exige deux recherches. Une recherche DNS inversée sur l’adresse IP du visiteur renvoie un nom d’hôte, qui doit appartenir au domaine de l’opérateur déclaré. Une recherche directe sur ce nom d’hôte doit ensuite renvoyer la même adresse IP. Ainsi, un faux Googlebot échoue car son adresse IP ne renvoie pas vers les domaines de Google.
Étape pratique : Un échantillon mensuel de journaux rend cette tâche gérable. Relever les 20 user agents ayant effectué le plus de requêtes et vérifier ceux qui prétendent être un moteur de recherche ou un grand crawler d’IA ne prend que quelques minutes. Cela fonctionne parce que les imposteurs se concentrent là où la récompense est la plus élevée : se faire passer pour un crawler de confiance est le moyen le plus simple de contourner les limites de débit et les pare-feux.
Étape pratique : Un échantillon mensuel de journaux rend cette tâche gérable. Relever les 20 user agents ayant effectué le plus de requêtes et vérifier ceux qui prétendent être un moteur de recherche ou un grand crawler d’IA ne prend que quelques minutes. Cela fonctionne parce que les imposteurs se concentrent là où la récompense est la plus élevée : se faire passer pour un crawler de confiance est le moyen le plus simple de contourner les limites de débit et les pare-feux.
robots.txt est une demande, pas un verrou
Le fichier robots.txt indique aux crawlers ce à quoi ils peuvent accéder, et son format est normalisé dans la RFC 9309. Son respect est volontaire. Les crawlers bienveillants le respectent, tandis que les bots de trafic et de nombreux scrapers l’ignorent ou changent de nom pour contourner les blocages.
robots.txt reste utile, car il sépare les bots qui respectent vos règles de ceux qui ne les respectent pas. Wikipédia note que 306 des 1 000 sites web les plus visités ont bloqué GPTBot d’OpenAI en 2023, ce qui montre que les propriétaires de sites utilisent désormais le fichier comme une déclaration de politique. Un bot qui demande des pages que vous avez interdites vous révèle quelque chose d’important sur son intention.
robots.txt reste utile, car il sépare les bots qui respectent vos règles de ceux qui ne les respectent pas. Wikipédia note que 306 des 1 000 sites web les plus visités ont bloqué GPTBot d’OpenAI en 2023, ce qui montre que les propriétaires de sites utilisent désormais le fichier comme une déclaration de politique. Un bot qui demande des pages que vous avez interdites vous révèle quelque chose d’important sur son intention.
L’identité de bot signée arrive
La solution à long terme contre l’usurpation est l’identité cryptographique. L’Internet Engineering Task Force (IETF) a mandaté un groupe de travail Web Bot Auth pour normaliser la façon dont les bots peuvent prouver leur identité, en s’appuyant sur les signatures de messages HTTP. Un bot signé joint une signature vérifiable à chaque requête, afin qu’un site web puisse confirmer son opérateur sans dépendre de listes d’adresses IP. Suivre ce travail dès maintenant vous aide à planifier quels visiteurs automatisés vous autoriserez lorsque les signatures deviendront courantes.
Comment arrêter le trafic de bots sans bloquer de vraies personnes
Bloquer les bots paraît simple jusqu’à ce que de vrais clients se retrouvent pris dans le filet. Les murs CAPTCHA agressifs frustrent les personnes utilisant des téléphones lents et créent des obstacles pour les utilisateurs de technologies d’assistance. Les blocages généralisés par pays ou centres de données peuvent exclure les voyageurs, les utilisateurs de VPN d’entreprise et les visiteurs soucieux de leur vie privée. Chaque faux positif est un prospect perdu qui n’apparaît jamais dans aucun rapport.
Une approche moderne doit aussi prendre en compte l’automatisation utile. Les assistants d’IA récupèrent de plus en plus des pages, comparent des produits et remplissent des formulaires pour le compte d’une personne. Traiter chaque requête non humaine comme hostile peut vous priver de visites demandées par un vrai client.
Une approche moderne doit aussi prendre en compte l’automatisation utile. Les assistants d’IA récupèrent de plus en plus des pages, comparent des produits et remplissent des formulaires pour le compte d’une personne. Traiter chaque requête non humaine comme hostile peut vous priver de visites demandées par un vrai client.
Adaptez la réponse au bot
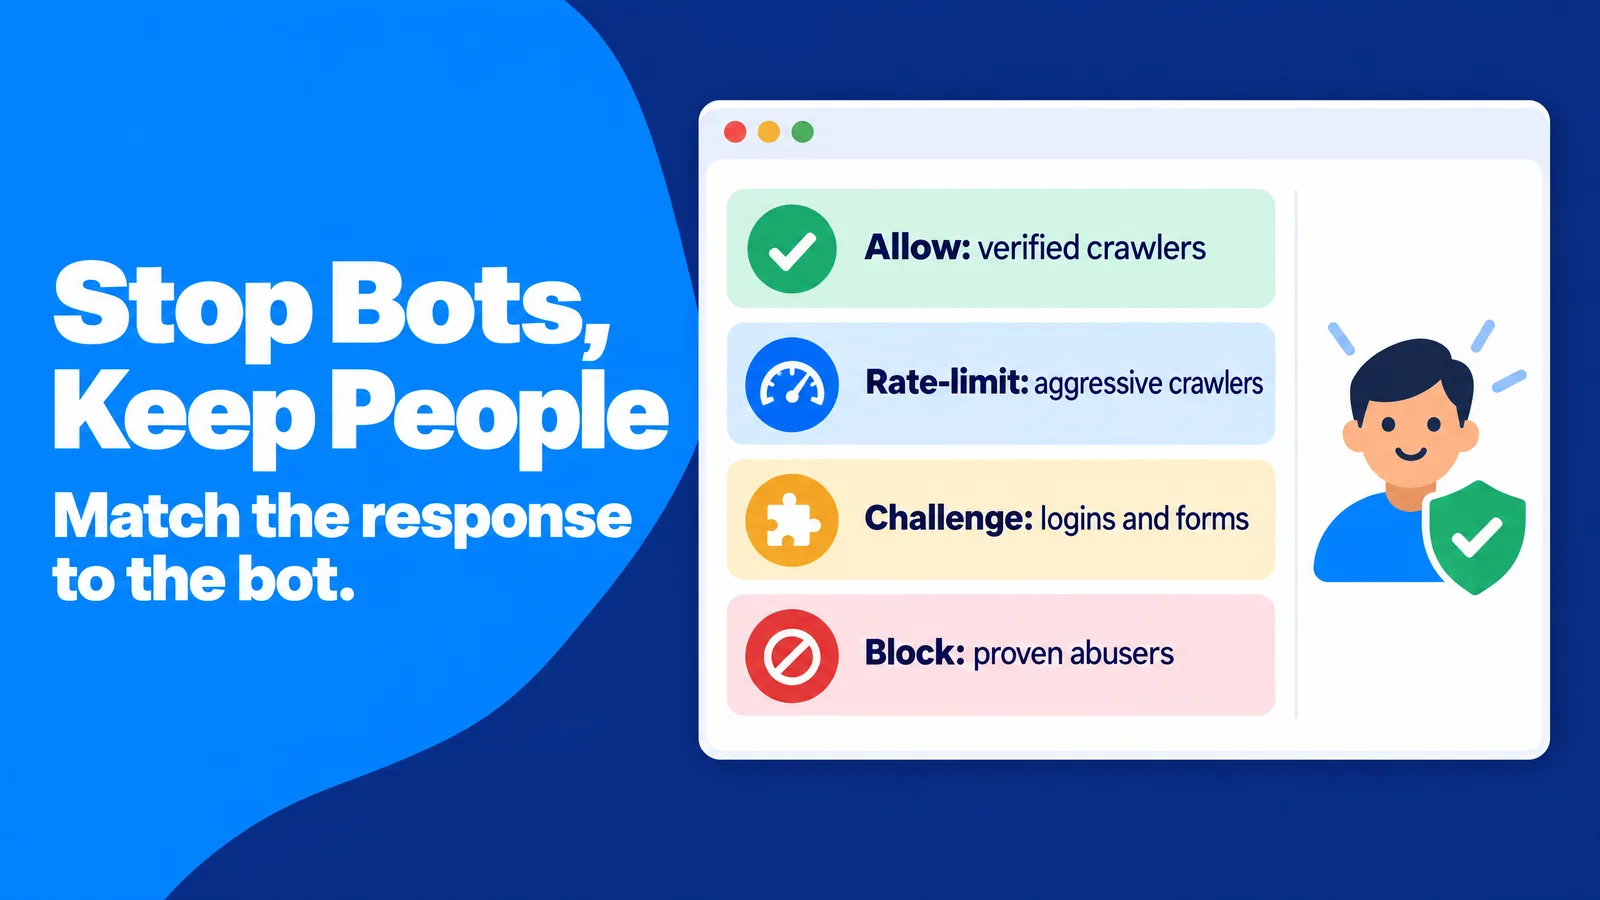
Les défenses les plus efficaces sont graduées plutôt que tout ou rien. Chaque type de visiteur automatisé reçoit la réponse la plus légère qui résout le problème :
- Crawlers vérifiés que vous souhaitez : autorisés, car ils apportent visibilité dans la recherche et citations par l’IA.
- Crawlers agressifs mais légitimes : limités en débit, ce qui protège les performances du serveur sans rien casser.
- Trafic non vérifié sur des pages sensibles : soumis à un CAPTCHA ou à un test similaire uniquement lors des connexions, inscriptions et paiements, là où le coût des abus est le plus élevé.
- Abuseurs avérés : bloqués par plage IP, réseau ou signature une fois les preuves claires.
Cette gradation fonctionne car elle concentre la friction là où les abus causent de vrais dommages et préserve la rapidité et l’ouverture du reste de votre site pour les personnes.
Protégez les formulaires, inscriptions et paiements
Les formulaires sont l’endroit où les bots causent les dommages les plus durables. Les fausses inscriptions polluent votre CRM, déclenchent des e-mails de bienvenue vers des adresses qui rebondissent et nuisent à votre réputation d’expéditeur. Les faux prospects font perdre du temps aux équipes commerciales et faussent les rapports sur le coût par prospect.
Étape pratique : Une première couche simple est un champ honeypot : un champ de formulaire masqué pour les personnes mais visible pour les bots, de sorte que toute soumission qui le remplit peut être rejetée. La validation côté serveur, les limites de débit par adresse IP et le double opt-in pour les listes e-mail ajoutent d’autres couches. Cette configuration fonctionne car chaque couche arrête un type de bot différent, tandis qu’une vraie personne ne les remarque jamais.
Étape pratique : Une première couche simple est un champ honeypot : un champ de formulaire masqué pour les personnes mais visible pour les bots, de sorte que toute soumission qui le remplit peut être rejetée. La validation côté serveur, les limites de débit par adresse IP et le double opt-in pour les listes e-mail ajoutent d’autres couches. Cette configuration fonctionne car chaque couche arrête un type de bot différent, tandis qu’une vraie personne ne les remarque jamais.
Laissez une porte ouverte aux agents d’IA qui agissent pour des personnes
Certaines visites automatisées représentent désormais une vraie demande. Un agent d’IA qui vérifie vos prix ou réserve une démo pour un utilisateur est une interaction client effectuée par logiciel. Le bloquer purement et simplement peut vous coûter une vente, tandis que le laisser passer sans examen peut fausser vos métriques d’engagement.
Le juste milieu pratique consiste à identifier ces agents séparément, à les autoriser sur les pages publiques et à les mesurer dans leur propre segment. Notre guide sur le trafic IA agentique explique comment les visites assistées par agent apparaissent dans les analyses et comment préparer vos pages à les accueillir.
Le juste milieu pratique consiste à identifier ces agents séparément, à les autoriser sur les pages publiques et à les mesurer dans leur propre segment. Notre guide sur le trafic IA agentique explique comment les visites assistées par agent apparaissent dans les analyses et comment préparer vos pages à les accueillir.
Comment préserver la propreté des campagnes de trafic payant
Le trafic payant est l’endroit où le trafic de bots nuit le plus directement à votre budget. Chaque clic ou impression non valide est de l’argent dépensé pour personne. Le risque est le plus élevé avec des inventaires bon marché et larges, ainsi qu’avec des fournisseurs incapables de dire d’où viennent leurs visites, car leur incitation est le volume, non les résultats.
Certaines offres sont des bots de trafic déguisés. Les signes d’alerte incluent des promesses de visites « indétectables » ou « réalistes », des améliorations garanties de classement dans la recherche, des visiteurs illimités pour un forfait fixe et des réseaux de proxys résidentiels présentés comme un avantage. Les plateformes publicitaires légitimes parlent plutôt de ciblage, de placements, d’examen de pages de destination et de mesure. Acheter des visites de bots se retourne toujours contre vous : ces visites ne convertissent jamais, elles corrompent vos tests, les réseaux publicitaires peuvent bannir les sites monétisés qui les reçoivent et l’achat lui-même peut enfreindre les règles de protection des consommateurs.
Certaines offres sont des bots de trafic déguisés. Les signes d’alerte incluent des promesses de visites « indétectables » ou « réalistes », des améliorations garanties de classement dans la recherche, des visiteurs illimités pour un forfait fixe et des réseaux de proxys résidentiels présentés comme un avantage. Les plateformes publicitaires légitimes parlent plutôt de ciblage, de placements, d’examen de pages de destination et de mesure. Acheter des visites de bots se retourne toujours contre vous : ces visites ne convertissent jamais, elles corrompent vos tests, les réseaux publicitaires peuvent bannir les sites monétisés qui les reçoivent et l’achat lui-même peut enfreindre les règles de protection des consommateurs.
Marquez chaque source payante
Le trafic payant non marqué se mélange aux canaux Direct et Referral, où les bots se cachent facilement. Les paramètres UTM sont des balises ajoutées à un lien qui indiquent exactement à votre outil d’analyse quelle source, campagne et quel placement ont envoyé une visite.
Étape pratique : Une règle UTM simple résout la plupart des lacunes d’attribution : chaque campagne payante reçoit ses propres valeurs de source, support et campagne, consignées dans une feuille de nommage partagée. Cette méthode fonctionne car le test à cinq vérifications exige un segment propre. Si les visites payantes sont mélangées à Direct, vous ne pouvez pas savoir quel fournisseur a envoyé les sessions suspectes.
Étape pratique : Une règle UTM simple résout la plupart des lacunes d’attribution : chaque campagne payante reçoit ses propres valeurs de source, support et campagne, consignées dans une feuille de nommage partagée. Cette méthode fonctionne car le test à cinq vérifications exige un segment propre. Si les visites payantes sont mélangées à Direct, vous ne pouvez pas savoir quel fournisseur a envoyé les sessions suspectes.
Lancez un petit test avant de passer à l’échelle
Un petit budget de test vous indique si une source se comporte comme des personnes avant d’engager de l’argent réel. Quelques centaines de sessions suffisent pour exécuter les cinq vérifications, et une semaine de données montre les rythmes quotidiens. La même discipline améliore votre travail sur les pages de destination, comme l’explique notre guide sur les tests A/B d’une page de destination avec du trafic payant.
Les formats publicitaires comptent aussi. Le trafic popunder, natif et push produit à chaque fois des schémas d’engagement différents, car un visiteur popunder ne se comporte pas comme une personne qui a choisi de cliquer sur une publicité native. Évaluer chaque format par rapport à sa propre référence évite les fausses alertes.
Les formats publicitaires comptent aussi. Le trafic popunder, natif et push produit à chaque fois des schémas d’engagement différents, car un visiteur popunder ne se comporte pas comme une personne qui a choisi de cliquer sur une publicité native. Évaluer chaque format par rapport à sa propre référence évite les fausses alertes.
Considérez les politiques de remboursement et d’avoir comme des signaux de qualité
Les plateformes réputées s’attendent à ce que vous vérifiiez leur trafic et expliquent ce qui se passe lorsqu’un élément paraît anormal. Une bonne plateforme propose un processus clair : quelles preuves elle exige, comment elle examine un rapport et si elle crédite l’activité non valide. Un fournisseur qui refuse tout examen ou affirme que son trafic est « 100 % humain » vous dit quelque chose. Même le MRC évite d’appeler « humain » un trafic filtré et préfère le mot « valide », car aucun filtre ne peut garantir que chaque visite restante provient d’une personne.
Stratégie avancée : réaliser un audit mensuel du trafic de bots
Les enquêtes ponctuelles résolvent des problèmes ponctuels. Les bots changent, les campagnes changent et vos propres outils changent. Une courte routine mensuelle détecte donc les problèmes avant qu’ils ne faussent tout un trimestre de décisions. L’objectif n’est pas d’obtenir zéro trafic de bots, ce qui est impossible. L’objectif est d’avoir un trafic de bots connu, mesuré et documenté.
Une routine mensuelle de 30 minutes
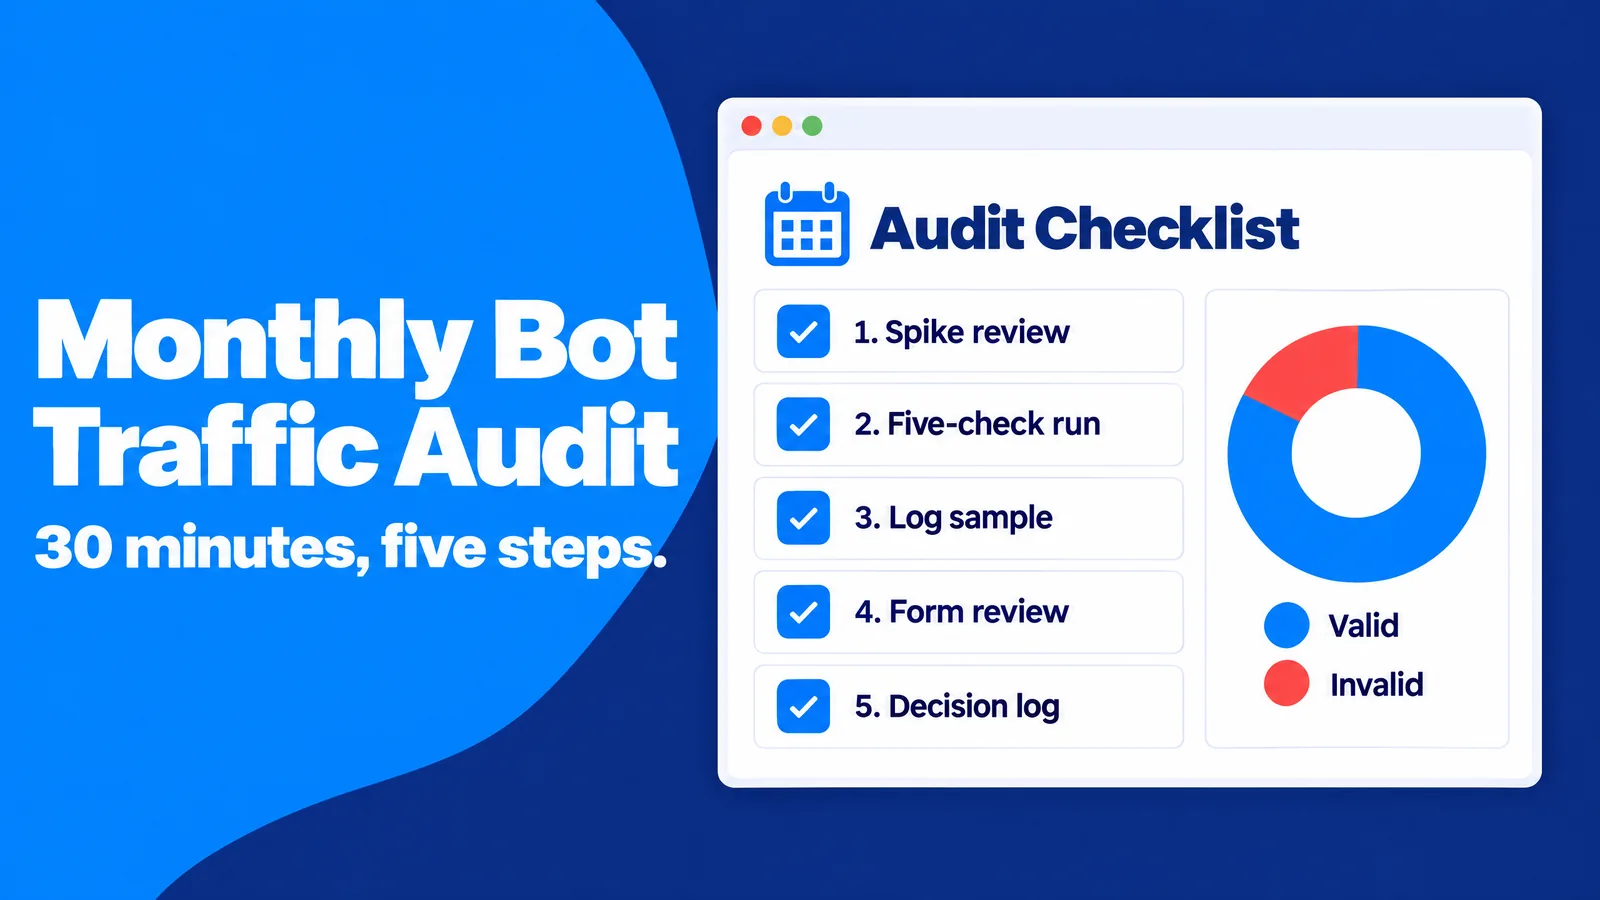
Un audit récurrent est plus efficace lorsqu’il suit les mêmes étapes à chaque fois, afin que les tendances deviennent visibles :
- Examen des pics : chaque pic de trafic du mois précédent est annoté avec sa cause ou marqué comme inexpliqué.
- Exécution des cinq vérifications : chaque source et campagne majeure est évaluée selon les cinq vérifications.
- Échantillon de journaux : les principaux crawlers déclarés sont vérifiés avec le forward-confirmed reverse DNS.
- Examen des formulaires : les inscriptions et prospects sont contrôlés pour détecter des noms identiques, des domaines e-mail jetables ou des rafales soudaines.
- Journal des décisions : un relevé de ce que vous avez filtré, bloqué ou signalé, et pourquoi.
Cette routine fonctionne car elle fait de la détection de bots une habitude avec une trace documentaire. Lorsqu’une partie prenante demande pourquoi les chiffres de mars ont changé, vous avez la réponse.
Rédigez une politique d’une page sur le trafic non valide
Même les experts peinent à définir précisément le trafic non valide. Le rapport Tuzhilin, un examen indépendant de la détection de fraude au clic de Google décrit dans l’article Wikipédia sur la fraude au clic, a conclu qu’« il n’existe aucune définition conceptuelle des clics non valides qui puisse être opérationnalisée », sauf pour les cas évidents. Si le secteur ne peut pas s’accorder sur une définition, votre équipe tire avantage d’avoir la sienne.
Étape pratique : Une politique d’une page règle à l’avance la plupart des débats. Elle indique les visiteurs automatisés que vous autorisez, les seuils qui déclenchent un examen, qui décide et comment les conclusions sont communiquées aux agences et fournisseurs. Cela fonctionne car une règle écrite remplace les débats au cas par cas et donne aux partenaires une norme claire à respecter.
Étape pratique : Une politique d’une page règle à l’avance la plupart des débats. Elle indique les visiteurs automatisés que vous autorisez, les seuils qui déclenchent un examen, qui décide et comment les conclusions sont communiquées aux agences et fournisseurs. Cela fonctionne car une règle écrite remplace les débats au cas par cas et donne aux partenaires une norme claire à respecter.
Surveillez les métriques que les bots ne peuvent pas simuler à bas coût
Les pages vues et les sessions sont bon marché à simuler. Les revenus, prospects qualifiés, achats répétés, tickets d’assistance et utilisateurs connectés qui reviennent sont coûteux ou impossibles à simuler à grande échelle. Une source de trafic qui ajoute des sessions sans jamais faire évoluer ces chiffres mérite un examen, même si son engagement semble bon.
Ancrer vos rapports sur ces métriques de résultats est la défense la plus solide à long terme. Cela aligne chaque décision de trafic sur ce que les personnes font réellement et supprime l’incitation, pour quiconque dans votre chaîne d’approvisionnement, à gonfler les chiffres.
Ancrer vos rapports sur ces métriques de résultats est la défense la plus solide à long terme. Cela aligne chaque décision de trafic sur ce que les personnes font réellement et supprime l’incitation, pour quiconque dans votre chaîne d’approvisionnement, à gonfler les chiffres.
Questions fréquentes sur les bots de trafic
Qu’est-ce qu’un bot de trafic en termes simples ?
Un bot de trafic est un logiciel qui visite automatiquement des sites web ou clique sur des publicités pour faire croire que l’activité provient de vraies personnes. Il gonfle généralement des métriques comme les pages vues, les clics, les vues de vidéos ou les abonnés.
Tout le trafic de bots est-il mauvais ?
Non. Les crawlers des moteurs de recherche, les moniteurs de disponibilité et de nombreux crawlers d’IA sont utiles. Le trafic de bots devient un problème lorsqu’il prétend être humain, gaspille des dépenses publicitaires, récupère du contenu contre vos règles ou fausse vos analyses.
Le trafic de bots peut-il nuire à mon SEO ?
Les fausses visites n’améliorent pas les classements, car les moteurs de recherche s’appuient sur de nombreux signaux de qualité plutôt que sur le nombre brut de visites. Le trafic de bots peut néanmoins nuire indirectement en ralentissant votre serveur, en copiant votre contenu et en vous poussant à optimiser les mauvaises pages à partir de données polluées.
Google Analytics 4 filtre-t-il automatiquement le trafic de bots ?
Oui. GA4 exclut automatiquement les bots et spiders connus, et vous ne pouvez ni désactiver cette fonction ni voir quelle part il a supprimée. Des bots inconnus et sophistiqués peuvent toujours atteindre vos rapports. Les comparaisons de segments et les cinq vérifications restent donc nécessaires.
Quelle quantité de trafic de bots est normale ?
Il n’existe pas de chiffre universel. Plus de la moitié de tout le trafic web est automatisée, mais la majeure partie n’exécute jamais votre code d’analyse. Une référence pratique est votre propre canal de confiance : les sources qui s’en écartent fortement méritent un examen plus attentif.
Comment arrêter le trafic de bots sur mon site web ?
L’approche la plus efficace est graduée. Les crawlers vérifiés sont autorisés, les crawlers agressifs sont limités en débit, le trafic non vérifié n’est soumis à un test que lors des connexions et dans les formulaires, et les abuseurs avérés sont bloqués. Les champs honeypot, la validation côté serveur et les filtres GA4 de noms d’hôte et de trafic interne préservent la propreté de vos formulaires comme de vos rapports.
Comment savoir si le trafic de mon site web provient de bots ?
Le moyen le plus rapide consiste à comparer une source suspecte à un canal auquel vous faites confiance selon cinq dimensions : durée de session, résolutions d’écran, heure de la journée, emplacement et interaction. Deux échecs clairs ou plus, comme des durées de session identiques et un volume nocturne égal au volume diurne, suggèrent fortement un trafic automatisé. Les journaux serveur et le forward-confirmed reverse DNS confirment ensuite si les crawlers qui s’auto-déclarent sont authentiques.
Est-il légal d’acheter du trafic de bots ?
Les règles varient selon les pays, mais acheter un faux engagement à des fins commerciales comporte de réels risques juridiques et commerciaux. Aux États-Unis, la règle de 2024 de la FTC interdit d’acheter ou de vendre de faux indicateurs d’influence sur les réseaux sociaux, tels que des abonnés ou vues générés par des bots, à des fins commerciales. Les réseaux publicitaires interdisent également le faux trafic dans leurs politiques.
Conclusion : mesurez pour les personnes, pas pour les compteurs
Les bots de trafic existent parce que l’activité factice est peu coûteuse à produire et facile à vendre. Votre défense consiste à avoir une vision claire de l’apparence des vraies personnes sur votre site. Les cinq vérifications, une référence de confiance, la vérification au niveau du serveur et un audit mensuel vous donnent cette vision sans outils coûteux.
L’ancien web récompensait les grands chiffres. Le web actuel récompense la confiance : moteurs de recherche, annonceurs, systèmes d’IA et clients répondent tous à un engagement authentique. Lorsque vous protégez vos données des bots, vous protégez chaque décision qui en dépend et maintenez votre attention sur l’audience qui achète, s’abonne et revient : de vraies personnes.
L’ancien web récompensait les grands chiffres. Le web actuel récompense la confiance : moteurs de recherche, annonceurs, systèmes d’IA et clients répondent tous à un engagement authentique. Lorsque vous protégez vos données des bots, vous protégez chaque décision qui en dépend et maintenez votre attention sur l’audience qui achète, s’abonne et revient : de vraies personnes.