ตามบทสรุปเรื่องอินเทอร์เน็ตบอตของ Wikipedia ทราฟฟิกเว็บมากกว่าครึ่งหนึ่งเกิดจากบอต ระบบอัตโนมัติส่วนหนึ่งช่วยให้เว็บทำงานต่อไปได้ โปรแกรมรวบรวมข้อมูลของเสิร์ชเอนจินจัดทำดัชนีหน้าเว็บของคุณ และเครื่องมือตรวจสอบสถานะยืนยันว่าหน้าชำระเงินยังโหลดได้ในเวลา 3.00 น.
แต่ทราฟฟิกอัตโนมัติที่เพิ่มขึ้นอีกส่วนทำอย่างอื่น มันเลียนแบบผู้คน ทำให้ตัวเลขของคุณสูงเกินจริง และใช้งบโฆษณาที่ควรมีไว้สำหรับลูกค้าจริง Juniper Research ประเมินว่าการฉ้อโกงโฆษณาทำให้ผู้ลงโฆษณาเสียหาย 88 พันล้านดอลลาร์ในปี 2023 และการฉ้อโกงส่วนใหญ่เกิดผ่านการเข้าชมและการคลิกอัตโนมัติ
สำหรับคุณในฐานะนักการตลาด ต้นทุนที่มากกว่ามักมองไม่เห็น งบประมาณ แผนคอนเทนต์ และการตัดสินใจเกี่ยวกับหน้า Landing Page อาจตั้งอยู่บนการเข้าชมที่ไม่เคยเกิดจากมนุษย์เลย
คู่มือนี้อธิบายว่าบอททราฟฟิกคืออะไร เหตุใดทราฟฟิกจากบอทจึงมีอยู่ และวิธีตรวจจับบอทในข้อมูลวิเคราะห์และบันทึกเซิร์ฟเวอร์ของคุณ เราจะเริ่มจากคำนิยาม ไปสู่ขั้นตอนตรวจจับที่ใช้งานได้จริง แล้วต่อด้วยแนวทางตรวจสอบเชิงลึก หลักการหนึ่งที่ใช้ตลอดบทความคือ เสิร์ชเอนจินและระบบ AI อ่านหน้าเว็บของคุณได้ แต่กลุ่มเป้าหมายที่สำคัญที่สุดคือผู้คนจริงเสมอ
บอททราฟฟิกคืออะไร
คำว่า “บอททราฟฟิก” ถูกใช้ค่อนข้างกว้าง จึงทำให้เกิดความสับสนก่อนเริ่มวิเคราะห์ นักพัฒนาอาจใช้คำนี้กับสคริปต์ทดสอบโหลด ผู้ขายบนแพลตฟอร์มฟรีแลนซ์อาจใช้กับซอฟต์แวร์ที่สัญญาว่า “ผู้เข้าชม 10,000 คนต่อวัน” ทีมรักษาความปลอดภัยอาจใช้กับทุกสิ่งที่ไม่ใช่คน และเมื่อคนสามคนในที่ประชุมหมายถึงคนละอย่าง ทีมก็จะถกเถียงเรื่องคำเรียกแทนที่จะแก้ปัญหา
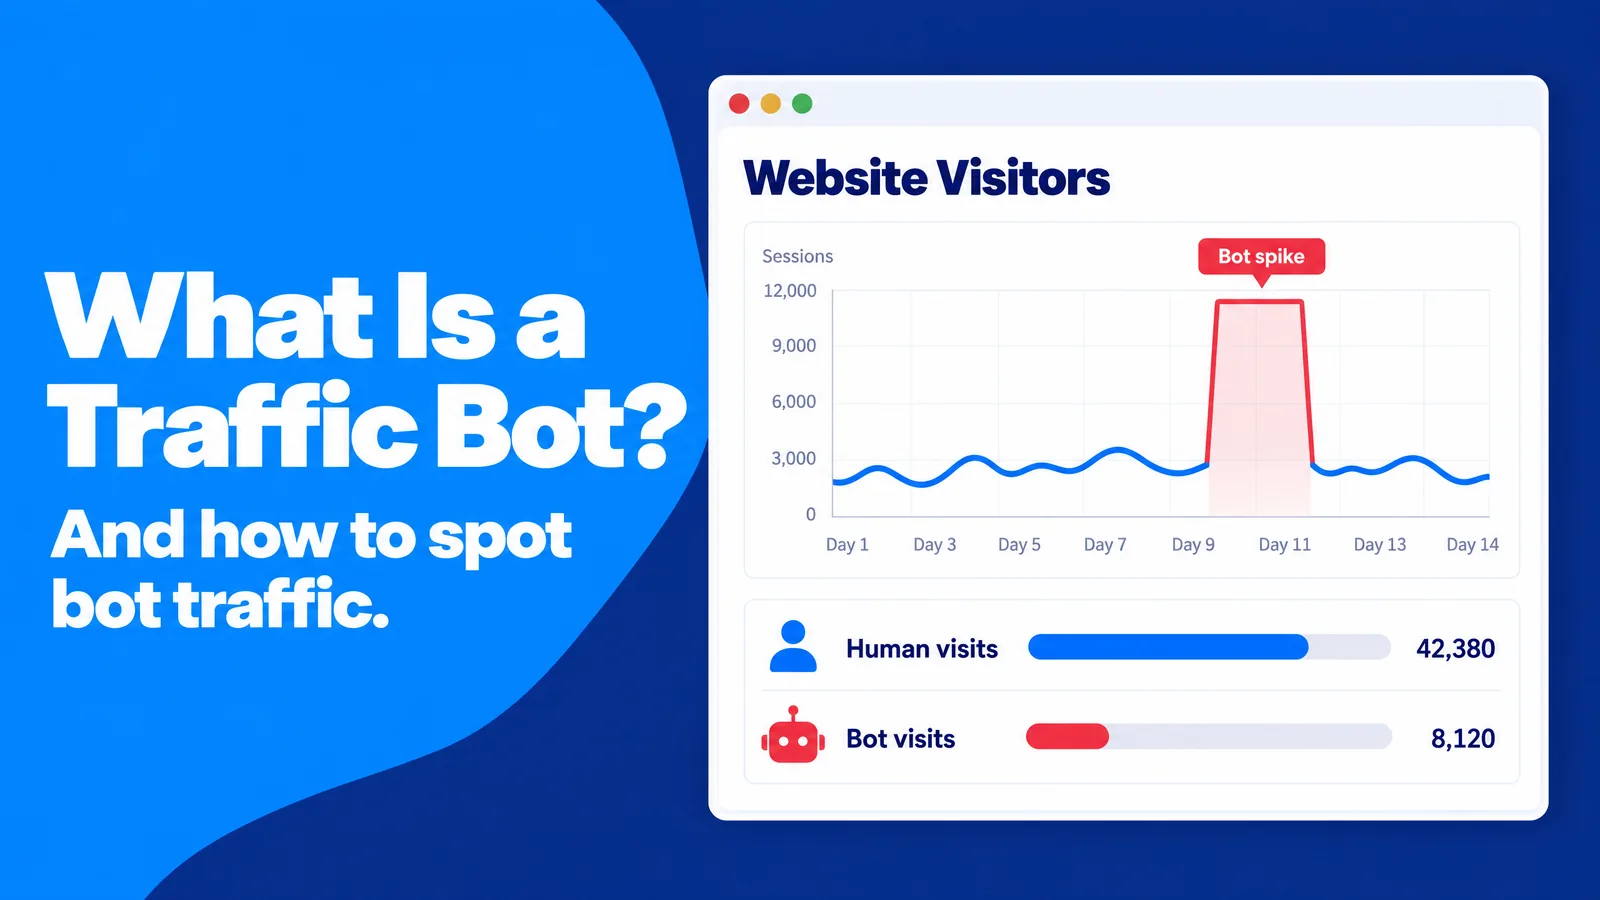
ในคู่มือนี้ บอททราฟฟิกคือโปรแกรมซอฟต์แวร์ที่ส่งการเข้าชมแบบอัตโนมัติไปยังเว็บไซต์ แอป หรือโฆษณา เพื่อให้กิจกรรมดูเหมือนมาจากผู้คน จุดประสงค์มักเพื่อปั่นตัวชี้วัด เช่น การดูหน้าเว็บ การแสดงโฆษณา การคลิก การดูวิดีโอ หรือจำนวนผู้ติดตาม บอททราฟฟิกเป็นบอตอินเทอร์เน็ตประเภทหนึ่ง บอตอินเทอร์เน็ต คือแอปพลิเคชันซอฟต์แวร์ที่ทำงานอัตโนมัติบนอินเทอร์เน็ต
ในคู่มือนี้ บอททราฟฟิกคือโปรแกรมซอฟต์แวร์ที่ส่งการเข้าชมแบบอัตโนมัติไปยังเว็บไซต์ แอป หรือโฆษณา เพื่อให้กิจกรรมดูเหมือนมาจากผู้คน จุดประสงค์มักเพื่อปั่นตัวชี้วัด เช่น การดูหน้าเว็บ การแสดงโฆษณา การคลิก การดูวิดีโอ หรือจำนวนผู้ติดตาม บอททราฟฟิกเป็นบอตอินเทอร์เน็ตประเภทหนึ่ง บอตอินเทอร์เน็ต คือแอปพลิเคชันซอฟต์แวร์ที่ทำงานอัตโนมัติบนอินเทอร์เน็ต
บอททราฟฟิกกับทราฟฟิกจากบอท
ทราฟฟิกจากบอทเป็นหมวดหมู่ที่กว้างกว่า ครอบคลุมทุกการเข้าชมหรือคำขอที่โปรแกรมสร้างขึ้นแทนคน ไม่ว่าเจตนาจะเป็นอะไร เมื่อ Googlebot รวบรวมข้อมูลบล็อกของคุณ นั่นคือทราฟฟิกจากบอท แต่ไม่มีใครเรียก Googlebot ว่าบอททราฟฟิก เพราะมันระบุตัวตน ปฏิบัติตามกฎการรวบรวมข้อมูล และไม่ได้แสร้งเป็นผู้ซื้อ
ความแตกต่างนี้กำหนดวิธีตอบสนองของคุณ ทราฟฟิกจากบอตรวบรวมข้อมูลที่ระบุตัวตนชัดเจนต้องได้รับการจัดการ คุณเป็นผู้ตัดสินใจว่าให้เข้าถึงอะไรได้บ้าง ส่วนการเข้าชมจากบอททราฟฟิกต้องได้รับการตรวจจับและคัดออก เพราะเป้าหมายทั้งหมดของบอททราฟฟิกคือการกลมกลืนกับผู้เข้าชมที่เป็นมนุษย์ของคุณ
ความแตกต่างนี้กำหนดวิธีตอบสนองของคุณ ทราฟฟิกจากบอตรวบรวมข้อมูลที่ระบุตัวตนชัดเจนต้องได้รับการจัดการ คุณเป็นผู้ตัดสินใจว่าให้เข้าถึงอะไรได้บ้าง ส่วนการเข้าชมจากบอททราฟฟิกต้องได้รับการตรวจจับและคัดออก เพราะเป้าหมายทั้งหมดของบอททราฟฟิกคือการกลมกลืนกับผู้เข้าชมที่เป็นมนุษย์ของคุณ
บอตที่ดี บอตที่ไม่ดี และพื้นที่สีเทา
อุตสาหกรรมโฆษณามีคำศัพท์ที่เป็นประโยชน์สำหรับเรื่องนี้ Media Rating Council (MRC) หน่วยงานสหรัฐฯ ที่รับรองการวัดผลโฆษณา แบ่งทราฟฟิกที่ไม่ถูกต้องเป็นสองกลุ่มในมาตรฐานทราฟฟิกที่ไม่ถูกต้อง:
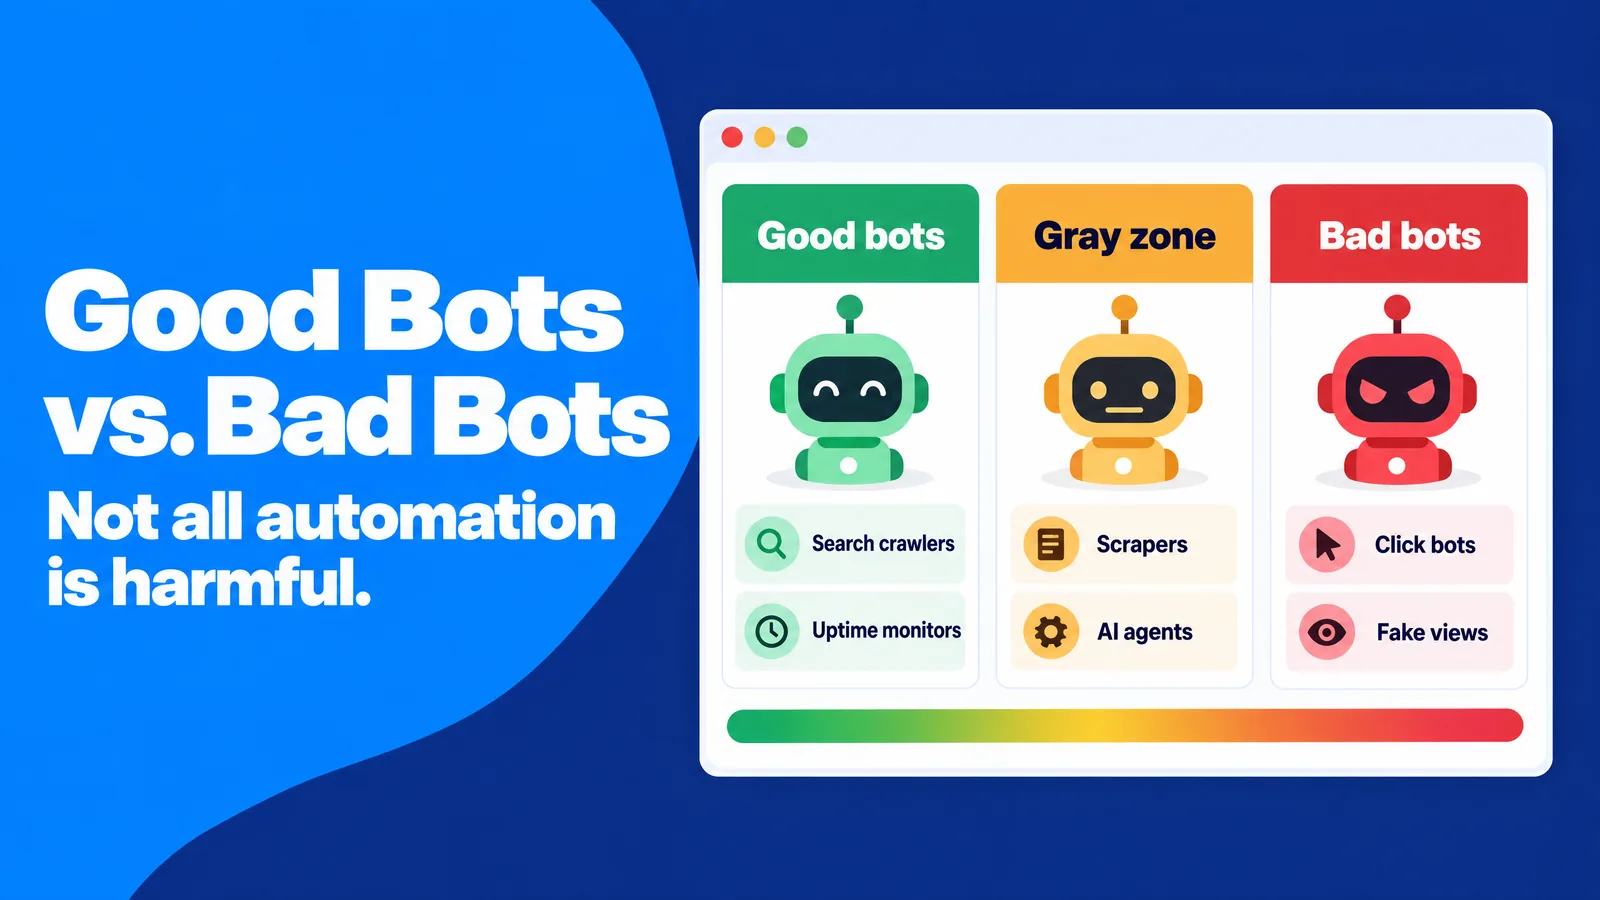
- ทราฟฟิกไม่ถูกต้องทั่วไป (GIVT): โปรแกรมรวบรวมข้อมูลที่รู้จัก ทราฟฟิกจากดาต้าเซ็นเตอร์ และระบบอัตโนมัติอื่นที่ตัวกรองแบบรายการจับได้
- ทราฟฟิกไม่ถูกต้องที่ซับซ้อน (SIVT): บอตที่เลียนแบบพฤติกรรมมนุษย์ อุปกรณ์ที่ถูกยึด มัลแวร์ และกิจกรรมที่มีการจูงใจ ซึ่งต้องวิเคราะห์เชิงลึกเพื่อระบุ
ระหว่างสิ่งที่ดีอย่างชัดเจนกับสิ่งที่ไม่ดีอย่างชัดเจนคือพื้นที่สีเทา โปรแกรมดึงข้อมูลเพื่อติดตามราคา โปรแกรมรวบรวมข้อมูลของเครื่องมือ SEO โปรแกรมรวบรวมข้อมูลเพื่อฝึก AI และเอเจนต์ AI ที่ท่องเว็บแทนคน ล้วนทำงานอัตโนมัติ การจะต้อนรับหรือไม่ขึ้นอยู่กับโมเดลธุรกิจของคุณ ไม่ใช่กฎสากล
ประเภทบอททราฟฟิกที่พบบ่อย
บอททราฟฟิกมีหลายกลุ่มที่สังเกตได้ การรู้จักแต่ละกลุ่มช่วยให้คุณคาดเดาได้ว่ากำลังเจอกลุ่มใดจากรูปแบบที่มันทิ้งไว้:
- บอตคลิก คลิกโฆษณาหรือผลการค้นหาเพื่อใช้จ่ายงบของคู่แข่งหรือปลอมการมีส่วนร่วม ซึ่งเรียกว่าการฉ้อโกงด้วยการคลิก
- บอตการแสดงผล โหลดโฆษณาบนหน้าปลอมหรือหน้าที่อำพราง เพื่อให้ผู้ลงโฆษณาจ่ายเงินสำหรับการดูที่ไม่มีใครเห็น
- โปรแกรม Autosurf และการแลกเปลี่ยนทราฟฟิก หมุนเวียนหน้าเว็บระหว่างสมาชิก จึงทำให้ทุกเว็บไซต์บันทึก “การเข้าชม” ที่ไม่มีใครอ่าน
- บอตสแปม Referrer ใส่ URL ลงในรายงานการอ้างอิงเพื่อหลอกให้คุณเข้าไปเยี่ยมชม กลวิธีนี้เรียกว่าreferrer spam
- เบราว์เซอร์แบบ Headless คือเบราว์เซอร์เต็มรูปแบบที่ไม่มีหน้าจอ นักพัฒนาใช้เพื่อทดสอบ และผู้ฉ้อโกงเคยนำไปใช้เพิ่มการแสดงผลโฆษณาเกินจริง
- ฟาร์มคลิก ใช้คนที่ได้รับค่าจ้างต่ำแทนโค้ด ผู้เข้าชมเป็นคนจริงในทางเทคนิค แต่เจตนาเป็นของปลอม มาตรฐานการวัดผลจึงนับกิจกรรมนี้ว่าไม่ถูกต้อง
ขั้นตอนปฏิบัติ: จุดเริ่มต้นที่มีประโยชน์คือรายการระบบอัตโนมัติที่คุณเชิญให้เข้ามาในหน้าเดียว ระบุโปรแกรมรวบรวมข้อมูลของเสิร์ชเอนจิน เครื่องมือตรวจสอบสถานะ โปรแกรมรวบรวมข้อมูล SEO เว็บฮุคการชำระเงิน และผู้ช่วย AI ที่คุณต้องการให้มีการอ้างอิง พร้อม user agent ที่แต่ละระบบระบุ วิธีนี้ได้ผลเพราะสัญญาณเตือนผิดพลาดจำนวนมากมาจากเครื่องมือของคุณเอง การรวบรวมข้อมูล SEO ที่ตั้งเวลาไว้ 3.00 น. จะดูเหมือนการพุ่งขึ้นยามค่ำคืนที่น่าสงสัยจนกว่าคุณจะตรวจรายการนี้
เหตุใดผู้เข้าชมจริงจึงมีรูปแบบที่สังเกตได้
คำแนะนำส่วนใหญ่เกี่ยวกับทราฟฟิกจากบอทเริ่มต้นจากสิ่งที่ดูผิดปกติ จุดเริ่มต้นที่น่าเชื่อถือกว่าคือการดูว่าปกติเป็นอย่างไร เพราะคุณตัดสินความผิดปกติไม่ได้หากไม่มีค่าพื้นฐาน
ผู้เข้าชมที่เป็นมนุษย์มีความไม่สม่ำเสมออย่างน่าทึ่ง คนหนึ่งอ่านหน้าราคาบนมือถือระหว่างเดินทาง 40 วินาที อีกคนเปิดแท็บบนเดสก์ท็อปทิ้งไว้ 12 นาที และคนที่สามออกไปหลังสองวินาทีเพราะแตะผลการค้นหาผิด
ความหลากหลายนี้คือสัญญาณที่แข็งแกร่งที่สุดที่คุณมี ทุกการเข้าชมของมนุษย์มีความแตกต่างเล็ก ๆ น้อย ๆ หลายสิบอย่าง เช่น ขนาดหน้าจอ เวอร์ชันเบราว์เซอร์ เขตเวลา ความเร็วการเลื่อน และช่วงหยุดก่อนคลิก ทราฟฟิกอัตโนมัติยากจะเลียนแบบความหลากหลายทั้งหมดในวงกว้าง เพราะความแตกต่างใหม่แต่ละอย่างต้องใช้เวลาและโครงสร้างพื้นฐานด้านวิศวกรรมของผู้ควบคุมบอต เครือข่ายบอตอาจปลอมหนึ่งหรือสองมิติได้อย่างแนบเนียน แต่การปลอมทั้งหมดพร้อมกันในหลายพันเซสชันมีต้นทุนสูง
SparkTraffic แพลตฟอร์มโฆษณาที่ส่งการเข้าชมเว็บไซต์แบบเจาะจงภูมิศาสตร์ผ่านโฆษณาบนเว็บไซต์ของพาร์ทเนอร์ผู้เผยแพร่ตั้งแต่ปี 2015 ใช้หลักการความหลากหลายนี้กับแบบทดสอบ 5 จุดที่เผยแพร่ให้ผู้ลงโฆษณาของตน เหตุผลเรียบง่าย ผู้ที่จ่ายเงินเพื่อการเข้าชมควรยืนยันได้ด้วยข้อมูลวิเคราะห์มาตรฐาน โดยไม่ต้องใช้เครื่องมือพิเศษ ว่าการเข้าชมเหล่านั้นมีพฤติกรรมเหมือนผู้คน การตรวจสอบเดียวกันใช้ได้กับทุกแหล่งที่มา ทั้งแบบชำระเงินและออร์แกนิก จึงเป็นค่าพื้นฐานทั่วไปที่ดีสำหรับรายงานของคุณ
แบบทดสอบร่องรอยมนุษย์ 5 จุด
แต่ละการตรวจสอบเปรียบเทียบพฤติกรรมหนึ่งมิติกับความหลากหลายที่คุณคาดหวังจากคนจริง เกณฑ์จงใจตั้งไว้กว้าง เพื่อไม่ให้กลุ่มตัวอย่างขนาดเล็กและความผันผวนตามปกติก่อให้เกิดสัญญาณเตือนผิดพลาด:
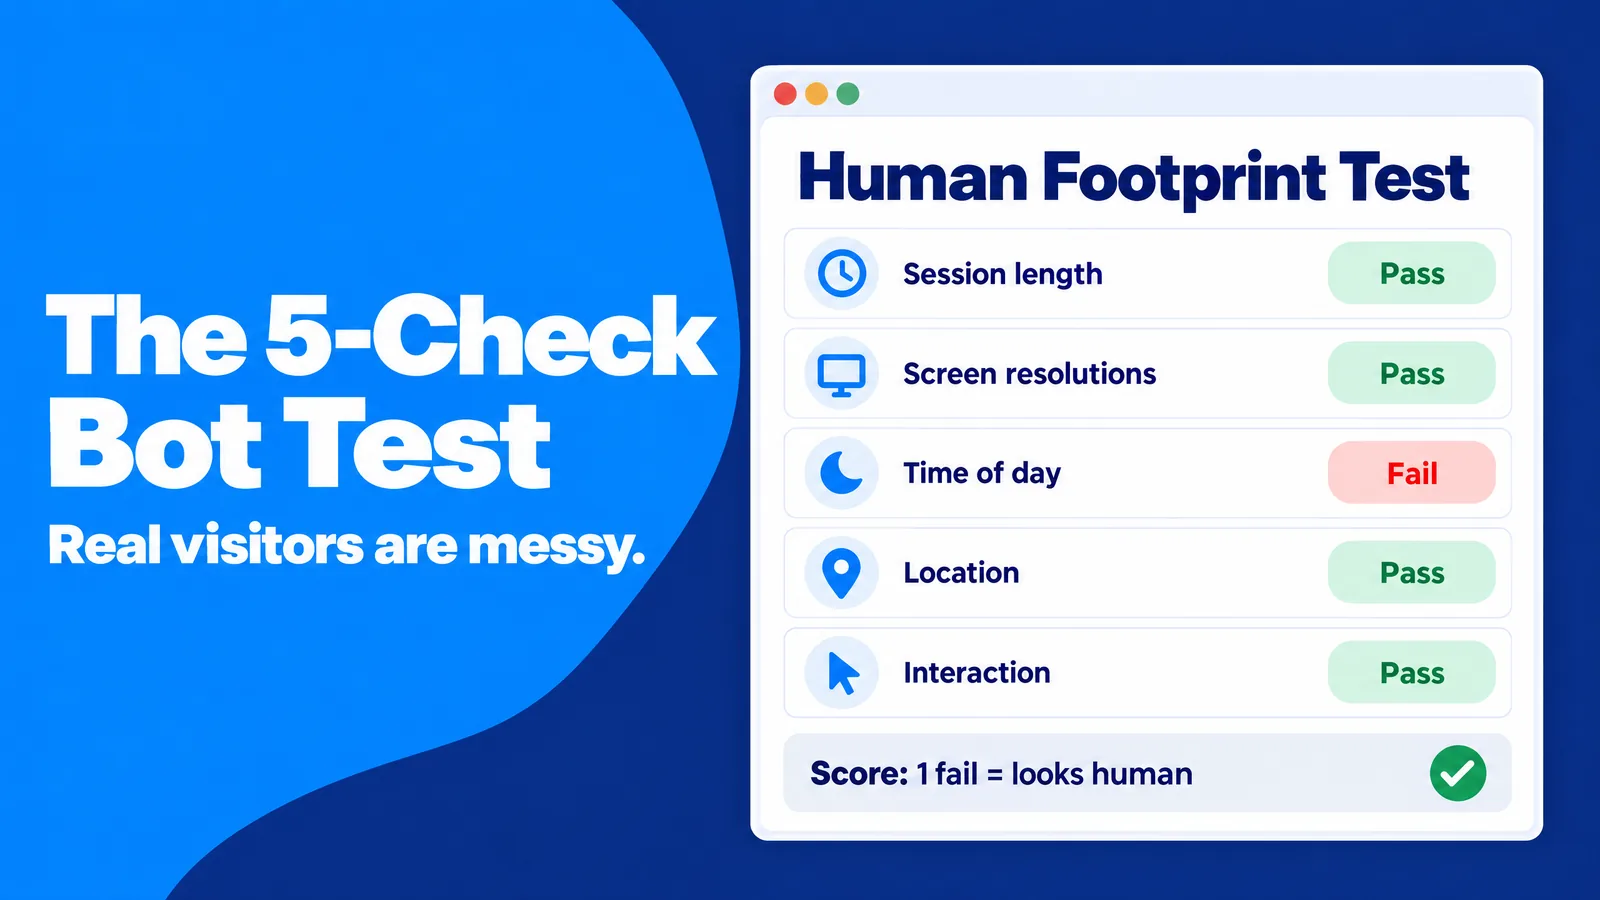
- ระยะเวลาเซสชัน: ทราฟฟิกที่ดีมีการกระจายตั้งแต่น้อยกว่า 10 วินาทีไปจนเกินสองนาที สัญญาณเตือนคือมากกว่าครึ่งของเซสชันอยู่ในช่วงห้าวินาทีเดียวกัน
- ความละเอียดหน้าจอ: ทราฟฟิกที่ดีแสดงความละเอียดหลายแบบ สัญญาณเตือนคือความละเอียดเดียวคิดเป็นมากกว่าครึ่งของเซสชัน
- ช่วงเวลาของวัน: ทราฟฟิกที่ดีเป็นไปตามรูปแบบเวลากลางวันในท้องถิ่น สัญญาณเตือนคือปริมาณระหว่าง 1.00 น. ถึง 5.00 น. ตามเวลาท้องถิ่นเท่ากับช่วงกลางวัน
- ตำแหน่งที่ตั้ง: ทราฟฟิกแบบเจาะจงกลุ่มเป้าหมายที่ดีส่งการเข้าชมมากกว่า 90% จากพื้นที่เป้าหมาย สัญญาณเตือนคือมากกว่า 10% มาจากสถานที่ที่คุณไม่ได้กำหนดเป้าหมาย
- การโต้ตอบ: ทราฟฟิกที่ดีมีการเลื่อน การคลิก หรือการเริ่มกรอกแบบฟอร์มบ้าง สัญญาณเตือนคือไม่มีการโต้ตอบเลยใน 300 เซสชัน
การตรวจไม่ผ่านศูนย์หรือหนึ่งข้อบ่งชี้ว่าทราฟฟิกมีพฤติกรรมเหมือนคน การไม่ผ่านตั้งแต่สองข้อขึ้นไปคือเหตุผลให้หยุดแหล่งที่มา ส่งออกประมาณ 20 เซสชันเป็นหลักฐาน และขอให้ผู้ให้บริการตรวจสอบ คะแนนนี้ใช้ได้ผลเพราะตัวชี้วัดแปลกเพียงตัวเดียวมักมีสาเหตุที่ไม่เป็นอันตราย เช่น แคมเปญสำหรับมือถือเท่านั้นที่ทำให้ขนาดหน้าจอแคบลง ขณะที่การไม่ผ่านหลายข้อพร้อมกันมักไม่ใช่เรื่องปกติ
สร้างค่าพื้นฐานของมนุษย์เอง
เกณฑ์ทั่วไปเป็นจุดเริ่มต้น ไม่ใช่คำตัดสิน บล็อกสูตรอาหาร เว็บไซต์เอกสาร SaaS และคลินิกทันตกรรมในท้องถิ่น ล้วนมีระยะเวลาเซสชันและจังหวะรายวันต่างกัน เซสชันเฉลี่ยห้านาทีอาจน่าสงสัยในหน้าค้นหาร้านค้า แต่ปกติอย่างยิ่งในบทแนะนำยาว ๆ
ขั้นตอนปฏิบัติ: เกณฑ์เปรียบเทียบที่น่าเชื่อถือที่สุดคือช่องทางที่คุณไว้วางใจอยู่แล้ว เช่น การคลิกจากจดหมายข่าวหรือลูกค้าที่เข้าสู่ระบบ การบันทึกการกระจายตัวของช่องทางนั้นในห้ามิติข้างต้นตลอด 30 วันจะให้ค่าพื้นฐานแก่คุณ และคุณสามารถเปรียบเทียบแหล่งใหม่ที่ดูแปลกกับค่านั้น แทนที่จะเทียบกับค่าเฉลี่ยอุตสาหกรรม วิธีนี้ได้ผลเพราะช่องทางที่เชื่อถือได้สะท้อนผู้ชม อุปกรณ์ และเขตเวลาของคุณอยู่แล้ว ดังนั้นความเบี่ยงเบนมากจึงชี้ไปที่แหล่งที่มา ไม่ใช่เว็บไซต์ของคุณ
ขั้นตอนปฏิบัติ: เกณฑ์เปรียบเทียบที่น่าเชื่อถือที่สุดคือช่องทางที่คุณไว้วางใจอยู่แล้ว เช่น การคลิกจากจดหมายข่าวหรือลูกค้าที่เข้าสู่ระบบ การบันทึกการกระจายตัวของช่องทางนั้นในห้ามิติข้างต้นตลอด 30 วันจะให้ค่าพื้นฐานแก่คุณ และคุณสามารถเปรียบเทียบแหล่งใหม่ที่ดูแปลกกับค่านั้น แทนที่จะเทียบกับค่าเฉลี่ยอุตสาหกรรม วิธีนี้ได้ผลเพราะช่องทางที่เชื่อถือได้สะท้อนผู้ชม อุปกรณ์ และเขตเวลาของคุณอยู่แล้ว ดังนั้นความเบี่ยงเบนมากจึงชี้ไปที่แหล่งที่มา ไม่ใช่เว็บไซต์ของคุณ
เหตุใดบอททราฟฟิกจึงมีอยู่ และมีต้นทุนอะไรบ้าง
บอททราฟฟิกมีอยู่เพราะมีคนได้กำไรจากกิจกรรมปลอม กำไรอาจเป็นทางตรง เช่น การฉ้อโกงโฆษณา หรือทางอ้อม เช่น ผู้ขายที่ขาย “ทราฟฟิก” เพื่อให้แดชบอร์ดดูคึกคัก การเข้าใจแรงจูงใจช่วยให้คุณคาดเดารูปแบบได้ ผู้ฉ้อโกงต้องการการแสดงผลและการคลิก ผู้ขายตัวเลขเพื่อภาพลักษณ์ต้องการยอดดูหน้าเว็บ และผู้ส่งสแปมต้องการความสนใจของคุณ
การฉ้อโกงโฆษณาในระดับอุตสาหกรรม
ตัวอย่างที่มีการบันทึกดีที่สุดคือ Methbot ตามกระทรวงยุติธรรมสหรัฐฯ ปฏิบัติการนี้ใช้เซิร์ฟเวอร์มากกว่า 1,900 เครื่อง และที่อยู่ IP มากกว่า 650,000 รายการ เพื่อโหลดโฆษณาบนเว็บไซต์ปลอมมากกว่า 5,000 แห่ง และเก็บเงินได้มากกว่า 7 ล้านดอลลาร์ โครงการที่เกี่ยวข้องคือ 3ve ทำงานบนคอมพิวเตอร์ที่ติดมัลแวร์ราว 1.7 ล้านเครื่อง และได้เงินมากกว่า 29 ล้านดอลลาร์
บอตถูกสร้างให้ดูเหมือนมนุษย์ ประกาศคำพิพากษาของ DOJ อธิบายถึงบอตที่ปลอมการเคลื่อนไหวเมาส์ การเลื่อน และการเข้าสู่ระบบโซเชียลเน็ตเวิร์ก โดยผู้ดำเนินการหลักได้รับโทษจำคุก 10 ปี บทเรียนสำหรับนักการตลาดคือ “การมีส่วนร่วมที่สมจริง” เพียงอย่างเดียวพิสูจน์อะไรไม่ได้ เพราะ Methbot ถูกออกแบบมาให้สร้างสิ่งนั้นโดยตรง
บอตถูกสร้างให้ดูเหมือนมนุษย์ ประกาศคำพิพากษาของ DOJ อธิบายถึงบอตที่ปลอมการเคลื่อนไหวเมาส์ การเลื่อน และการเข้าสู่ระบบโซเชียลเน็ตเวิร์ก โดยผู้ดำเนินการหลักได้รับโทษจำคุก 10 ปี บทเรียนสำหรับนักการตลาดคือ “การมีส่วนร่วมที่สมจริง” เพียงอย่างเดียวพิสูจน์อะไรไม่ได้ เพราะ Methbot ถูกออกแบบมาให้สร้างสิ่งนั้นโดยตรง
ความนิยมปลอมและตัวชี้วัดเพื่อภาพลักษณ์
แรงจูงใจประการที่สองคือภาพลักษณ์ของความนิยม ผู้ขายบางรายขายซอฟต์แวร์บอททราฟฟิกหรือ “แพ็กเกจผู้เข้าชม” ที่ปั่นยอดดูหน้าเว็บ ยอดดูวิดีโอ หรือจำนวนผู้ติดตาม ในยุคแรกของเว็บ ตัวนับจำนวนการเข้าชมดิบสร้างความประทับใจให้ผู้คน และตัวเลขที่ปั่นขึ้นมีผลตอบแทนระยะสั้น วันนี้ เสิร์ชเอนจิน ผู้ลงโฆษณา และนักลงทุนมองการมีส่วนร่วม คอนเวอร์ชัน และรายได้ ปริมาณปลอมจึงไม่ได้ให้อะไรและยังทำให้ข้อมูลที่คุณต้องใช้ปนเปื้อน
หน่วยงานกำกับดูแลมองความนิยมปลอมว่าเป็นการหลอกลวง ในเดือนสิงหาคม 2024 คณะกรรมาธิการการค้าแห่งสหพันธรัฐสหรัฐฯ ออกกฎห้ามขายหรือซื้อสัญญาณอิทธิพลบนโซเชียลมีเดียปลอม เช่น ผู้ติดตามหรือยอดดูที่บอตสร้างขึ้น ข้อห้ามนี้ใช้เมื่อผู้ซื้อรู้หรือควรรู้ว่าสัญญาณนั้นเป็นของปลอม และใช้เพื่อวัตถุประสงค์เชิงพาณิชย์ นโยบายโฆษณาของ Google ก็ห้ามส่งเสริมบริการที่ขายกิจกรรมผู้ใช้ปลอม เช่น การคลิกที่ไม่ถูกต้อง
หน่วยงานกำกับดูแลมองความนิยมปลอมว่าเป็นการหลอกลวง ในเดือนสิงหาคม 2024 คณะกรรมาธิการการค้าแห่งสหพันธรัฐสหรัฐฯ ออกกฎห้ามขายหรือซื้อสัญญาณอิทธิพลบนโซเชียลมีเดียปลอม เช่น ผู้ติดตามหรือยอดดูที่บอตสร้างขึ้น ข้อห้ามนี้ใช้เมื่อผู้ซื้อรู้หรือควรรู้ว่าสัญญาณนั้นเป็นของปลอม และใช้เพื่อวัตถุประสงค์เชิงพาณิชย์ นโยบายโฆษณาของ Google ก็ห้ามส่งเสริมบริการที่ขายกิจกรรมผู้ใช้ปลอม เช่น การคลิกที่ไม่ถูกต้อง
Referrer Spam และทราฟฟิกผี
แรงจูงใจประการที่สามคือความสนใจ บอต referrer spam เข้าเยี่ยมเว็บไซต์ของคุณ หรือส่งข้อมูลตรงไปยังพร็อพเพอร์ตี้การวิเคราะห์ของคุณ พร้อม URL ผู้อ้างอิงปลอม เมื่อคุณเห็นโดเมนที่ไม่คุ้นเคยในรายงานการอ้างอิง ความอยากรู้จะทำหน้าที่ต่อ และผู้ส่งสแปมก็ได้การเข้าชมหรือยอดขาย บทความ Wikipedia เรื่อง referrer spam อธิบายว่ากลวิธีนี้ย้ายจากบันทึกเซิร์ฟเวอร์เข้าสู่เครื่องมือวิเคราะห์อย่างไร
ต้นทุนที่แท้จริง: การตัดสินใจบนข้อมูลปลอม
ต้นทุนโดยตรงของทราฟฟิกจากบอทคืองบโฆษณาที่สูญเปล่าและภาระเซิร์ฟเวอร์ ต้นทุนทางอ้อมมักสูงกว่า ลองนึกถึงการทดสอบ A/B ที่ตัวแปร B ได้เซสชันจากบอตเพิ่ม 600 เซสชันโดยไม่มีคอนเวอร์ชัน อัตราคอนเวอร์ชันของ B ลดลง คุณเก็บหน้าที่อ่อนกว่าไว้ และไม่มีใครรู้เหตุผล หรือทีมคอนเทนต์อาจทุ่มกับหัวข้อหนึ่งต่อ เพราะโปรแกรมดึงข้อมูลรวบรวมบทความเหล่านั้นทุกชั่วโมง
ขั้นตอนปฏิบัติ: การประเมินต้นทุนของข้อมูลปนเปื้อนทำให้ปัญหาจับต้องได้ คูณสัดส่วนของเซสชันที่ไม่ผ่านการตรวจอย่างน้อยสองข้อจากห้าข้อด้วยค่าใช้จ่ายสื่อแบบชำระเงินของคุณในไตรมาสนั้น จากนั้นระบุการตัดสินใจทุกอย่างที่อาศัยรายงานเหล่านั้น เช่น การโยกงบ ผู้ชนะการทดสอบ และลำดับความสำคัญของคอนเทนต์ วิธีนี้เปลี่ยนปัญหาคุณภาพข้อมูลเชิงนามธรรมให้เป็นตัวเลขงบประมาณ จึงขอเวลาและเครื่องมือได้ง่ายขึ้นมาก
ขั้นตอนปฏิบัติ: การประเมินต้นทุนของข้อมูลปนเปื้อนทำให้ปัญหาจับต้องได้ คูณสัดส่วนของเซสชันที่ไม่ผ่านการตรวจอย่างน้อยสองข้อจากห้าข้อด้วยค่าใช้จ่ายสื่อแบบชำระเงินของคุณในไตรมาสนั้น จากนั้นระบุการตัดสินใจทุกอย่างที่อาศัยรายงานเหล่านั้น เช่น การโยกงบ ผู้ชนะการทดสอบ และลำดับความสำคัญของคอนเทนต์ วิธีนี้เปลี่ยนปัญหาคุณภาพข้อมูลเชิงนามธรรมให้เป็นตัวเลขงบประมาณ จึงขอเวลาและเครื่องมือได้ง่ายขึ้นมาก
วิธีตรวจจับทราฟฟิกจากบอทใน Google Analytics 4
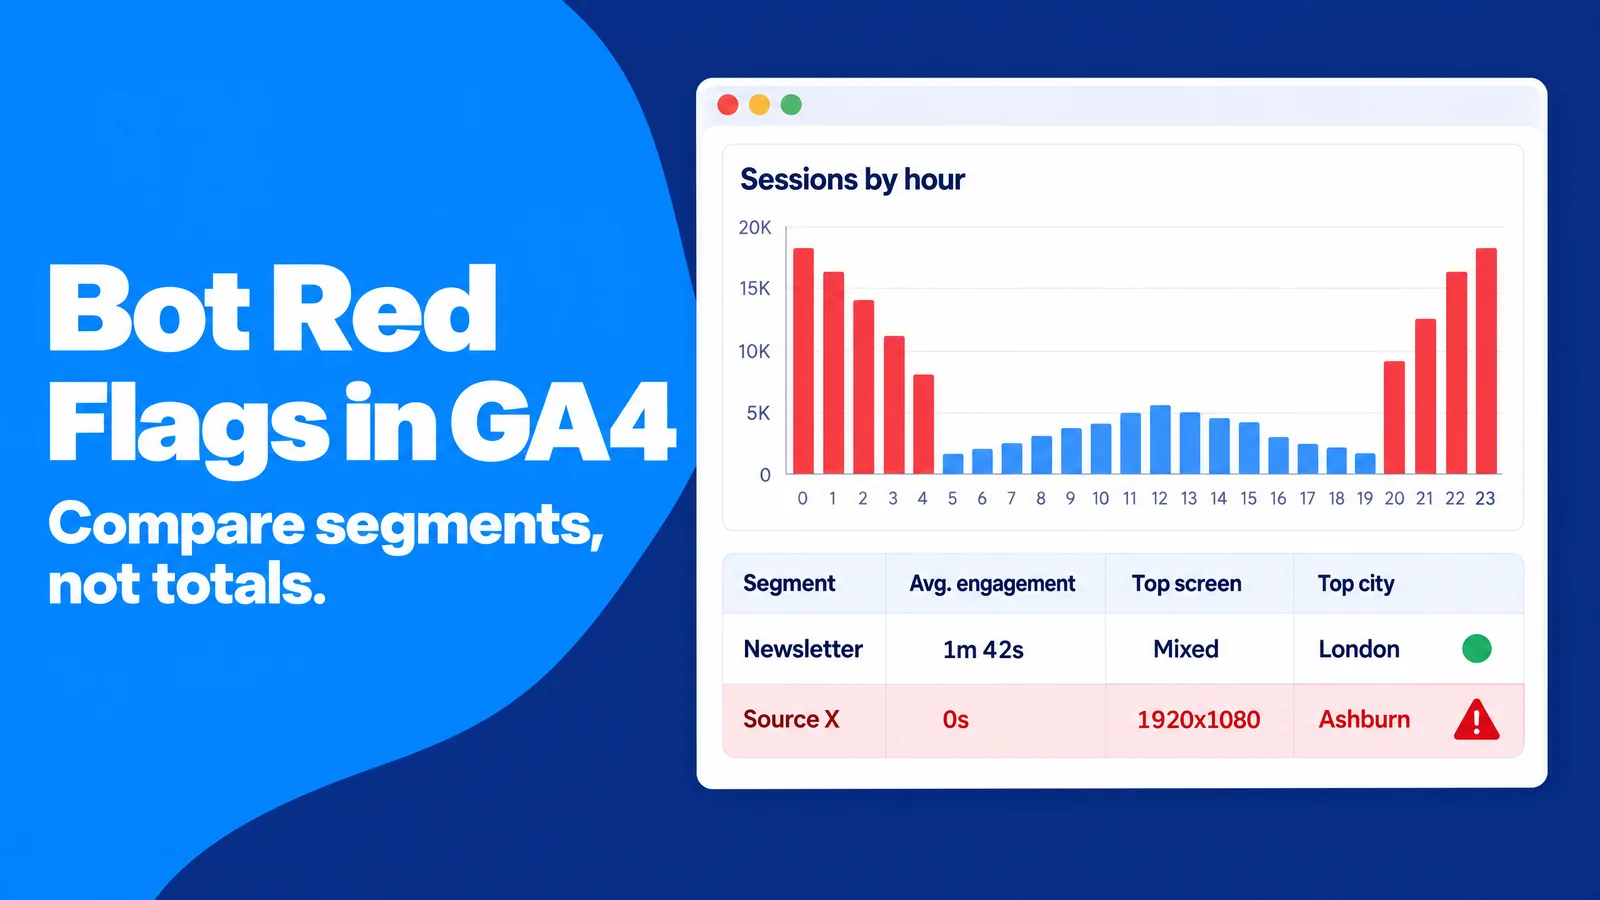
Google Analytics 4 (GA4) คัดบอตที่รู้จักออกโดยอัตโนมัติอยู่แล้ว โดยใช้การวิจัยของ Google และIAB/ABC International Spiders and Bots List คุณปิดการทำงานนี้ไม่ได้ และดูไม่ได้ว่าระบบตัดทราฟฟิกออกไปเท่าไร ฟังดูน่าอุ่นใจ แต่ก็หมายความว่าบอตที่เหลือในรายงานของคุณก็คือบอตที่ไม่อยู่ในรายการใดเลย การตรวจจับทราฟฟิกจากบอทนอกเหนือจากรายการนี้จึงเป็นหน้าที่ของคุณ
ข่าวดีคือบอตที่ไม่รู้จักยังทิ้งรูปแบบไว้ มันมักเข้ามาเป็นระลอก ใช้อุปกรณ์เพียงไม่กี่แบบ ไม่สนใจเส้นทางคอนเวอร์ชัน และกระจุกตัวในพื้นที่ที่ลูกค้าของคุณไม่ได้อาศัยอยู่ คุณระบุทราฟฟิกจากบอทได้ด้วยการเปรียบเทียบกลุ่ม ไม่ใช่การจ้องยอดรวม
ข่าวดีคือบอตที่ไม่รู้จักยังทิ้งรูปแบบไว้ มันมักเข้ามาเป็นระลอก ใช้อุปกรณ์เพียงไม่กี่แบบ ไม่สนใจเส้นทางคอนเวอร์ชัน และกระจุกตัวในพื้นที่ที่ลูกค้าของคุณไม่ได้อาศัยอยู่ คุณระบุทราฟฟิกจากบอทได้ด้วยการเปรียบเทียบกลุ่ม ไม่ใช่การจ้องยอดรวม
เริ่มจากรูปทรงของยอดพุ่ง
ยอดทราฟฟิกที่พุ่งขึ้นตามธรรมชาติมีสาเหตุและรูปทรง จดหมายข่าว โพสต์โซเชียล หรือการกล่าวถึงในสื่อ สร้างการเพิ่มขึ้นอย่างรวดเร็วตามด้วยการลดลงทีละน้อยในช่วงหลายชั่วโมงหรือหลายวัน และคอนเวอร์ชันก็เพิ่มตาม ยอดพุ่งจากบอตมักต่างออกไป เป็นแนวราบด้านบน เริ่มและหยุดตรงเวลาที่ลงตัว และเซสชันเพิ่มขึ้นขณะที่อีเวนต์สำคัญยังคงเดิม
เมื่อเกิดยอดพุ่ง คำถามแรกคือ “ตอนนั้นเกิดอะไรขึ้น” หากไม่มีแคมเปญ การกล่าวถึง หรือเหตุการณ์ตามฤดูกาลอธิบายได้ ควรถือว่ายอดพุ่งนั้นยังไม่ได้รับการยืนยันจนกว่าการเปรียบเทียบกลุ่มด้านล่างจะบอกเป็นอย่างอื่น
เมื่อเกิดยอดพุ่ง คำถามแรกคือ “ตอนนั้นเกิดอะไรขึ้น” หากไม่มีแคมเปญ การกล่าวถึง หรือเหตุการณ์ตามฤดูกาลอธิบายได้ ควรถือว่ายอดพุ่งนั้นยังไม่ได้รับการยืนยันจนกว่าการเปรียบเทียบกลุ่มด้านล่างจะบอกเป็นอย่างอื่น
สัญญาณเตือน 8 ข้อในรายงานของคุณ
รูปแบบเหล่านี้ควรค่าแก่การตรวจสอบทุกครั้งที่แหล่งที่มาหรือหน้า Landing Page ดูผิดปกติ:
- เวลา Engagement ใกล้ศูนย์: หลายเซสชันแทบไม่มีเวลา Engagement หรือระยะเวลากระจุกอยู่ในไม่กี่วินาทีเดียวกัน
- ยอดพุ่งของ Direct หรือ Unassigned: ทราฟฟิก Direct หรือ Unassigned ไปยังหน้า Landing Page ที่ไม่มีลิงก์ชัดเจนเพิ่มขึ้นอย่างฉับพลัน
- Hostname ที่ไม่รู้จัก: การเข้าชมที่บันทึกบนโดเมนที่ไม่ใช่ของคุณ ซึ่งเกิดขึ้นเมื่อมีคนคัดลอก Measurement ID ของคุณไปใส่ในเว็บไซต์อื่น
- โปรไฟล์อุปกรณ์เดียว: ความละเอียดหน้าจอ เวอร์ชันเบราว์เซอร์ หรือระบบปฏิบัติการเดียวครองแหล่งที่มาหนึ่ง
- ตำแหน่งดาต้าเซ็นเตอร์: การกระจุกตัวในเมืองที่รู้จักเรื่องฟาร์มเซิร์ฟเวอร์ เช่น Ashburn, Virginia แทนที่จะเป็นพื้นที่ที่ลูกค้าของคุณอยู่
- ทราฟฟิกกะดึก: ปริมาณระหว่าง 1.00 น. ถึง 5.00 น. ในท้องถิ่นเท่ากับปริมาณช่วงกลางวัน
- Referrer แปลก ๆ: โดเมนที่ไม่คุ้นเคย โดยเฉพาะโดเมนที่โฆษณาบริการ SEO หรือทราฟฟิก
- คอนเวอร์ชันคงที่: เซสชันเพิ่มขึ้น แต่การสมัคร การซื้อ หรือลีดที่ผ่านคุณสมบัติยังคงเดิม หรือแบบฟอร์มเต็มไปด้วยข้อความไร้ความหมาย
สร้าง Exploration สำหรับตรวจสอบบอต
ส่วน Explore ของ GA4 ให้คุณสร้างรายงานที่นำกลับมาใช้ซ้ำสำหรับงานนี้ได้ Exploration แบบอิสระที่มีมิติข้อมูลเหมาะสมตอบคำถามส่วนใหญ่ได้ภายในไม่กี่นาที และเทมเพลตที่บันทึกไว้ทำให้การตรวจสอบครั้งต่อไปไม่ต้องเริ่มจากศูนย์:
- การตั้งค่า: Exploration แบบอิสระที่มีมิติข้อมูล session source / medium, landing page, hostname, screen resolution, city และ hour
- เมตริก: sessions, engaged sessions, average engagement time per session และ key events
- กลุ่ม: หนึ่งกลุ่มสำหรับแหล่งที่มาน่าสงสัย และหนึ่งกลุ่มสำหรับช่องทางค่าพื้นฐานที่คุณเชื่อถือ
- การเปรียบเทียบ: วางสองกลุ่มเคียงข้างกัน เปรียบเทียบทีละมิติ โดยใช้การตรวจสอบห้าจุดเป็นแนวทาง
- หลักฐาน: ส่งออกประมาณ 20 เซสชันน่าสงสัยพร้อมแอตทริบิวต์ เพื่อแชร์กับผู้ให้บริการหรือแพลตฟอร์มโฆษณา
แนวทางนี้ได้ผลเพราะบอตแทบไม่ล้มเหลวในมิติเดียวแบบแยกขาด กลุ่มที่วางเทียบกันทำให้เห็นโปรไฟล์อุปกรณ์ที่แคบ ช่วงเวลาที่ผิดปกติ และคอนเวอร์ชันที่หายไปพร้อมกัน คู่มือของเราเรื่องการใช้ข้อมูลวิเคราะห์เพื่อปรับปรุงทราฟฟิกเว็บ ครอบคลุมรายงาน GA4 หลัก และคู่มือเรื่องการระบุแหล่งที่มาของทราฟฟิก AI อธิบายวิธีอ่านทราฟฟิก Direct โดยไม่ด่วนสรุป
ใช้ Data Filters ของ GA4 อย่างระมัดระวัง
Data filters เป็นวิธีหลักในการตัดทราฟฟิกจากบอทออกใน GA4 เมื่อคุณรู้ว่าแหล่งที่มาคือที่ใด ตัวกรองสามารถตัดทราฟฟิกภายใน ทราฟฟิกของนักพัฒนา และเมื่อไม่นานมานี้ การเข้าชมจาก hostname ที่คุณไม่ได้เป็นเจ้าของ ตัวกรอง hostname ที่รวมเฉพาะโดเมนของคุณเองเป็นวิธีแก้ที่ตรงไปตรงมาสำหรับ Measurement ID ที่ถูกคัดลอกไปยังเว็บไซต์อื่น ตัวกรองทรงพลังแต่ไม่ให้อภัย เมื่อเปิดใช้งานแล้ว ข้อมูลที่ถูกตัดออกจะหายไปถาวร
ขั้นตอนปฏิบัติ: นิสัยที่ปลอดภัยที่สุดคือให้ตัวกรองใหม่ทุกตัวทำงานในโหมดทดสอบอย่างน้อยหนึ่งสัปดาห์ แล้วเปรียบเทียบผลลัพธ์ที่กรองและไม่กรองก่อนเปิดใช้ วิธีนี้ป้องกันไม่ให้คุณลบข้อมูลลูกค้าจริงเพราะพิมพ์ชื่อโดเมนผิด หรือเพราะกฎกว้างเกินไป
ขั้นตอนปฏิบัติ: นิสัยที่ปลอดภัยที่สุดคือให้ตัวกรองใหม่ทุกตัวทำงานในโหมดทดสอบอย่างน้อยหนึ่งสัปดาห์ แล้วเปรียบเทียบผลลัพธ์ที่กรองและไม่กรองก่อนเปิดใช้ วิธีนี้ป้องกันไม่ให้คุณลบข้อมูลลูกค้าจริงเพราะพิมพ์ชื่อโดเมนผิด หรือเพราะกฎกว้างเกินไป
วิธียืนยันบอตในระดับเซิร์ฟเวอร์
เครื่องมือวิเคราะห์เห็นเฉพาะผู้เข้าชมที่เรียกใช้โค้ดติดตามของคุณ บอตจำนวนมากไม่เคยรัน JavaScript จึงไม่ปรากฏใน GA4 แต่ยังใช้แบนด์วิดท์ ดึงคอนเทนต์ และลองฟอร์มเข้าสู่ระบบ บันทึกเซิร์ฟเวอร์ บันทึก CDN หรือแดชบอร์ดโฮสติ้งจะแสดงทุกคำขอ จึงเป็นจุดที่ใช้ยืนยันได้ว่าใครกำลังเข้าชมจริง
เหตุใด User Agent จึงพิสูจน์อะไรไม่ได้
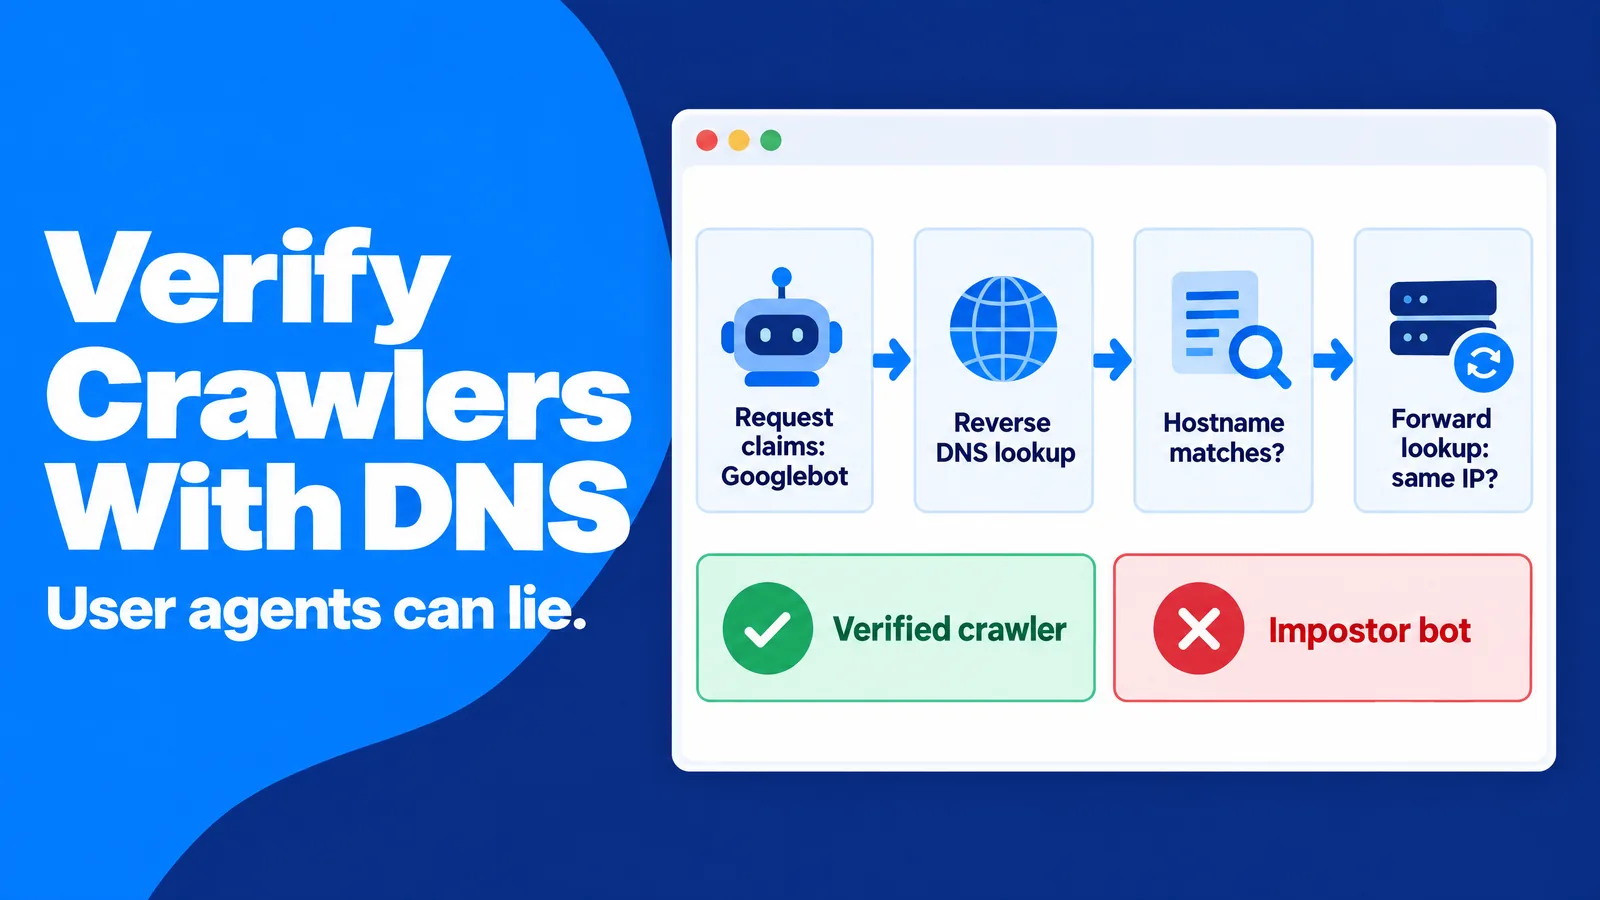
ทุกคำขอมีสตริง user agent ที่ระบุชื่อเบราว์เซอร์หรือบอต จุดที่ต้องระวังคือผู้เข้าชมเป็นผู้เขียนมัน โปรแกรมดึงข้อมูลสามารถอ้างว่าเป็น Googlebot, Chrome บน iPhone หรืออะไรก็ได้ด้วยโค้ดบรรทัดเดียว ดังนั้นการถือว่า user agent คืออัตลักษณ์ก็เหมือนยอมรับป้ายชื่อแทนหนังสือเดินทาง
ยืนยันโปรแกรมรวบรวมข้อมูลด้วย Forward-Confirmed Reverse DNS
วิธีมาตรฐานในการตรวจสอบโปรแกรมรวบรวมข้อมูลที่ระบุตัวตนเองคือ forward-confirmed reverse DNS วิธีนี้ใช้การค้นหาสองครั้ง การค้นหา reverse DNS จากที่อยู่ IP ของผู้เข้าชมจะคืนชื่อโฮสต์ ซึ่งต้องเป็นโดเมนของผู้ให้บริการที่อ้างถึง จากนั้นการค้นหา forward จากชื่อโฮสต์นั้นต้องคืนที่อยู่ IP เดิม บอต Googlebot ปลอมจึงไม่ผ่าน เพราะที่อยู่ IP ของมันไม่ย้อนกลับไปยังโดเมนของ Google
ขั้นตอนปฏิบัติ: ตัวอย่างบันทึกรายเดือนช่วยให้งานนี้จัดการได้ ดึง user agent 20 รายการที่ทำคำขอมากที่สุด และตรวจสอบรายการที่อ้างว่าเป็นเสิร์ชเอนจินหรือโปรแกรมรวบรวมข้อมูล AI รายใหญ่ ใช้เวลาเพียงไม่กี่นาที วิธีนี้ได้ผลเพราะผู้แอบอ้างมักรวมตัวในจุดที่ผลตอบแทนสูงสุด การแสร้งเป็นโปรแกรมรวบรวมข้อมูลที่เชื่อถือได้เป็นวิธีง่ายที่สุดในการผ่านข้อจำกัดอัตราและไฟร์วอลล์
ขั้นตอนปฏิบัติ: ตัวอย่างบันทึกรายเดือนช่วยให้งานนี้จัดการได้ ดึง user agent 20 รายการที่ทำคำขอมากที่สุด และตรวจสอบรายการที่อ้างว่าเป็นเสิร์ชเอนจินหรือโปรแกรมรวบรวมข้อมูล AI รายใหญ่ ใช้เวลาเพียงไม่กี่นาที วิธีนี้ได้ผลเพราะผู้แอบอ้างมักรวมตัวในจุดที่ผลตอบแทนสูงสุด การแสร้งเป็นโปรแกรมรวบรวมข้อมูลที่เชื่อถือได้เป็นวิธีง่ายที่สุดในการผ่านข้อจำกัดอัตราและไฟร์วอลล์
Robots.txt คือคำขอ ไม่ใช่กุญแจล็อก
ไฟล์ robots.txt บอกโปรแกรมรวบรวมข้อมูลว่าสามารถเข้าถึงอะไรได้บ้าง และรูปแบบถูกกำหนดมาตรฐานไว้ใน RFC 9309 การปฏิบัติตามเป็นความสมัครใจ โปรแกรมรวบรวมข้อมูลที่มีพฤติกรรมดีจะเคารพไฟล์นี้ ขณะที่บอททราฟฟิกและโปรแกรมดึงข้อมูลจำนวนมากไม่สนใจ หรือเปลี่ยนชื่อเพื่อหลบการบล็อก
Robots.txt ยังมีประโยชน์ เพราะช่วยแยกบอตที่เคารพกฎของคุณออกจากบอตที่ไม่เคารพ Wikipedia ระบุว่าเว็บไซต์ที่มีผู้เข้าชมมากที่สุด 306 แห่งจาก 1,000 แห่งบล็อก GPTBot ของ OpenAI ในปี 2023 ซึ่งแสดงให้เห็นว่าเจ้าของเว็บไซต์ใช้ไฟล์นี้เป็นคำประกาศนโยบาย บอตที่ร้องขอหน้าที่คุณไม่อนุญาตได้บอกข้อมูลสำคัญเกี่ยวกับเจตนาของมันแล้ว
Robots.txt ยังมีประโยชน์ เพราะช่วยแยกบอตที่เคารพกฎของคุณออกจากบอตที่ไม่เคารพ Wikipedia ระบุว่าเว็บไซต์ที่มีผู้เข้าชมมากที่สุด 306 แห่งจาก 1,000 แห่งบล็อก GPTBot ของ OpenAI ในปี 2023 ซึ่งแสดงให้เห็นว่าเจ้าของเว็บไซต์ใช้ไฟล์นี้เป็นคำประกาศนโยบาย บอตที่ร้องขอหน้าที่คุณไม่อนุญาตได้บอกข้อมูลสำคัญเกี่ยวกับเจตนาของมันแล้ว
อัตลักษณ์บอตแบบลงลายมือชื่อกำลังมา
ทางแก้ระยะยาวสำหรับการปลอมตัวคืออัตลักษณ์เชิงเข้ารหัส Internet Engineering Task Force (IETF) จัดตั้งคณะทำงาน Web Bot Auth เพื่อกำหนดมาตรฐานว่าบอตจะพิสูจน์ตัวตนได้อย่างไร โดยต่อยอดจากHTTP Message Signatures บอตที่ลงลายมือชื่อจะแนบลายเซ็นที่ตรวจสอบได้กับทุกคำขอ เพื่อให้เว็บไซต์ยืนยันผู้ดำเนินการได้โดยไม่ต้องพึ่งรายการ IP การติดตามงานนี้ตั้งแต่ตอนนี้ช่วยให้คุณวางแผนได้ว่าจะอนุญาตผู้เข้าชมอัตโนมัติรายใดเมื่อการใช้ลายเซ็นกลายเป็นเรื่องปกติ
วิธีหยุดทราฟฟิกจากบอทโดยไม่บล็อกคนจริง
การบล็อกบอตฟังดูง่ายจนกว่าลูกค้าจริงจะติดอยู่ในตาข่าย กำแพง CAPTCHA ที่เข้มงวดทำให้คนที่ใช้มือถือช้าหงุดหงิด และสร้างอุปสรรคให้ผู้ใช้เทคโนโลยีช่วยเหลือ การบล็อกทั้งประเทศหรือดาต้าเซ็นเตอร์อาจกันนักเดินทาง ผู้ใช้ VPN องค์กร และผู้เข้าชมที่ใส่ใจความเป็นส่วนตัวออกไป และทุก false positive คือลีดที่สูญหายโดยไม่เคยปรากฏในรายงานใด
แนวทางสมัยใหม่ต้องคำนึงถึงระบบอัตโนมัติที่มีประโยชน์ ผู้ช่วย AI เพิ่มขึ้นในการดึงหน้าเว็บ เปรียบเทียบสินค้า และกรอกแบบฟอร์มแทนคน การมองทุกคำขอที่ไม่ใช่มนุษย์ว่าเป็นภัยคุกคามอาจตัดคุณออกจากการเข้าชมที่ลูกค้าจริงร้องขอ
แนวทางสมัยใหม่ต้องคำนึงถึงระบบอัตโนมัติที่มีประโยชน์ ผู้ช่วย AI เพิ่มขึ้นในการดึงหน้าเว็บ เปรียบเทียบสินค้า และกรอกแบบฟอร์มแทนคน การมองทุกคำขอที่ไม่ใช่มนุษย์ว่าเป็นภัยคุกคามอาจตัดคุณออกจากการเข้าชมที่ลูกค้าจริงร้องขอ
จับคู่การตอบสนองให้เหมาะกับบอต
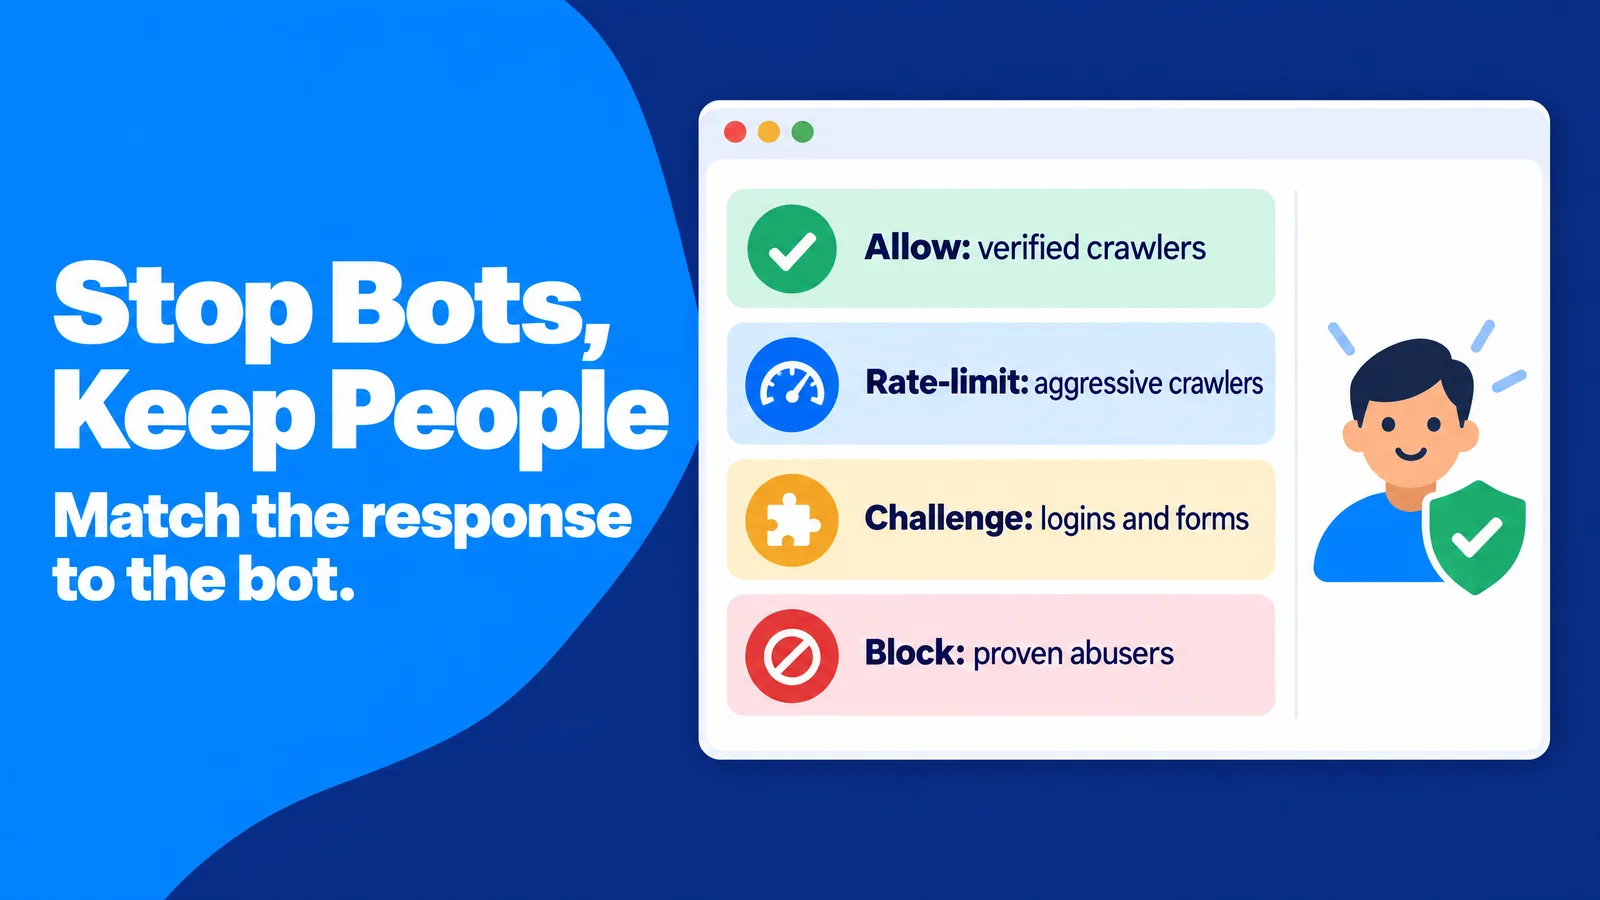
แนวป้องกันที่มีประสิทธิภาพที่สุดเป็นแบบไล่ระดับ ไม่ใช่มีหรือไม่มีเลย ผู้เข้าชมอัตโนมัติแต่ละประเภทได้รับการตอบสนองที่เบาที่สุดซึ่งแก้ปัญหาได้:
- โปรแกรมรวบรวมข้อมูลที่ยืนยันแล้วและคุณต้องการ: อนุญาต เพราะช่วยให้มองเห็นในผลค้นหาและได้รับการอ้างอิงจาก AI
- โปรแกรมรวบรวมข้อมูลที่รุกล้ำแต่ถูกต้อง: จำกัดอัตรา ซึ่งปกป้องประสิทธิภาพเซิร์ฟเวอร์โดยไม่ทำให้สิ่งใดใช้งานไม่ได้
- ทราฟฟิกที่ยังไม่ยืนยันบนหน้าที่ละเอียดอ่อน: ให้ทำCAPTCHA หรือการทดสอบคล้ายกันเฉพาะตอนเข้าสู่ระบบ สมัคร และชำระเงิน ซึ่งเป็นจุดที่ต้นทุนจากการใช้งานในทางที่ผิดสูงที่สุด
- ผู้ละเมิดที่พิสูจน์แล้ว: บล็อกตามช่วง IP เครือข่าย หรือลายเซ็น เมื่อหลักฐานชัดเจน
การไล่ระดับนี้ได้ผลเพราะรวมแรงเสียดทานไว้ตรงจุดที่การใช้ในทางที่ผิดสร้างความเสียหายจริง และทำให้ส่วนอื่นของเว็บไซต์เร็วและเปิดกว้างสำหรับผู้คน
ปกป้องแบบฟอร์ม การสมัคร และการชำระเงิน
แบบฟอร์มคือจุดที่บอตสร้างความเสียหายยาวนานที่สุด การสมัครปลอมทำให้ CRM ของคุณปนเปื้อน ส่งอีเมลต้อนรับไปยังที่อยู่ที่ตีกลับ และทำลายชื่อเสียงผู้ส่ง ลีดปลอมทำให้ทีมขายเสียเวลาและบิดเบือนรายงานต้นทุนต่อลีด
ขั้นตอนปฏิบัติ: ชั้นแรกแบบเรียบง่ายคือฟิลด์ honeypot ซึ่งเป็นช่องในแบบฟอร์มที่ซ่อนจากคนแต่บอตเห็น ดังนั้นการส่งแบบฟอร์มใดที่กรอกช่องนี้จึงถูกปฏิเสธได้ การตรวจสอบฝั่งเซิร์ฟเวอร์ การจำกัดอัตราต่อที่อยู่ IP และ double opt-in สำหรับรายชื่ออีเมล เป็นชั้นป้องกันเพิ่มเติม โครงสร้างนี้ได้ผลเพราะแต่ละชั้นหยุดบอตคนละชนิด ขณะที่คนจริงไม่รู้สึกถึงสิ่งเหล่านี้เลย
ขั้นตอนปฏิบัติ: ชั้นแรกแบบเรียบง่ายคือฟิลด์ honeypot ซึ่งเป็นช่องในแบบฟอร์มที่ซ่อนจากคนแต่บอตเห็น ดังนั้นการส่งแบบฟอร์มใดที่กรอกช่องนี้จึงถูกปฏิเสธได้ การตรวจสอบฝั่งเซิร์ฟเวอร์ การจำกัดอัตราต่อที่อยู่ IP และ double opt-in สำหรับรายชื่ออีเมล เป็นชั้นป้องกันเพิ่มเติม โครงสร้างนี้ได้ผลเพราะแต่ละชั้นหยุดบอตคนละชนิด ขณะที่คนจริงไม่รู้สึกถึงสิ่งเหล่านี้เลย
เปิดทางไว้สำหรับเอเจนต์ AI ที่ทำงานแทนคน
การเข้าชมอัตโนมัติบางครั้งแทนความต้องการจริง เอเจนต์ AI ที่ตรวจสอบราคาหรือจองเดโมให้ผู้ใช้ คือปฏิสัมพันธ์ของลูกค้าที่ทำโดยซอฟต์แวร์ การบล็อกทันทีอาจทำให้คุณเสียยอดขาย แต่การปล่อยผ่านโดยไม่ตรวจสอบอาจบิดเบือนเมตริกการมีส่วนร่วม
ทางสายกลางที่ใช้ได้จริงคือระบุเอเจนต์เหล่านี้แยกต่างหาก อนุญาตให้เข้าถึงหน้าสาธารณะ และวัดผลในกลุ่มของตัวเอง คู่มือของเราเรื่องทราฟฟิก AI แบบเอเจนต์ อธิบายว่าการเข้าชมที่มีเอเจนต์ช่วยปรากฏในข้อมูลวิเคราะห์อย่างไร และเตรียมหน้าเว็บของคุณให้พร้อมได้อย่างไร
ทางสายกลางที่ใช้ได้จริงคือระบุเอเจนต์เหล่านี้แยกต่างหาก อนุญาตให้เข้าถึงหน้าสาธารณะ และวัดผลในกลุ่มของตัวเอง คู่มือของเราเรื่องทราฟฟิก AI แบบเอเจนต์ อธิบายว่าการเข้าชมที่มีเอเจนต์ช่วยปรากฏในข้อมูลวิเคราะห์อย่างไร และเตรียมหน้าเว็บของคุณให้พร้อมได้อย่างไร
วิธีดูแลแคมเปญทราฟฟิกแบบชำระเงินให้สะอาด
ทราฟฟิกแบบชำระเงินคือจุดที่ทราฟฟิกจากบอททำร้ายงบประมาณโดยตรงที่สุด ทุกการคลิกหรือการแสดงผลที่ไม่ถูกต้องคือเงินที่ใช้ไปกับไม่มีใคร ความเสี่ยงสูงที่สุดกับพื้นที่โฆษณาราคาถูกและกว้าง และกับผู้ขายที่บอกไม่ได้ว่าการเข้าชมมาจากไหน เพราะแรงจูงใจของพวกเขาคือปริมาณ ไม่ใช่ผลลัพธ์
ข้อเสนอบางอย่างคือบอททราฟฟิกที่อำพรางมา สัญญาณเตือนรวมถึงคำสัญญาว่าการเข้าชม “ตรวจจับไม่ได้” หรือ “ดูเหมือนจริง” การรับประกันอันดับค้นหาที่ดีขึ้น ผู้เข้าชมไม่จำกัดในค่าบริการคงที่ และเครือข่ายพร็อกซีที่พักอาศัยซึ่งนำเสนอเป็นคุณสมบัติ แพลตฟอร์มโฆษณาที่ถูกต้องจะพูดถึงการกำหนดเป้าหมาย ตำแหน่งโฆษณา การตรวจทานหน้า Landing Page และการวัดผลแทน การซื้อการเข้าชมจากบอตให้ผลเสียเสมอ การเข้าชมไม่เกิดคอนเวอร์ชัน ทำให้การทดสอบของคุณปนเปื้อน เครือข่ายโฆษณาอาจแบนเว็บไซต์ที่สร้างรายได้ซึ่งได้รับทราฟฟิกนั้น และการซื้อเองอาจผิดกฎคุ้มครองผู้บริโภค
ข้อเสนอบางอย่างคือบอททราฟฟิกที่อำพรางมา สัญญาณเตือนรวมถึงคำสัญญาว่าการเข้าชม “ตรวจจับไม่ได้” หรือ “ดูเหมือนจริง” การรับประกันอันดับค้นหาที่ดีขึ้น ผู้เข้าชมไม่จำกัดในค่าบริการคงที่ และเครือข่ายพร็อกซีที่พักอาศัยซึ่งนำเสนอเป็นคุณสมบัติ แพลตฟอร์มโฆษณาที่ถูกต้องจะพูดถึงการกำหนดเป้าหมาย ตำแหน่งโฆษณา การตรวจทานหน้า Landing Page และการวัดผลแทน การซื้อการเข้าชมจากบอตให้ผลเสียเสมอ การเข้าชมไม่เกิดคอนเวอร์ชัน ทำให้การทดสอบของคุณปนเปื้อน เครือข่ายโฆษณาอาจแบนเว็บไซต์ที่สร้างรายได้ซึ่งได้รับทราฟฟิกนั้น และการซื้อเองอาจผิดกฎคุ้มครองผู้บริโภค
ติดแท็กทุกแหล่งที่มาที่จ่ายเงิน
ทราฟฟิกแบบชำระเงินที่ไม่ติดแท็กจะปะปนอยู่ใน Direct และ Referral ซึ่งเป็นจุดที่บอตซ่อนได้ง่าย พารามิเตอร์ UTM คือแท็กที่เพิ่มในลิงก์เพื่อบอกเครื่องมือวิเคราะห์ของคุณอย่างชัดเจนว่าแหล่งที่มา แคมเปญ และตำแหน่งโฆษณาใดส่งการเข้าชมมา
ขั้นตอนปฏิบัติ: กฎ UTM แบบง่ายแก้ช่องว่างด้านการระบุแหล่งที่มาส่วนใหญ่ได้ ทุกแคมเปญแบบชำระเงินต้องมีค่า source, medium และ campaign ของตนเอง บันทึกไว้ในชีตการตั้งชื่อร่วมกัน วิธีนี้ได้ผลเพราะการทดสอบห้าจุดต้องใช้กลุ่มที่สะอาด และหากการเข้าชมแบบชำระเงินปะปนใน Direct คุณจะบอกไม่ได้ว่าผู้ขายรายใดส่งเซสชันน่าสงสัยมา
ขั้นตอนปฏิบัติ: กฎ UTM แบบง่ายแก้ช่องว่างด้านการระบุแหล่งที่มาส่วนใหญ่ได้ ทุกแคมเปญแบบชำระเงินต้องมีค่า source, medium และ campaign ของตนเอง บันทึกไว้ในชีตการตั้งชื่อร่วมกัน วิธีนี้ได้ผลเพราะการทดสอบห้าจุดต้องใช้กลุ่มที่สะอาด และหากการเข้าชมแบบชำระเงินปะปนใน Direct คุณจะบอกไม่ได้ว่าผู้ขายรายใดส่งเซสชันน่าสงสัยมา
ทดสอบขนาดเล็กก่อนขยายผล
งบทดสอบขนาดเล็กบอกคุณได้ว่าแหล่งที่มามีพฤติกรรมเหมือนคนหรือไม่ก่อนที่คุณจะลงเงินจริง เซสชันไม่กี่ร้อยครั้งเพียงพอสำหรับการตรวจสอบห้าจุด และข้อมูลหนึ่งสัปดาห์แสดงจังหวะรายวัน วินัยเดียวกันนี้ช่วยปรับปรุงงานหน้า Landing Page ของคุณ ดังที่คู่มือของเราเรื่องการทดสอบ A/B หน้า Landing Page ด้วยทราฟฟิกแบบชำระเงิน แสดงไว้
รูปแบบโฆษณาก็สำคัญ ทราฟฟิก Popunder, Native และ Push แต่ละแบบให้รูปแบบการมีส่วนร่วมต่างกัน เพราะผู้เข้าชม Popunder มีพฤติกรรมต่างจากคนที่เลือกคลิกโฆษณา Native การตัดสินแต่ละรูปแบบเทียบกับค่าพื้นฐานของตัวเองช่วยหลีกเลี่ยงสัญญาณเตือนผิดพลาด
รูปแบบโฆษณาก็สำคัญ ทราฟฟิก Popunder, Native และ Push แต่ละแบบให้รูปแบบการมีส่วนร่วมต่างกัน เพราะผู้เข้าชม Popunder มีพฤติกรรมต่างจากคนที่เลือกคลิกโฆษณา Native การตัดสินแต่ละรูปแบบเทียบกับค่าพื้นฐานของตัวเองช่วยหลีกเลี่ยงสัญญาณเตือนผิดพลาด
มองนโยบายคืนเงินและเครดิตเป็นสัญญาณคุณภาพ
แพลตฟอร์มที่น่าเชื่อถือคาดหวังให้คุณตรวจสอบทราฟฟิกของตน และอธิบายว่าควรทำอย่างไรเมื่อมีสิ่งผิดปกติ แพลตฟอร์มที่ดีมีกระบวนการชัดเจน ต้องการหลักฐานอะไร ตรวจทานรายงานอย่างไร และให้เครดิตกับกิจกรรมที่ไม่ถูกต้องหรือไม่ ผู้ขายที่ปฏิเสธการตรวจทาน หรืออ้างว่าทราฟฟิก “เป็นมนุษย์ 100%” กำลังบอกบางอย่างแก่คุณ แม้แต่ MRC ก็หลีกเลี่ยงการเรียกทราฟฟิกที่ผ่านการกรองว่า “มนุษย์” และเลือกใช้คำว่า “ใช้ได้” เพราะไม่มีตัวกรองใดรับประกันได้ว่าการเข้าชมที่เหลือทุกครั้งเป็นคน
กลยุทธ์ขั้นสูง: ตรวจสอบทราฟฟิกจากบอทรายเดือน
การตรวจสอบครั้งเดียวแก้ปัญหาครั้งเดียว บอตเปลี่ยน แคมเปญเปลี่ยน และเครื่องมือของคุณก็เปลี่ยน ดังนั้นกิจวัตรรายเดือนสั้น ๆ จะจับปัญหาได้ก่อนที่มันจะบิดเบือนการตัดสินใจตลอดไตรมาส เป้าหมายไม่ใช่ทราฟฟิกจากบอตเป็นศูนย์ เพราะเป็นไปไม่ได้ เป้าหมายคือทราฟฟิกจากบอตที่ทราบ วัดผล และบันทึกไว้
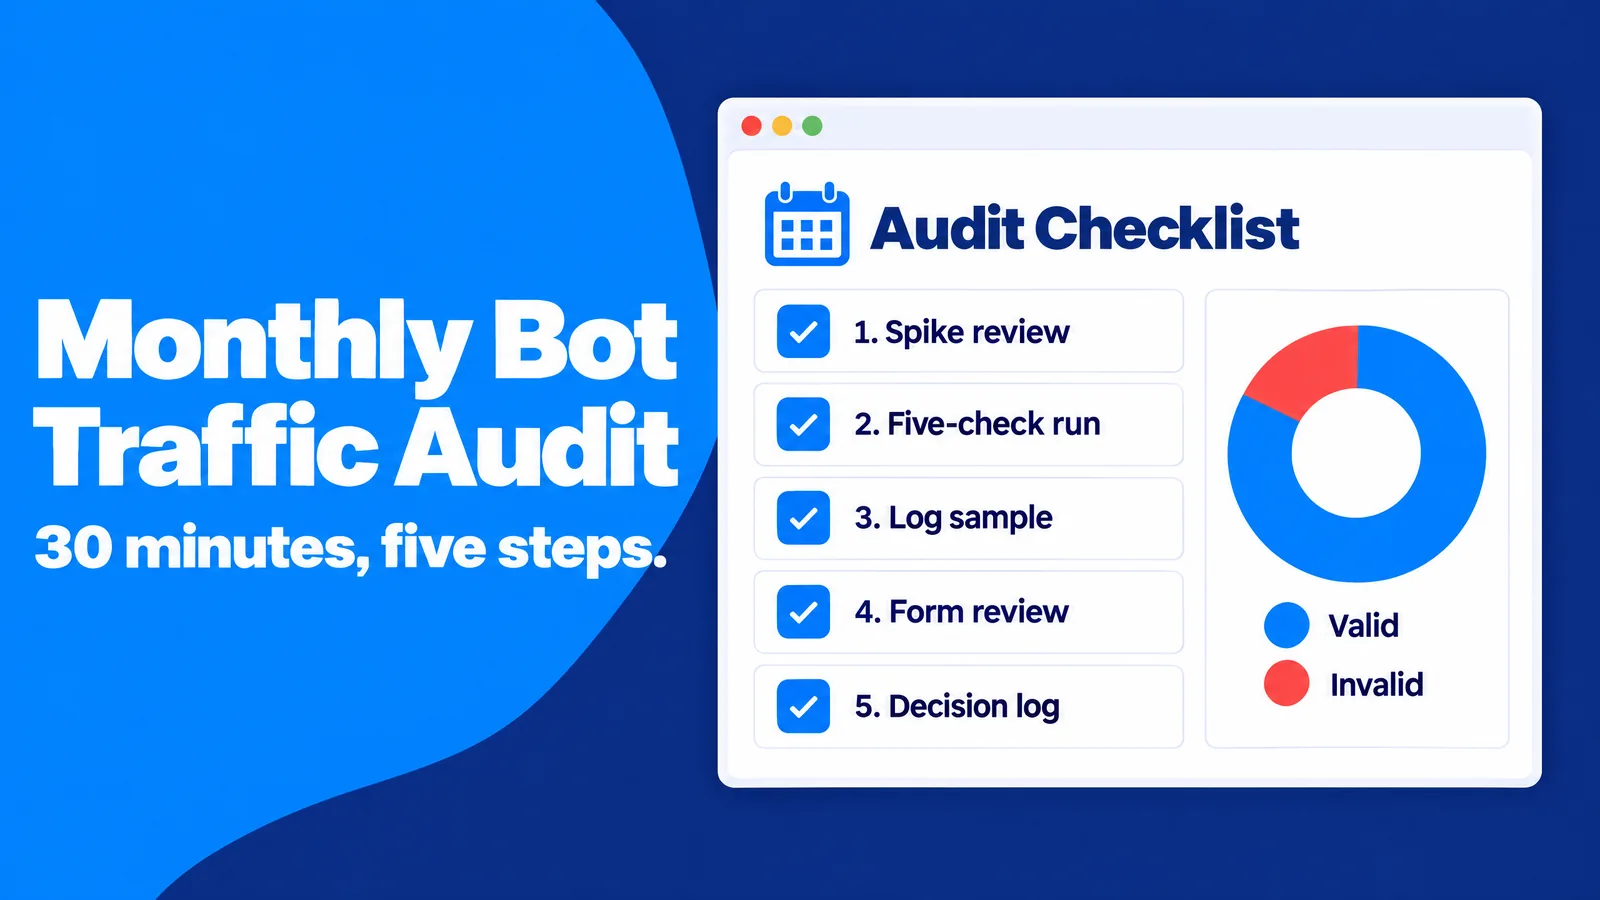
กิจวัตรรายเดือน 30 นาที
การตรวจสอบที่ทำซ้ำได้ผลดีที่สุดเมื่อทำตามขั้นตอนเดิมทุกครั้ง เพื่อให้มองเห็นแนวโน้ม:
- ตรวจสอบยอดพุ่ง: ใส่คำอธิบายสาเหตุให้ยอดทราฟฟิกที่พุ่งขึ้นทุกครั้งในเดือนที่ผ่านมา หรือทำเครื่องหมายว่ายังอธิบายไม่ได้
- ตรวจสอบ 5 จุด: ให้คะแนนแหล่งที่มาหลักและทุกแคมเปญเทียบกับการตรวจสอบห้าจุด
- ตัวอย่างบันทึก: ยืนยันโปรแกรมรวบรวมข้อมูลที่อ้างตัวเป็นรายหลักด้วย forward-confirmed reverse DNS
- ตรวจสอบแบบฟอร์ม: ตรวจการสมัครและลีดว่ามีชื่อเหมือนกัน โดเมนอีเมลใช้ครั้งเดียว หรือการเพิ่มขึ้นอย่างฉับพลันหรือไม่
- บันทึกการตัดสินใจ: เก็บบันทึกสิ่งที่คุณกรอง บล็อก หรือรายงาน พร้อมเหตุผล
กิจวัตรนี้ได้ผลเพราะเปลี่ยนการตรวจจับบอตให้เป็นนิสัยที่มีหลักฐานเป็นลายลักษณ์อักษร เมื่อผู้มีส่วนได้ส่วนเสียถามว่าทำไมตัวเลขเดือนมีนาคมจึงเปลี่ยน คุณมีคำตอบ
เขียนนโยบายทราฟฟิกไม่ถูกต้องหนึ่งหน้า
แม้แต่ผู้เชี่ยวชาญยังนิยามทราฟฟิกไม่ถูกต้องได้อย่างแม่นยำยาก Tuzhilin Report ซึ่งเป็นการทบทวนอิสระเรื่องการตรวจจับการฉ้อโกงคลิกของ Google ที่อธิบายในบทความ Wikipedia เรื่อง click fraud สรุปว่า “ไม่มีคำนิยามเชิงแนวคิดของการคลิกที่ไม่ถูกต้องซึ่งนำไปใช้ปฏิบัติได้” ยกเว้นกรณีชัดเจน หากอุตสาหกรรมยังตกลงเรื่องคำนิยามเดียวไม่ได้ ทีมของคุณยิ่งได้ประโยชน์จากการมีคำนิยามของตนเอง
ขั้นตอนปฏิบัติ: นโยบายหนึ่งหน้าช่วยยุติข้อโต้แย้งส่วนใหญ่ล่วงหน้า ระบุว่าผู้เข้าชมอัตโนมัติรายใดที่คุณอนุญาต เกณฑ์ใดกระตุ้นการตรวจทาน ใครเป็นผู้ตัดสิน และรายงานผลต่อเอเจนซีและผู้ขายอย่างไร วิธีนี้ได้ผลเพราะกฎเป็นลายลักษณ์อักษรแทนที่การถกเถียงเป็นกรณี ๆ และให้มาตรฐานชัดเจนแก่พาร์ทเนอร์
ขั้นตอนปฏิบัติ: นโยบายหนึ่งหน้าช่วยยุติข้อโต้แย้งส่วนใหญ่ล่วงหน้า ระบุว่าผู้เข้าชมอัตโนมัติรายใดที่คุณอนุญาต เกณฑ์ใดกระตุ้นการตรวจทาน ใครเป็นผู้ตัดสิน และรายงานผลต่อเอเจนซีและผู้ขายอย่างไร วิธีนี้ได้ผลเพราะกฎเป็นลายลักษณ์อักษรแทนที่การถกเถียงเป็นกรณี ๆ และให้มาตรฐานชัดเจนแก่พาร์ทเนอร์
ติดตามเมตริกที่บอตปลอมได้ไม่คุ้มค่า
ยอดดูหน้าเว็บและเซสชันปลอมได้ง่าย รายได้ ลีดที่ผ่านคุณสมบัติ การซื้อซ้ำ ทิกเก็ตซัพพอร์ต และผู้ใช้ที่กลับมาแล้วเข้าสู่ระบบ ปลอมได้ยากหรือเป็นไปไม่ได้ในวงกว้าง แหล่งทราฟฟิกที่เพิ่มเซสชันแต่ไม่เคยทำให้ตัวเลขเหล่านี้ขยับสมควรได้รับการตรวจสอบ ไม่ว่าการมีส่วนร่วมจะดูดีเพียงใด
การยึดรายงานของคุณกับเมตริกผลลัพธ์เหล่านี้เป็นแนวป้องกันระยะยาวที่แข็งแกร่งที่สุด มันทำให้ทุกการตัดสินใจด้านทราฟฟิกสอดคล้องกับสิ่งที่ผู้คนทำจริง และตัดแรงจูงใจไม่ให้ใครในห่วงโซ่อุปทานของคุณปั่นตัวเลข
การยึดรายงานของคุณกับเมตริกผลลัพธ์เหล่านี้เป็นแนวป้องกันระยะยาวที่แข็งแกร่งที่สุด มันทำให้ทุกการตัดสินใจด้านทราฟฟิกสอดคล้องกับสิ่งที่ผู้คนทำจริง และตัดแรงจูงใจไม่ให้ใครในห่วงโซ่อุปทานของคุณปั่นตัวเลข
คำถามที่พบบ่อยเกี่ยวกับบอททราฟฟิก
บอททราฟฟิกคืออะไรแบบเข้าใจง่าย
บอททราฟฟิกคือซอฟต์แวร์ที่เข้าเว็บไซต์หรือคลิกโฆษณาอัตโนมัติ เพื่อให้กิจกรรมดูเหมือนมาจากผู้คนจริง โดยปกติจะปั่นตัวชี้วัด เช่น ยอดดูหน้าเว็บ การคลิก ยอดดูวิดีโอ หรือจำนวนผู้ติดตาม
ทราฟฟิกจากบอททุกชนิดไม่ดีหรือไม่
ไม่ใช่ โปรแกรมรวบรวมข้อมูลของเสิร์ชเอนจิน เครื่องมือตรวจสอบสถานะ และโปรแกรมรวบรวมข้อมูล AI จำนวนมากมีประโยชน์ ทราฟฟิกจากบอทจะเป็นปัญหาเมื่อมันแสร้งเป็นมนุษย์ ใช้งบโฆษณาโดยเปล่าประโยชน์ ดึงคอนเทนต์ขัดกับกฎของคุณ หรือบิดเบือนข้อมูลวิเคราะห์
ทราฟฟิกจากบอททำร้าย SEO ของฉันได้หรือไม่
การเข้าชมปลอมไม่ช่วยให้อันดับดีขึ้น เพราะเสิร์ชเอนจินพึ่งพาสัญญาณคุณภาพหลายอย่าง ไม่ใช่จำนวนการเข้าชมดิบ ทราฟฟิกจากบอทอาจสร้างผลเสียทางอ้อมได้ ด้วยการทำให้เซิร์ฟเวอร์ช้าลง คัดลอกคอนเทนต์ และชักนำให้คุณปรับแต่งหน้าที่ผิดจากข้อมูลปนเปื้อน
Google Analytics 4 กรองทราฟฟิกจากบอตโดยอัตโนมัติหรือไม่
ใช่ GA4 ตัดบอตและสไปเดอร์ที่รู้จักออกโดยอัตโนมัติ และคุณปิดการทำงานนี้หรือดูไม่ได้ว่าระบบตัดออกไปเท่าไร บอตที่ไม่รู้จักและซับซ้อนยังเข้ามาในรายงานของคุณได้ ดังนั้นการเปรียบเทียบกลุ่มและการตรวจสอบห้าจุดจึงยังจำเป็น
ทราฟฟิกจากบอทเท่าไรจึงถือว่าปกติ
ไม่มีตัวเลขสากล ทราฟฟิกเว็บมากกว่าครึ่งเป็นระบบอัตโนมัติ แต่ส่วนใหญ่ไม่เคยรันโค้ดวิเคราะห์ของคุณ เกณฑ์เปรียบเทียบที่ใช้งานได้จริงคือช่องทางค่าพื้นฐานที่คุณเชื่อถือ แหล่งที่มาใดเบี่ยงเบนจากค่านั้นมากสมควรได้รับการตรวจสอบใกล้ชิดขึ้น
ฉันจะหยุดทราฟฟิกจากบอทบนเว็บไซต์ได้อย่างไร
แนวทางที่มีประสิทธิภาพที่สุดเป็นแบบไล่ระดับ อนุญาตโปรแกรมรวบรวมข้อมูลที่ยืนยันแล้ว จำกัดอัตราโปรแกรมรวบรวมข้อมูลที่รุกล้ำ ท้าทายทราฟฟิกที่ยังไม่ยืนยันเฉพาะตอนเข้าสู่ระบบและในแบบฟอร์ม และบล็อกผู้ละเมิดที่พิสูจน์แล้ว ฟิลด์ honeypot การตรวจสอบฝั่งเซิร์ฟเวอร์ และตัวกรอง hostname กับทราฟฟิกภายในของ GA4 ช่วยให้ทั้งแบบฟอร์มและรายงานของคุณสะอาด
จะรู้ได้อย่างไรว่าทราฟฟิกเว็บไซต์ของฉันมาจากบอต
วิธีเร็วที่สุดคือเปรียบเทียบแหล่งที่มาน่าสงสัยกับช่องทางที่คุณเชื่อถือในห้ามิติ ได้แก่ ระยะเวลาเซสชัน ความละเอียดหน้าจอ ช่วงเวลาของวัน ตำแหน่งที่ตั้ง และการโต้ตอบ การไม่ผ่านอย่างชัดเจนตั้งแต่สองข้อขึ้นไป เช่น ระยะเวลาเซสชันเหมือนกันและปริมาณกะดึกเท่าช่วงกลางวัน บ่งชี้อย่างมากว่าเป็นทราฟฟิกอัตโนมัติ บันทึกเซิร์ฟเวอร์และ forward-confirmed reverse DNS จะยืนยันต่อไปได้ว่าโปรแกรมรวบรวมข้อมูลที่ระบุตัวเองเป็นของจริงหรือไม่
การซื้อทราฟฟิกจากบอตถูกกฎหมายหรือไม่
กฎแตกต่างกันไปตามประเทศ แต่การซื้อการมีส่วนร่วมปลอมเพื่อใช้เชิงพาณิชย์มีความเสี่ยงจริงทั้งด้านกฎหมายและธุรกิจ ในสหรัฐอเมริกา กฎปี 2024 ของ FTC ห้ามซื้อหรือขายสัญญาณอิทธิพลบนโซเชียลมีเดียปลอม เช่น ผู้ติดตามหรือยอดดูที่บอตสร้างขึ้น เพื่อวัตถุประสงค์เชิงพาณิชย์ เครือข่ายโฆษณาก็ห้ามทราฟฟิกปลอมในนโยบายของตนเช่นกัน
สรุป: วัดผลเพื่อผู้คน ไม่ใช่เพื่อตัวเลข
บอททราฟฟิกมีอยู่เพราะกิจกรรมปลอมสร้างได้ง่ายและขายได้ง่าย การป้องกันของคุณคือภาพที่ชัดเจนว่าผู้คนจริงมีลักษณะอย่างไรบนเว็บไซต์ การตรวจสอบห้าจุด ค่าพื้นฐานที่เชื่อถือได้ การยืนยันระดับเซิร์ฟเวอร์ และการตรวจสอบรายเดือน มอบภาพนั้นให้คุณได้โดยไม่ต้องใช้เครื่องมือราคาแพง
เว็บยุคเก่าให้รางวัลกับตัวเลขใหญ่ เว็บปัจจุบันให้รางวัลกับความไว้วางใจ เสิร์ชเอนจิน ผู้ลงโฆษณา ระบบ AI และลูกค้า ต่างตอบสนองต่อการมีส่วนร่วมที่แท้จริง เมื่อคุณปกป้องข้อมูลจากบอต คุณปกป้องทุกการตัดสินใจที่อาศัยข้อมูลนั้น และคงความสนใจไว้ที่กลุ่มเป้าหมายที่ซื้อ สมัคร และกลับมาอีกครั้ง นั่นคือผู้คนจริง
เว็บยุคเก่าให้รางวัลกับตัวเลขใหญ่ เว็บปัจจุบันให้รางวัลกับความไว้วางใจ เสิร์ชเอนจิน ผู้ลงโฆษณา ระบบ AI และลูกค้า ต่างตอบสนองต่อการมีส่วนร่วมที่แท้จริง เมื่อคุณปกป้องข้อมูลจากบอต คุณปกป้องทุกการตัดสินใจที่อาศัยข้อมูลนั้น และคงความสนใจไว้ที่กลุ่มเป้าหมายที่ซื้อ สมัคร และกลับมาอีกครั้ง นั่นคือผู้คนจริง