Theo tổng quan của Wikipedia về bot internet, hơn một nửa tổng lưu lượng truy cập web được tạo ra bởi bot. Một phần tự động hóa này giúp web vận hành. Trình thu thập dữ liệu của công cụ tìm kiếm lập chỉ mục các trang của bạn, còn công cụ giám sát thời gian hoạt động xác nhận rằng trang thanh toán của bạn vẫn tải được lúc 3 giờ sáng.
Một tỷ trọng ngày càng lớn của lưu lượng tự động lại làm điều khác. Nó bắt chước con người, làm phồng các chỉ số và rút cạn ngân sách quảng cáo vốn dành cho khách hàng thật. Juniper Research ước tính rằng gian lận quảng cáo đã khiến nhà quảng cáo thiệt hại 88 tỷ USD vào năm 2023, và phần lớn gian lận đó diễn ra qua lượt truy cập và lượt nhấp tự động.
Với bạn là người làm marketing, chi phí lớn hơn thường không thể nhìn thấy. Ngân sách, kế hoạch nội dung và quyết định về trang đích có thể dựa trên những lượt truy cập mà chưa từng có con người nào tạo ra.
Hướng dẫn này giải thích bot traffic là gì, vì sao bot traffic tồn tại và cách bạn phát hiện nó trong công cụ phân tích và nhật ký máy chủ. Chúng ta sẽ đi từ định nghĩa đến quy trình phát hiện thực tế, rồi đến các thói quen kiểm tra nâng cao. Một nguyên tắc xuyên suốt: công cụ tìm kiếm và hệ thống AI đọc trang của bạn, nhưng đối tượng quan trọng luôn là con người thật.
Bot Traffic Là Gì?
Thuật ngữ "traffic bot" được dùng khá lỏng lẻo, và điều đó gây nhầm lẫn ngay trước khi bất kỳ phân tích nào bắt đầu. Nhà phát triển có thể dùng thuật ngữ này cho một tập lệnh kiểm thử tải. Người bán trên chợ việc tự do có thể dùng nó cho phần mềm hứa hẹn "10.000 khách truy cập mỗi ngày". Nhóm bảo mật có thể dùng nó cho bất cứ thứ gì không phải là con người, và khi ba người trong một cuộc họp đều hiểu theo ba cách khác nhau, cả nhóm sẽ tranh cãi về nhãn thay vì xử lý vấn đề.
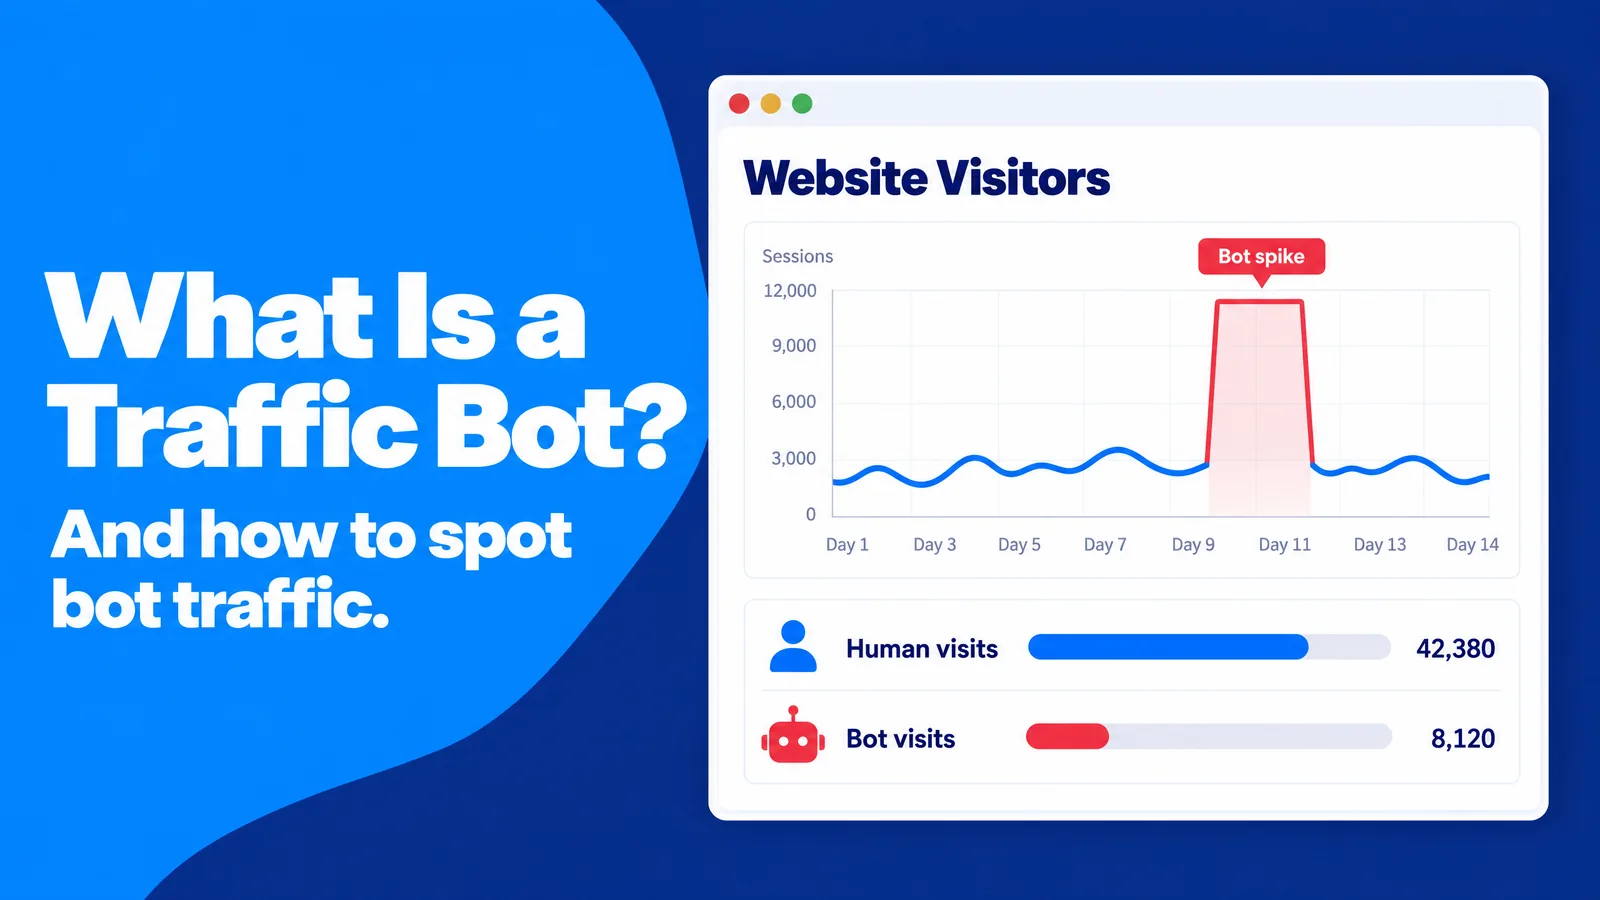
Trong hướng dẫn này, traffic bot là chương trình phần mềm gửi lượt truy cập tự động đến website, ứng dụng hoặc quảng cáo để hoạt động trông như đến từ con người. Mục đích của nó thường là làm phồng một chỉ số như lượt xem trang, lượt hiển thị quảng cáo, lượt nhấp, lượt xem video hoặc người theo dõi. Traffic bot là một loại bot internet, tức ứng dụng phần mềm thực hiện các tác vụ tự động trên internet.
Trong hướng dẫn này, traffic bot là chương trình phần mềm gửi lượt truy cập tự động đến website, ứng dụng hoặc quảng cáo để hoạt động trông như đến từ con người. Mục đích của nó thường là làm phồng một chỉ số như lượt xem trang, lượt hiển thị quảng cáo, lượt nhấp, lượt xem video hoặc người theo dõi. Traffic bot là một loại bot internet, tức ứng dụng phần mềm thực hiện các tác vụ tự động trên internet.
Traffic Bot và Bot Traffic
Bot traffic là phạm trù rộng hơn. Nó bao gồm mọi lượt truy cập hoặc yêu cầu do chương trình tạo ra thay vì con người, bất kể mục đích là gì. Khi Googlebot thu thập dữ liệu blog của bạn, đó là bot traffic. Tuy vậy, không ai gọi Googlebot là traffic bot, vì nó tự nhận diện, tuân theo quy tắc thu thập dữ liệu của bạn và không giả làm người mua sắm.
Sự khác biệt này quyết định cách bạn phản hồi. Bot traffic từ crawler đã tự khai báo cần được quản lý: bạn quyết định những gì nó được truy cập. Lượt truy cập từ traffic bot cần được phát hiện và loại trừ, vì mục đích của traffic bot là hòa lẫn vào khách truy cập là con người của bạn.
Sự khác biệt này quyết định cách bạn phản hồi. Bot traffic từ crawler đã tự khai báo cần được quản lý: bạn quyết định những gì nó được truy cập. Lượt truy cập từ traffic bot cần được phát hiện và loại trừ, vì mục đích của traffic bot là hòa lẫn vào khách truy cập là con người của bạn.
Bot Tốt, Bot Xấu và Vùng Xám
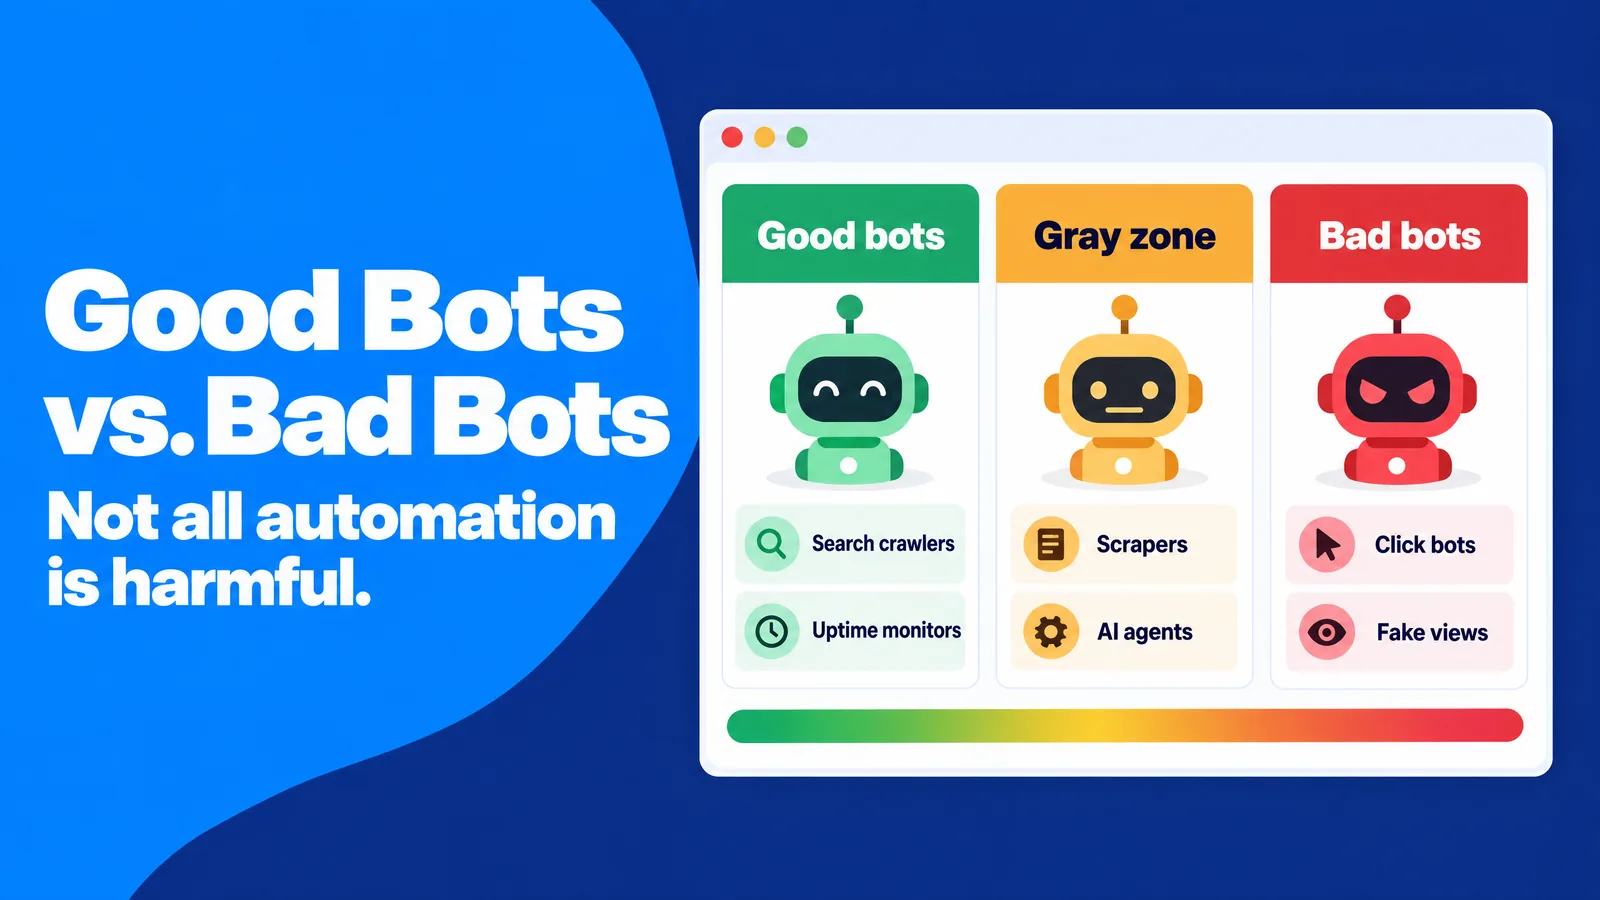
Ngành quảng cáo có một hệ thuật ngữ hữu ích cho vấn đề này. Media Rating Council (MRC), cơ quan Hoa Kỳ công nhận hoạt động đo lường quảng cáo, chia lưu lượng không hợp lệ thành hai nhóm trong tiêu chuẩn về lưu lượng không hợp lệ:
- Lưu lượng không hợp lệ tổng quát (GIVT): crawler đã biết, lưu lượng từ trung tâm dữ liệu và hoạt động tự động khác mà bộ lọc dựa trên danh sách có thể bắt được.
- Lưu lượng không hợp lệ tinh vi (SIVT): bot bắt chước hành vi con người, thiết bị bị chiếm quyền, mã độc và hoạt động được khuyến khích, cần phân tích sâu hơn để nhận diện.
Giữa phần rõ ràng là tốt và rõ ràng là xấu có một vùng xám. Trình quét theo dõi giá, crawler của công cụ SEO, crawler huấn luyện AI và tác nhân AI duyệt web thay mặt con người đều là tự động. Việc chúng có được chào đón hay không phụ thuộc vào mô hình kinh doanh của bạn, chứ không phải một quy tắc chung.
Các Loại Traffic Bot Phổ Biến
Traffic bot có một vài nhóm dễ nhận biết. Biết các nhóm này giúp bạn đoán mình đang đối mặt với loại nào qua mẫu dấu vết mà nó để lại:
- Bot nhấp chuột nhấp vào quảng cáo hoặc kết quả tìm kiếm để làm cạn ngân sách của đối thủ hoặc tạo tương tác giả, một hành vi gọi là gian lận nhấp chuột.
- Bot lượt hiển thị tải quảng cáo trên các trang giả mạo hoặc ngụy trang để nhà quảng cáo trả tiền cho những lượt xem mà không ai thực sự thấy.
- Chương trình autosurf và trao đổi lưu lượng truy cập luân chuyển trang giữa các thành viên, để mọi website đều ghi nhận "lượt truy cập" mà không ai đọc.
- Bot spam referrer chèn URL vào báo cáo giới thiệu của bạn để dụ bạn truy cập, một chiến thuật gọi là referrer spam.
- Trình duyệt headless là trình duyệt đầy đủ nhưng không có màn hình. Nhà phát triển dùng chúng để kiểm thử, còn kẻ gian lận đã lạm dụng chúng để làm phồng lượt hiển thị quảng cáo.
- Click farm sử dụng người được trả công thấp thay vì mã. Khách truy cập về mặt kỹ thuật là con người, nhưng mục đích là giả tạo, nên các tiêu chuẩn đo lường xem hoạt động đó là không hợp lệ.
Bước thực hành: Điểm khởi đầu hữu ích là lập một danh mục một trang về các hoạt động tự động mà bạn chủ động mời vào. Danh mục này liệt kê crawler tìm kiếm, công cụ giám sát thời gian hoạt động, crawler SEO, webhook thanh toán và trợ lý AI mà bạn muốn nhận trích dẫn, kèm user agent mà từng công cụ tự khai báo. Cách này hiệu quả vì nhiều cảnh báo nhầm đến từ chính công cụ của bạn: một lượt quét SEO lên lịch lúc 3 giờ sáng trông y hệt một đợt tăng đột biến đáng ngờ vào ban đêm, cho đến khi bạn kiểm tra danh mục.
Vì Sao Khách Truy Cập Thật Có Dấu Vết Dễ Nhận Biết
Phần lớn lời khuyên về bot traffic bắt đầu từ những gì trông có vẻ sai. Điểm khởi đầu đáng tin cậy hơn là hiểu thế nào là bình thường, vì bạn không thể đánh giá bất thường nếu không có đường cơ sở.
Khách truy cập là con người không hề nhất quán. Một người đọc trang giá của bạn trên điện thoại khi đang di chuyển trong 40 giây. Người khác để một tab trên máy tính mở 12 phút, và người thứ ba rời đi sau hai giây vì chạm nhầm kết quả.
Sự lộn xộn đó là tín hiệu mạnh nhất bạn có. Mỗi lượt truy cập của con người mang hàng chục biến thiên nhỏ: kích thước màn hình, phiên bản trình duyệt, múi giờ, tốc độ cuộn, khoảng dừng trước khi nhấp. Lưu lượng tự động khó sao chép đầy đủ sự đa dạng này ở quy mô lớn, vì mỗi biến thiên mới khiến người vận hành bot tốn thêm thời gian kỹ thuật và hạ tầng. Mạng bot có thể làm giả thuyết phục một hoặc hai khía cạnh, nhưng làm giả tất cả cùng lúc cho hàng nghìn phiên là tốn kém.
SparkTraffic, một nền tảng quảng cáo đã cung cấp lượt truy cập website nhắm mục tiêu theo vị trí thông qua quảng cáo trên các trang của nhà xuất bản đối tác từ năm 2015, dựa trên nguyên tắc đa dạng này trong bài kiểm tra năm tiêu chí mà họ công bố cho chính các nhà quảng cáo của mình. Lý do rất đơn giản: bất kỳ ai trả tiền cho lượt truy cập cũng phải có thể xác nhận, bằng công cụ phân tích tiêu chuẩn và không cần công cụ đặc biệt, rằng các lượt truy cập đó hành xử như con người. Các tiêu chí này áp dụng được cho mọi nguồn, trả phí hoặc tự nhiên, nên chúng tạo thành đường cơ sở đa dụng tốt cho báo cáo của bạn.
Bài Kiểm Tra Dấu Vết Con Người Với Năm Tiêu Chí
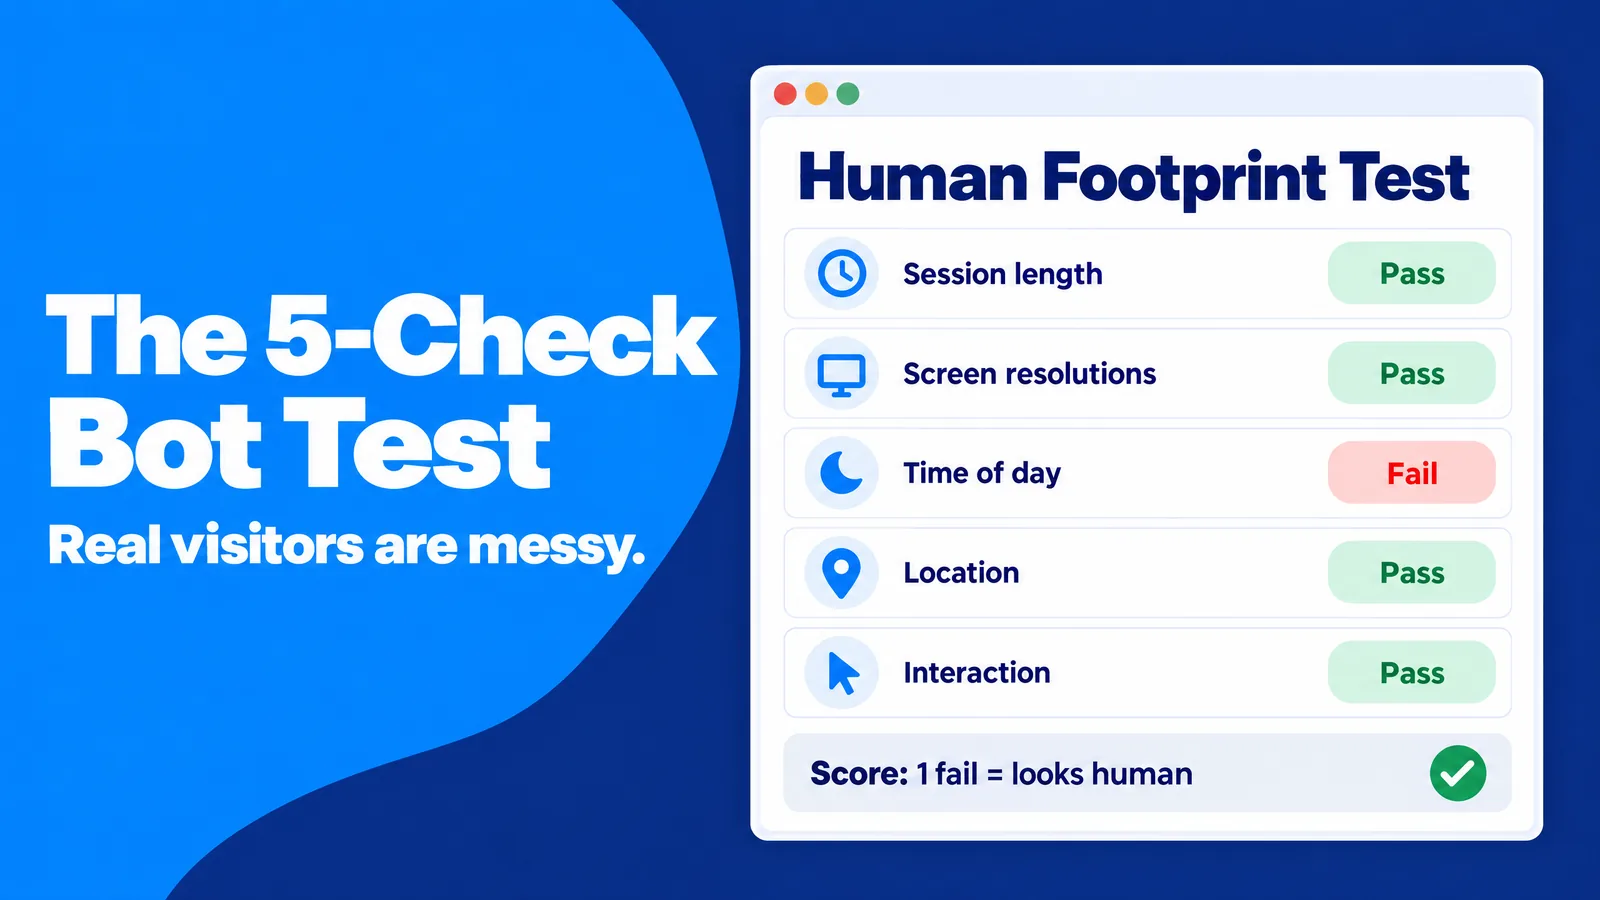
Mỗi tiêu chí so sánh một khía cạnh hành vi với sự đa dạng bạn kỳ vọng ở người thật. Các ngưỡng được cố ý đặt rộng để mẫu nhỏ và biến động bình thường không kích hoạt cảnh báo nhầm:
- Thời lượng phiên: lưu lượng lành mạnh trải từ dưới 10 giây đến hơn hai phút. Dấu hiệu cảnh báo là hơn một nửa phiên rơi vào cùng một khoảng năm giây.
- Độ phân giải màn hình: lưu lượng lành mạnh có nhiều độ phân giải khác nhau. Dấu hiệu cảnh báo là một độ phân giải chiếm hơn một nửa số phiên.
- Thời điểm trong ngày: lưu lượng lành mạnh tuân theo mô hình ban ngày tại địa phương. Dấu hiệu cảnh báo là lưu lượng từ 1 giờ đến 5 giờ sáng bằng mức ban ngày.
- Vị trí: lưu lượng nhắm mục tiêu lành mạnh có hơn 90% lượt truy cập từ khu vực được nhắm đến. Dấu hiệu cảnh báo là hơn 10% đến từ nơi bạn không nhắm mục tiêu.
- Tương tác: lưu lượng lành mạnh có một số lượt cuộn, nhấp hoặc bắt đầu điền biểu mẫu. Dấu hiệu cảnh báo là không có tương tác nào trong 300 phiên.
Không có hoặc chỉ một tiêu chí không đạt cho thấy lưu lượng hành xử như con người. Hai lỗi trở lên là lý do để tạm dừng nguồn, xuất khoảng 20 phiên làm bằng chứng và yêu cầu nhà cung cấp xem xét. Cách chấm điểm này hiệu quả vì một chỉ số bất thường đơn lẻ thường có nguyên nhân vô hại, như chiến dịch chỉ trên di động làm thu hẹp các kích thước màn hình, trong khi nhiều lỗi cùng lúc hiếm khi như vậy.
Xây Dựng Đường Cơ Sở Con Người Của Riêng Bạn
Ngưỡng chung là điểm bắt đầu, không phải kết luận. Blog công thức, trang tài liệu SaaS và nha sĩ địa phương đều có thời lượng phiên và nhịp điệu hằng ngày khác nhau. Phiên trung bình năm phút có thể đáng ngờ trên trang tìm cửa hàng, nhưng hoàn toàn bình thường trong một hướng dẫn dài.
Bước thực hành: Chuẩn đối chiếu đáng tin cậy nhất là một kênh bạn đã tin tưởng, chẳng hạn lượt nhấp newsletter hoặc khách hàng đã đăng nhập. Ghi lại phân bố của kênh đó theo năm khía cạnh nêu trên trong 30 ngày sẽ cho bạn một đường cơ sở, và mọi nguồn mới trông bất thường có thể được so sánh với nó thay vì mức trung bình ngành. Điều này hiệu quả vì kênh đáng tin cậy đã phản ánh đối tượng, thiết bị và múi giờ của bạn, nên độ lệch lớn cho thấy vấn đề nằm ở nguồn thay vì website.
Bước thực hành: Chuẩn đối chiếu đáng tin cậy nhất là một kênh bạn đã tin tưởng, chẳng hạn lượt nhấp newsletter hoặc khách hàng đã đăng nhập. Ghi lại phân bố của kênh đó theo năm khía cạnh nêu trên trong 30 ngày sẽ cho bạn một đường cơ sở, và mọi nguồn mới trông bất thường có thể được so sánh với nó thay vì mức trung bình ngành. Điều này hiệu quả vì kênh đáng tin cậy đã phản ánh đối tượng, thiết bị và múi giờ của bạn, nên độ lệch lớn cho thấy vấn đề nằm ở nguồn thay vì website.
Vì Sao Traffic Bot Tồn Tại và Cái Giá Bạn Phải Trả
Traffic bot tồn tại vì có người hưởng lợi từ hoạt động giả. Lợi nhuận có thể trực tiếp, như trong gian lận quảng cáo, hoặc gián tiếp, như nhà cung cấp bán "traffic" khiến bảng điều khiển trông bận rộn. Hiểu động cơ giúp bạn dự đoán mẫu hình: kẻ gian lận muốn lượt hiển thị và lượt nhấp, người bán chỉ số phù phiếm muốn lượt xem trang, còn kẻ spam muốn sự chú ý của bạn.
Gian Lận Quảng Cáo Ở Quy Mô Công Nghiệp
Ví dụ được ghi nhận đầy đủ nhất là Methbot. Theo Bộ Tư pháp Hoa Kỳ, chiến dịch này dùng hơn 1.900 máy chủ và hơn 650.000 địa chỉ IP để tải quảng cáo trên hơn 5.000 website giả mạo, thu về hơn 7 triệu USD. Một âm mưu liên quan, 3ve, vận hành trên khoảng 1,7 triệu máy tính bị nhiễm và lấy đi hơn 29 triệu USD.
Các bot được xây để trông như con người. Thông báo tuyên án của DOJ mô tả các bot giả chuyển động chuột, cuộn trang và đăng nhập mạng xã hội, còn người vận hành chính nhận án tù 10 năm. Bài học cho marketer là chỉ riêng "tương tác thực tế" không chứng minh điều gì, vì Methbot được thiết kế để tạo ra chính điều đó.
Các bot được xây để trông như con người. Thông báo tuyên án của DOJ mô tả các bot giả chuyển động chuột, cuộn trang và đăng nhập mạng xã hội, còn người vận hành chính nhận án tù 10 năm. Bài học cho marketer là chỉ riêng "tương tác thực tế" không chứng minh điều gì, vì Methbot được thiết kế để tạo ra chính điều đó.
Sự Phổ Biến Giả và Các Chỉ Số Phù Phiếm
Động cơ thứ hai là vẻ ngoài phổ biến. Một số nhà cung cấp bán phần mềm traffic bot hoặc "gói khách truy cập" làm phồng lượt xem trang, lượt xem video hoặc số người theo dõi. Trong thời kỳ đầu của web, bộ đếm lượt truy cập thô gây ấn tượng và các con số phồng lên có lợi ích ngắn hạn. Ngày nay, công cụ tìm kiếm, nhà quảng cáo và nhà đầu tư nhìn vào tương tác, chuyển đổi và doanh thu, nên khối lượng giả không mua được gì và làm nhiễm bẩn dữ liệu bạn cần.
Cơ quan quản lý hiện coi sự phổ biến giả là lừa dối. Tháng 8 năm 2024, Ủy ban Thương mại Liên bang Hoa Kỳ đã hoàn thiện quy tắc cấm bán hoặc mua chỉ dấu ảnh hưởng mạng xã hội giả, như người theo dõi hoặc lượt xem do bot tạo ra. Lệnh cấm áp dụng khi bên mua biết hoặc đáng lẽ phải biết các chỉ dấu là giả và dùng chúng cho mục đích thương mại. Chính sách quảng cáo của Google cũng cấm quảng bá dịch vụ bán hoạt động người dùng bị làm giả, như lượt nhấp không hợp lệ.
Cơ quan quản lý hiện coi sự phổ biến giả là lừa dối. Tháng 8 năm 2024, Ủy ban Thương mại Liên bang Hoa Kỳ đã hoàn thiện quy tắc cấm bán hoặc mua chỉ dấu ảnh hưởng mạng xã hội giả, như người theo dõi hoặc lượt xem do bot tạo ra. Lệnh cấm áp dụng khi bên mua biết hoặc đáng lẽ phải biết các chỉ dấu là giả và dùng chúng cho mục đích thương mại. Chính sách quảng cáo của Google cũng cấm quảng bá dịch vụ bán hoạt động người dùng bị làm giả, như lượt nhấp không hợp lệ.
Referrer Spam và Ghost Traffic
Động cơ thứ ba là sự chú ý. Bot spam referrer truy cập website của bạn, hoặc gửi dữ liệu thẳng đến thuộc tính phân tích của bạn, với URL giới thiệu giả. Khi bạn thấy một tên miền lạ trong báo cáo giới thiệu, sự tò mò sẽ hoàn tất phần còn lại và kẻ spam có được một lượt truy cập hoặc một giao dịch. Bài viết của Wikipedia về referrer spam mô tả cách chiến thuật này chuyển từ nhật ký máy chủ sang công cụ phân tích.
Chi Phí Thực: Quyết Định Dựa Trên Dữ Liệu Giả
Chi phí trực tiếp của bot traffic là chi tiêu quảng cáo lãng phí và tải máy chủ. Chi phí gián tiếp thường lớn hơn. Hãy tưởng tượng một thử nghiệm A/B, trong đó biến thể B nhận thêm 600 phiên bot nhưng không có chuyển đổi: tỷ lệ chuyển đổi của B giảm, bạn giữ lại trang kém hơn và không ai biết tại sao. Hoặc tưởng tượng một nhóm nội dung tập trung gấp đôi vào một chủ đề vì trình quét thu thập các bài viết đó mỗi giờ.
Bước thực hành: Ước tính chi phí nhiễm bẩn giúp vấn đề trở nên cụ thể. Nó nhân tỷ lệ phiên không đạt từ hai trong năm tiêu chí trở lên với chi tiêu truyền thông trả phí của bạn trong quý. Sau đó, nó liệt kê mọi quyết định (điều chỉnh ngân sách, biến thể thắng thử nghiệm, ưu tiên nội dung) đã dựa vào các báo cáo đó. Cách này hiệu quả vì biến một vấn đề chất lượng dữ liệu trừu tượng thành con số ngân sách, giúp việc phê duyệt thời gian và công cụ dễ hơn nhiều.
Bước thực hành: Ước tính chi phí nhiễm bẩn giúp vấn đề trở nên cụ thể. Nó nhân tỷ lệ phiên không đạt từ hai trong năm tiêu chí trở lên với chi tiêu truyền thông trả phí của bạn trong quý. Sau đó, nó liệt kê mọi quyết định (điều chỉnh ngân sách, biến thể thắng thử nghiệm, ưu tiên nội dung) đã dựa vào các báo cáo đó. Cách này hiệu quả vì biến một vấn đề chất lượng dữ liệu trừu tượng thành con số ngân sách, giúp việc phê duyệt thời gian và công cụ dễ hơn nhiều.
Cách Phát Hiện Bot Traffic trong Google Analytics 4
Google Analytics 4 (GA4) đã tự động loại trừ bot đã biết, dựa trên nghiên cứu riêng của Google và Danh sách IAB/ABC International Spiders and Bots. Bạn không thể tắt tính năng này và cũng không thể thấy lượng traffic bị loại bỏ. Điều đó nghe có vẻ yên tâm, nhưng có nghĩa là các bot còn lại trong báo cáo của bạn, theo định nghĩa, là những bot không có trong bất kỳ danh sách nào. Phát hiện bot traffic ngoài danh sách đó là việc của bạn.
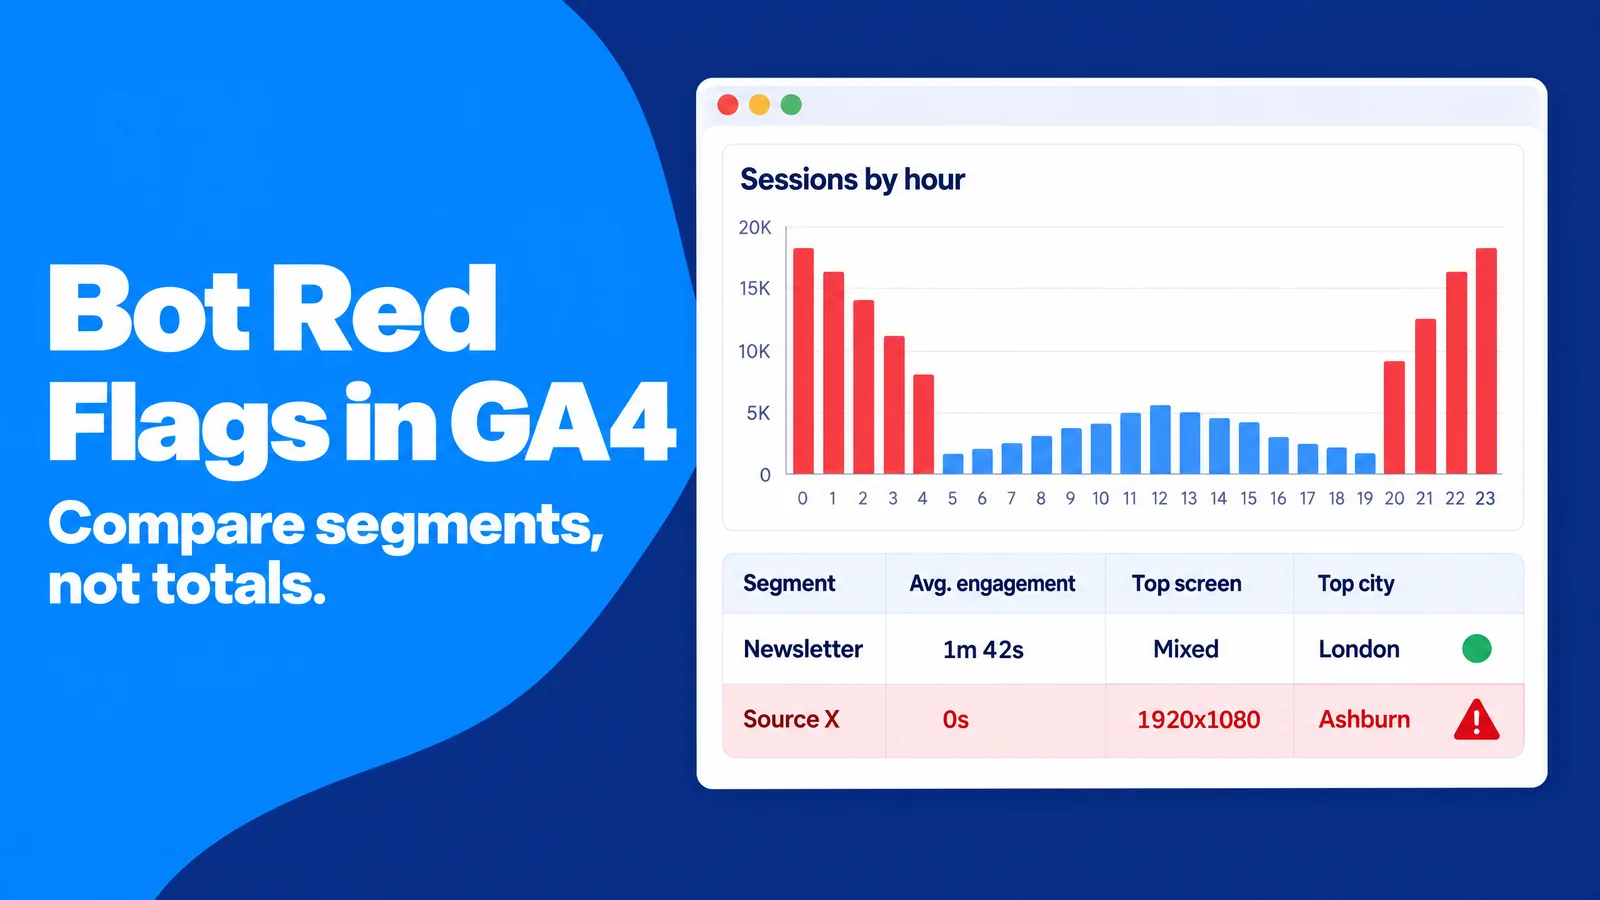
Tin tốt là bot chưa biết vẫn để lại các mẫu hình. Chúng thường đến theo đợt, dùng tập thiết bị hẹp, bỏ qua các đường dẫn chuyển đổi và tập trung ở nơi khách hàng của bạn không sinh sống. Bạn xác định bot traffic bằng cách so sánh phân khúc, không phải nhìn chằm chằm vào tổng số.
Tin tốt là bot chưa biết vẫn để lại các mẫu hình. Chúng thường đến theo đợt, dùng tập thiết bị hẹp, bỏ qua các đường dẫn chuyển đổi và tập trung ở nơi khách hàng của bạn không sinh sống. Bạn xác định bot traffic bằng cách so sánh phân khúc, không phải nhìn chằm chằm vào tổng số.
Bắt Đầu Với Hình Dạng Của Đợt Tăng
Đợt tăng traffic tự nhiên có nguyên nhân và hình dạng. Newsletter, bài đăng mạng xã hội hoặc đề cập trên báo chí tạo ra mức tăng mạnh rồi giảm dần theo giờ hoặc ngày, cùng với chuyển đổi tăng. Đợt tăng do bot thường khác: cao nguyên đỉnh phẳng, bắt đầu và kết thúc vào giờ tròn, phiên tăng trong khi sự kiện chính không đổi.
Khi xuất hiện đợt tăng, câu hỏi đầu tiên là "điều gì đã xảy ra vào thời điểm đó?" Nếu không có chiến dịch, đề cập hay sự kiện theo mùa nào giải thích được, tốt nhất hãy coi đợt tăng là chưa được xác minh cho đến khi phép so sánh phân khúc dưới đây cho kết quả khác.
Khi xuất hiện đợt tăng, câu hỏi đầu tiên là "điều gì đã xảy ra vào thời điểm đó?" Nếu không có chiến dịch, đề cập hay sự kiện theo mùa nào giải thích được, tốt nhất hãy coi đợt tăng là chưa được xác minh cho đến khi phép so sánh phân khúc dưới đây cho kết quả khác.
Tám Dấu Hiệu Cảnh Báo Trong Báo Cáo Của Bạn
Bạn nên kiểm tra các mẫu này bất cứ khi nào một nguồn hoặc trang đích trông bất thường:
- Thời gian tương tác gần bằng 0: nhiều phiên gần như không có thời gian tương tác, hoặc thời lượng tập trung trong cùng vài giây.
- Đợt tăng Direct hoặc Unassigned: tăng đột ngột của traffic Direct hoặc Unassigned đến một trang đích không được liên kết rõ ràng ở đâu cả.
- Hostname không xác định: lượt truy cập được ghi trên các tên miền không phải của bạn, xảy ra khi ai đó sao chép ID đo lường của bạn sang website khác.
- Một hồ sơ thiết bị: một độ phân giải màn hình, phiên bản trình duyệt hoặc hệ điều hành duy nhất chi phối một nguồn.
- Vị trí trung tâm dữ liệu: cụm lượt truy cập ở các thành phố nổi tiếng có nhiều trang trại máy chủ, như Ashburn, Virginia, thay vì nơi khách hàng của bạn sống.
- Traffic ca đêm: lượng truy cập địa phương từ 1 giờ đến 5 giờ sáng bằng lượng ban ngày.
- Referrer lạ: tên miền không quen thuộc, nhất là những tên miền quảng cáo dịch vụ SEO hoặc traffic.
- Chuyển đổi phẳng: số phiên tăng trong khi lượt đăng ký, giao dịch mua hoặc khách hàng tiềm năng đủ điều kiện không đổi, hoặc biểu mẫu có nội dung vô nghĩa.
Tạo Khám Phá Điều Tra Bot
Phần Khám phá của GA4 cho phép bạn tạo báo cáo tái sử dụng cho việc này. Khám phá dạng tự do với các phương diện phù hợp trả lời được phần lớn câu hỏi trong vài phút, còn mẫu đã lưu giúp lần điều tra tiếp theo không phải bắt đầu từ đầu:
- Thiết lập: khám phá dạng tự do với các phương diện nguồn / phương tiện của phiên, trang đích, hostname, độ phân giải màn hình, thành phố và giờ.
- Chỉ số: phiên, phiên tương tác, thời gian tương tác trung bình mỗi phiên và sự kiện chính.
- Phân khúc: một phân khúc cho nguồn đáng ngờ và một phân khúc cho kênh đường cơ sở đáng tin cậy của bạn.
- So sánh: đặt hai phân khúc cạnh nhau, theo từng phương diện, dùng năm tiêu chí làm hướng dẫn.
- Bằng chứng: xuất khoảng 20 phiên đáng ngờ cùng thuộc tính của chúng, sẵn sàng chia sẻ với nhà cung cấp hoặc nền tảng quảng cáo.
Cách tiếp cận này hiệu quả vì bot hiếm khi chỉ không đạt ở một phương diện riêng lẻ. Các phân khúc đặt cạnh nhau khiến hồ sơ thiết bị hẹp, giờ bất thường và chuyển đổi thiếu vắng lộ rõ cùng lúc. Hướng dẫn của chúng tôi về cách dùng phân tích để cải thiện lưu lượng truy cập web bao quát các báo cáo GA4 cốt lõi, còn hướng dẫn về phân bổ traffic AI giải thích cách đọc traffic Direct mà không vội kết luận.
Thận Trọng Khi Dùng Bộ Lọc Dữ Liệu GA4
Bộ lọc dữ liệu là cách chính để loại trừ bot traffic trong GA4 khi bạn biết nó đến từ đâu. Chúng có thể loại bỏ traffic nội bộ, traffic của nhà phát triển và gần đây là lượt truy cập từ hostname không thuộc sở hữu của bạn. Bộ lọc hostname chỉ bao gồm tên miền của bạn là cách khắc phục gọn gàng cho ID đo lường bị sao chép sang website khác. Bộ lọc rất mạnh nhưng không khoan nhượng: khi bộ lọc hoạt động, dữ liệu bị loại trừ sẽ mất vĩnh viễn.
Bước thực hành: Thói quen an toàn nhất là chạy mọi bộ lọc mới ở chế độ Kiểm thử ít nhất một tuần và so sánh kết quả đã lọc với chưa lọc trước khi kích hoạt. Điều này bảo vệ bạn khỏi việc xóa dữ liệu khách hàng thật vì lỗi chính tả trong tên miền hoặc quy tắc quá rộng.
Bước thực hành: Thói quen an toàn nhất là chạy mọi bộ lọc mới ở chế độ Kiểm thử ít nhất một tuần và so sánh kết quả đã lọc với chưa lọc trước khi kích hoạt. Điều này bảo vệ bạn khỏi việc xóa dữ liệu khách hàng thật vì lỗi chính tả trong tên miền hoặc quy tắc quá rộng.
Cách Xác Minh Bot ở Cấp Máy Chủ
Công cụ phân tích chỉ nhìn thấy khách truy cập chạy mã theo dõi của bạn. Nhiều bot không bao giờ thực thi JavaScript nên không bao giờ xuất hiện trong GA4, nhưng chúng vẫn tiêu tốn băng thông, quét nội dung và thăm dò biểu mẫu đăng nhập. Nhật ký máy chủ, nhật ký CDN hoặc bảng điều khiển hosting của bạn hiển thị mọi yêu cầu, nên đó là nơi xác nhận ai thực sự đang truy cập.
Vì Sao User Agent Không Chứng Minh Điều Gì
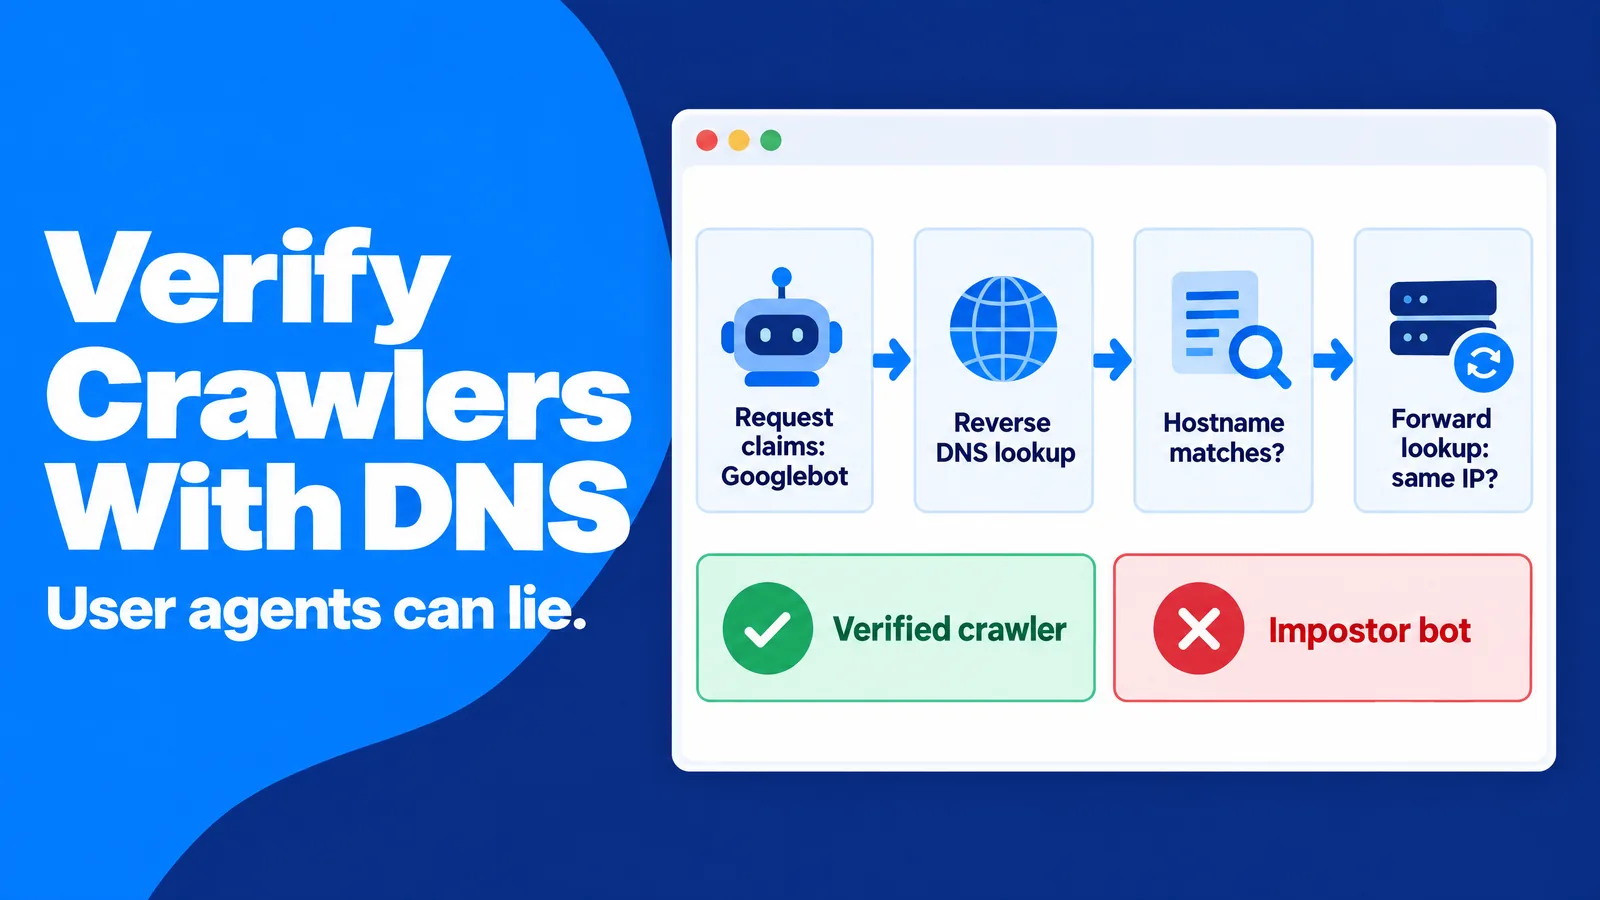
Mỗi yêu cầu mang một chuỗi user agent cho biết tên trình duyệt hoặc bot. Vấn đề là khách truy cập tự viết chuỗi đó. Trình quét có thể tự nhận là Googlebot, Chrome trên iPhone hoặc bất cứ thứ gì khác chỉ với một dòng mã, nên coi user agent là danh tính cũng giống như coi thẻ tên là hộ chiếu.
Xác Nhận Crawler Bằng Reverse DNS Xác Nhận Hai Chiều
Cách tiêu chuẩn để kiểm tra crawler tự khai báo là forward-confirmed reverse DNS. Quy trình này cần hai lần tra cứu. Tra cứu DNS ngược trên địa chỉ IP của khách truy cập trả về hostname, hostname này phải thuộc tên miền của nhà vận hành được tự nhận. Sau đó, tra cứu xuôi hostname đó phải trả về cùng địa chỉ IP, vì vậy Googlebot giả sẽ không qua được do địa chỉ IP của nó không phân giải ngược về tên miền của Google.
Bước thực hành: Mẫu nhật ký hằng tháng giúp việc này dễ quản lý. Lấy 20 user agent có số yêu cầu nhiều nhất và chạy kiểm tra trên bất kỳ chuỗi nào tự nhận là công cụ tìm kiếm hoặc crawler AI lớn chỉ mất vài phút. Điều này hiệu quả vì kẻ mạo danh tập trung ở nơi phần thưởng lớn nhất: giả làm crawler đáng tin là cách dễ nhất để vượt qua giới hạn tốc độ và tường lửa.
Bước thực hành: Mẫu nhật ký hằng tháng giúp việc này dễ quản lý. Lấy 20 user agent có số yêu cầu nhiều nhất và chạy kiểm tra trên bất kỳ chuỗi nào tự nhận là công cụ tìm kiếm hoặc crawler AI lớn chỉ mất vài phút. Điều này hiệu quả vì kẻ mạo danh tập trung ở nơi phần thưởng lớn nhất: giả làm crawler đáng tin là cách dễ nhất để vượt qua giới hạn tốc độ và tường lửa.
Robots.txt Là Yêu Cầu, Không Phải Khóa
Tệp robots.txt cho crawler biết chúng được phép truy cập những gì, và định dạng này được chuẩn hóa trong RFC 9309. Việc tuân thủ là tự nguyện. Crawler hoạt động tốt tôn trọng nó, còn traffic bot và nhiều trình quét thì phớt lờ hoặc đổi tên để lách chặn.
Robots.txt vẫn hữu ích vì nó phân biệt bot tôn trọng quy tắc của bạn với bot không tôn trọng. Wikipedia lưu ý rằng 306 trong số 1.000 website được truy cập nhiều nhất đã chặn GPTBot của OpenAI năm 2023, cho thấy chủ website hiện dùng tệp này như một tuyên bố chính sách. Bot yêu cầu những trang bạn đã cấm truy cập đã cho bạn biết điều quan trọng về ý định của nó.
Robots.txt vẫn hữu ích vì nó phân biệt bot tôn trọng quy tắc của bạn với bot không tôn trọng. Wikipedia lưu ý rằng 306 trong số 1.000 website được truy cập nhiều nhất đã chặn GPTBot của OpenAI năm 2023, cho thấy chủ website hiện dùng tệp này như một tuyên bố chính sách. Bot yêu cầu những trang bạn đã cấm truy cập đã cho bạn biết điều quan trọng về ý định của nó.
Danh Tính Bot Có Chữ Ký Đang Đến
Giải pháp dài hạn cho việc mạo danh là danh tính mật mã. Internet Engineering Task Force (IETF) đã thành lập nhóm làm việc Web Bot Auth để chuẩn hóa cách bot chứng minh danh tính, dựa trên HTTP Message Signatures. Bot có chữ ký gắn chữ ký có thể xác minh vào từng yêu cầu, nên website có thể xác nhận nhà vận hành mà không cần dựa vào danh sách IP. Theo dõi công việc này từ bây giờ giúp bạn lập kế hoạch cho những khách truy cập tự động sẽ cho phép khi chữ ký trở nên phổ biến.
Cách Chặn Bot Traffic Mà Không Chặn Người Thật
Chặn bot nghe có vẻ đơn giản cho đến khi khách hàng thật bị vướng vào lưới. Tường CAPTCHA quyết liệt làm người dùng điện thoại chậm khó chịu và tạo rào cản cho người dùng công nghệ hỗ trợ. Chặn toàn diện theo quốc gia hoặc trung tâm dữ liệu có thể khóa người đi du lịch, người dùng VPN doanh nghiệp và người quan tâm quyền riêng tư, còn mỗi dương tính giả là một khách hàng tiềm năng bị mất mà không bao giờ xuất hiện trong báo cáo.
Cách tiếp cận hiện đại cũng phải tính đến tự động hóa hữu ích. Trợ lý AI ngày càng tải trang, so sánh sản phẩm và điền biểu mẫu thay mặt con người. Coi mọi yêu cầu không phải con người là thù địch có thể cắt bạn khỏi các lượt truy cập mà khách hàng thật đã yêu cầu.
Cách tiếp cận hiện đại cũng phải tính đến tự động hóa hữu ích. Trợ lý AI ngày càng tải trang, so sánh sản phẩm và điền biểu mẫu thay mặt con người. Coi mọi yêu cầu không phải con người là thù địch có thể cắt bạn khỏi các lượt truy cập mà khách hàng thật đã yêu cầu.
Điều Chỉnh Phản Hồi Theo Loại Bot
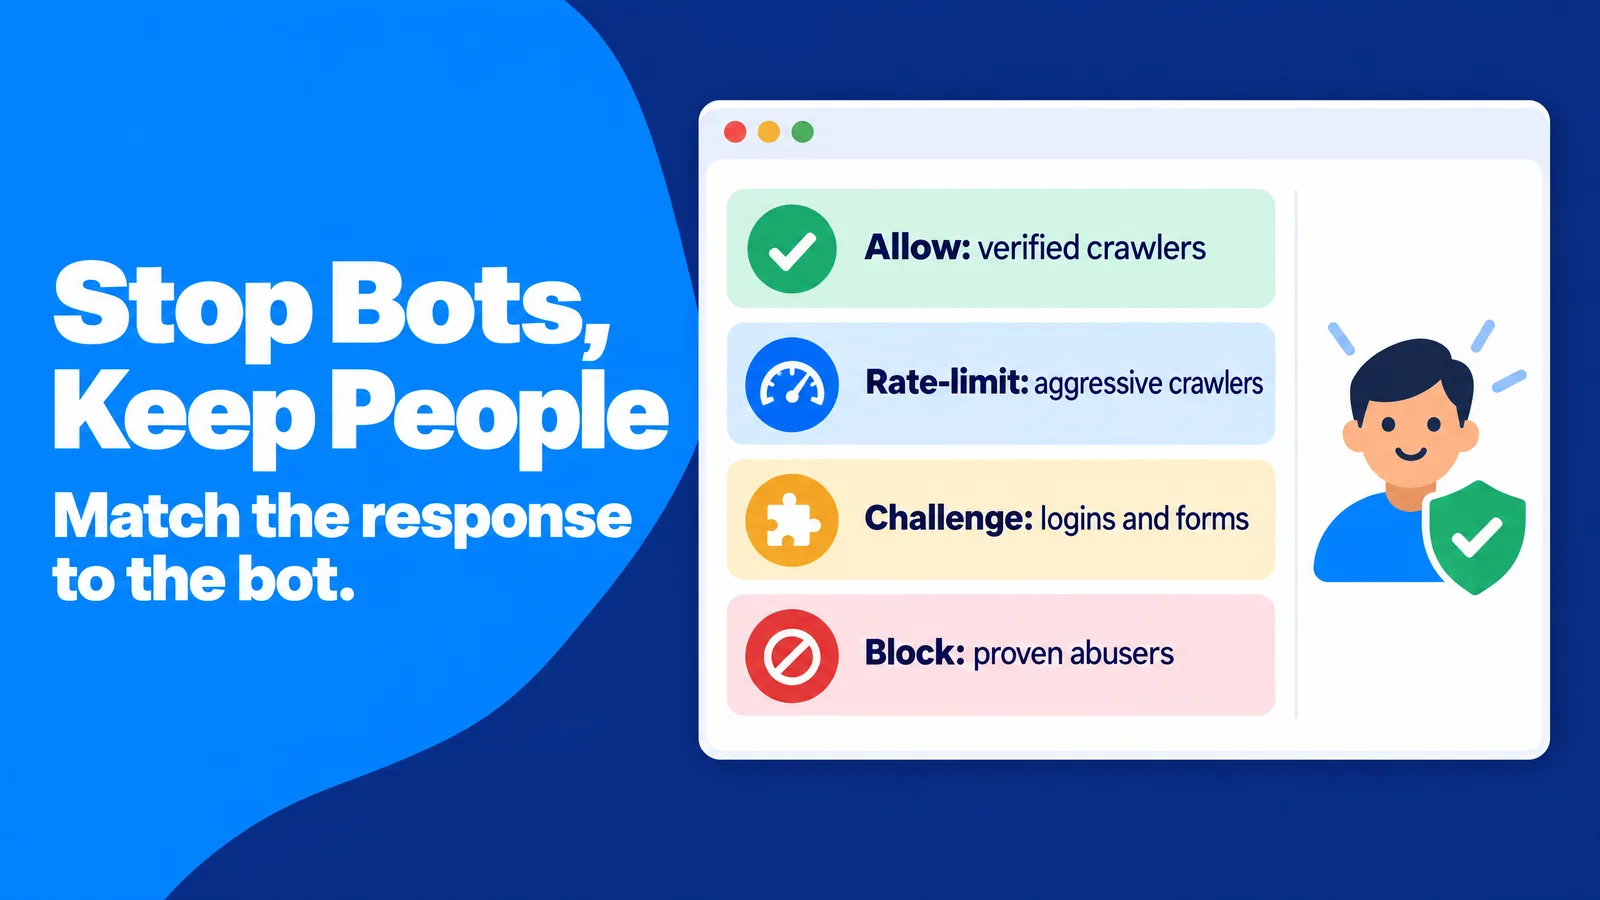
Các biện pháp phòng vệ hiệu quả nhất có cấp độ thay vì được hoặc mất. Mỗi loại khách truy cập tự động nhận phản hồi nhẹ nhất giải quyết được vấn đề:
- Crawler đã xác minh mà bạn muốn: được cho phép vì chúng đem lại khả năng hiển thị tìm kiếm và trích dẫn AI.
- Crawler quyết liệt nhưng hợp lệ: bị giới hạn tốc độ, cách này bảo vệ hiệu năng máy chủ mà không làm hỏng điều gì.
- Traffic chưa xác minh trên trang nhạy cảm: được thử thách bằng CAPTCHA hoặc bài kiểm tra tương tự, chỉ ở phần đăng nhập, đăng ký và thanh toán, nơi chi phí của hành vi lạm dụng cao nhất.
- Kẻ lạm dụng đã được chứng minh: bị chặn theo dải IP, mạng hoặc chữ ký khi bằng chứng đã rõ ràng.
Việc phân cấp này hiệu quả vì nó tập trung trở ngại vào nơi lạm dụng gây thiệt hại thực sự và giữ phần còn lại của website nhanh, mở cho con người.
Bảo Vệ Biểu Mẫu, Đăng Ký và Thanh Toán
Biểu mẫu là nơi bot gây hại lâu dài nhất. Đăng ký giả làm nhiễm bẩn CRM, kích hoạt email chào mừng đến các địa chỉ bị trả lại và gây tổn hại uy tín người gửi. Khách hàng tiềm năng giả lãng phí thời gian bán hàng và làm sai lệch báo cáo chi phí mỗi khách hàng tiềm năng.
Bước thực hành: Lớp bảo vệ đầu tiên đơn giản là trường honeypot: trường biểu mẫu ẩn với người nhưng hiển thị cho bot, nên mọi lần gửi điền trường đó có thể bị từ chối. Xác thực phía máy chủ, giới hạn tốc độ theo địa chỉ IP và xác nhận kép cho danh sách email bổ sung thêm các lớp. Thiết lập này hiệu quả vì mỗi lớp chặn một loại bot khác nhau, trong khi người thật không bao giờ nhận ra chúng.
Bước thực hành: Lớp bảo vệ đầu tiên đơn giản là trường honeypot: trường biểu mẫu ẩn với người nhưng hiển thị cho bot, nên mọi lần gửi điền trường đó có thể bị từ chối. Xác thực phía máy chủ, giới hạn tốc độ theo địa chỉ IP và xác nhận kép cho danh sách email bổ sung thêm các lớp. Thiết lập này hiệu quả vì mỗi lớp chặn một loại bot khác nhau, trong khi người thật không bao giờ nhận ra chúng.
Để Ngỏ Cửa Cho Tác Nhân AI Hoạt Động Thay Mặt Con Người
Một số lượt truy cập tự động hiện đại diện cho nhu cầu thật. Tác nhân AI kiểm tra giá hoặc đặt lịch demo cho người dùng là tương tác khách hàng được thực hiện bằng phần mềm. Chặn hoàn toàn có thể khiến bạn mất một giao dịch, còn cho qua mà không kiểm tra có thể làm sai lệch chỉ số tương tác.
Giải pháp trung gian thực tế là nhận diện riêng các tác nhân này, cho phép chúng trên trang công khai và đo lường chúng trong phân khúc riêng. Hướng dẫn của chúng tôi về traffic AI có tính tác nhân giải thích cách lượt truy cập có trợ giúp AI xuất hiện trong phân tích và cách chuẩn bị trang cho chúng.
Giải pháp trung gian thực tế là nhận diện riêng các tác nhân này, cho phép chúng trên trang công khai và đo lường chúng trong phân khúc riêng. Hướng dẫn của chúng tôi về traffic AI có tính tác nhân giải thích cách lượt truy cập có trợ giúp AI xuất hiện trong phân tích và cách chuẩn bị trang cho chúng.
Cách Giữ Chiến Dịch Traffic Trả Phí Sạch
Traffic trả phí là nơi bot traffic gây tổn hại trực tiếp nhất cho ngân sách của bạn. Mỗi lượt nhấp hoặc lượt hiển thị không hợp lệ đều là tiền chi cho không ai. Rủi ro cao nhất ở nguồn hàng rẻ, đại trà và ở các nhà cung cấp không thể nói lượt truy cập đến từ đâu, vì động lực của họ là khối lượng chứ không phải kết quả.
Một số đề nghị là traffic bot ngụy trang. Dấu hiệu cảnh báo gồm lời hứa về lượt truy cập "không thể phát hiện" hoặc "trông như thật", cải thiện thứ hạng tìm kiếm được đảm bảo, khách truy cập không giới hạn với phí cố định và mạng proxy dân cư được giới thiệu như một tính năng. Thay vào đó, nền tảng quảng cáo hợp pháp nói về nhắm mục tiêu, vị trí hiển thị, đánh giá trang đích và đo lường. Mua lượt truy cập bot luôn phản tác dụng: chúng không bao giờ chuyển đổi, làm hỏng thử nghiệm của bạn, mạng quảng cáo có thể cấm các website kiếm tiền nhận chúng và bản thân việc mua có thể vi phạm quy tắc bảo vệ người tiêu dùng.
Một số đề nghị là traffic bot ngụy trang. Dấu hiệu cảnh báo gồm lời hứa về lượt truy cập "không thể phát hiện" hoặc "trông như thật", cải thiện thứ hạng tìm kiếm được đảm bảo, khách truy cập không giới hạn với phí cố định và mạng proxy dân cư được giới thiệu như một tính năng. Thay vào đó, nền tảng quảng cáo hợp pháp nói về nhắm mục tiêu, vị trí hiển thị, đánh giá trang đích và đo lường. Mua lượt truy cập bot luôn phản tác dụng: chúng không bao giờ chuyển đổi, làm hỏng thử nghiệm của bạn, mạng quảng cáo có thể cấm các website kiếm tiền nhận chúng và bản thân việc mua có thể vi phạm quy tắc bảo vệ người tiêu dùng.
Gắn Thẻ Mọi Nguồn Trả Phí
Traffic trả phí không gắn thẻ hòa vào Direct và Referral, nơi bot dễ ẩn náu. Tham số UTM là các thẻ thêm vào liên kết, cho công cụ phân tích biết chính xác nguồn, chiến dịch và vị trí hiển thị nào đã gửi lượt truy cập.
Bước thực hành: Quy tắc UTM đơn giản xử lý phần lớn khoảng trống phân bổ: mỗi chiến dịch trả phí có giá trị nguồn, phương tiện và chiến dịch riêng, được ghi trong bảng quy ước đặt tên dùng chung. Điều này hiệu quả vì bài kiểm tra năm tiêu chí cần một phân khúc sạch để chạy, và nếu lượt truy cập trả phí lẫn vào Direct, bạn không thể biết nhà cung cấp nào gửi các phiên đáng ngờ.
Bước thực hành: Quy tắc UTM đơn giản xử lý phần lớn khoảng trống phân bổ: mỗi chiến dịch trả phí có giá trị nguồn, phương tiện và chiến dịch riêng, được ghi trong bảng quy ước đặt tên dùng chung. Điều này hiệu quả vì bài kiểm tra năm tiêu chí cần một phân khúc sạch để chạy, và nếu lượt truy cập trả phí lẫn vào Direct, bạn không thể biết nhà cung cấp nào gửi các phiên đáng ngờ.
Chạy Thử Nghiệm Nhỏ Trước Khi Mở Rộng
Ngân sách thử nghiệm nhỏ cho biết nguồn có hành xử như con người hay không trước khi bạn cam kết tiền thật. Vài trăm phiên là đủ để chạy năm tiêu chí, và dữ liệu một tuần cho thấy nhịp điệu hằng ngày. Kỷ luật tương tự cũng cải thiện công việc trang đích của bạn, như hướng dẫn về thử nghiệm A/B trang đích bằng traffic trả phí cho thấy.
Định dạng quảng cáo cũng quan trọng. Traffic popunder, native và push tạo ra các mẫu tương tác khác nhau, vì khách truy cập popunder hành xử khác người đã chọn nhấp vào quảng cáo native. Đánh giá mỗi định dạng theo đường cơ sở riêng sẽ tránh cảnh báo nhầm.
Định dạng quảng cáo cũng quan trọng. Traffic popunder, native và push tạo ra các mẫu tương tác khác nhau, vì khách truy cập popunder hành xử khác người đã chọn nhấp vào quảng cáo native. Đánh giá mỗi định dạng theo đường cơ sở riêng sẽ tránh cảnh báo nhầm.
Coi Chính Sách Hoàn Tiền và Tín Dụng Là Tín Hiệu Chất Lượng
Nền tảng uy tín kỳ vọng bạn kiểm tra traffic của họ và giải thích điều gì xảy ra khi có thứ trông không đúng. Nền tảng tốt có quy trình rõ ràng: cần bằng chứng nào, xem xét báo cáo ra sao và có cấp tín dụng cho hoạt động không hợp lệ không. Nhà cung cấp từ chối mọi đánh giá, hoặc tuyên bố traffic của họ "100% là người", đang cho bạn biết điều gì đó. Ngay cả MRC cũng tránh gọi traffic đã lọc là "con người" và ưu tiên từ "hợp lệ", vì không bộ lọc nào bảo đảm mọi lượt truy cập còn lại đều là người.
Chiến Lược Nâng Cao: Kiểm Toán Bot Traffic Hàng Tháng
Điều tra một lần xử lý vấn đề một lần. Bot thay đổi, chiến dịch thay đổi và công cụ của bạn cũng thay đổi, nên quy trình ngắn hằng tháng sẽ bắt được vấn đề trước khi chúng làm sai lệch các quyết định của cả quý. Mục tiêu không phải là không có bot traffic, điều đó là bất khả thi. Mục tiêu là bot traffic được biết đến, đo lường và lập tài liệu.
Quy Trình Hằng Tháng Trong 30 Phút
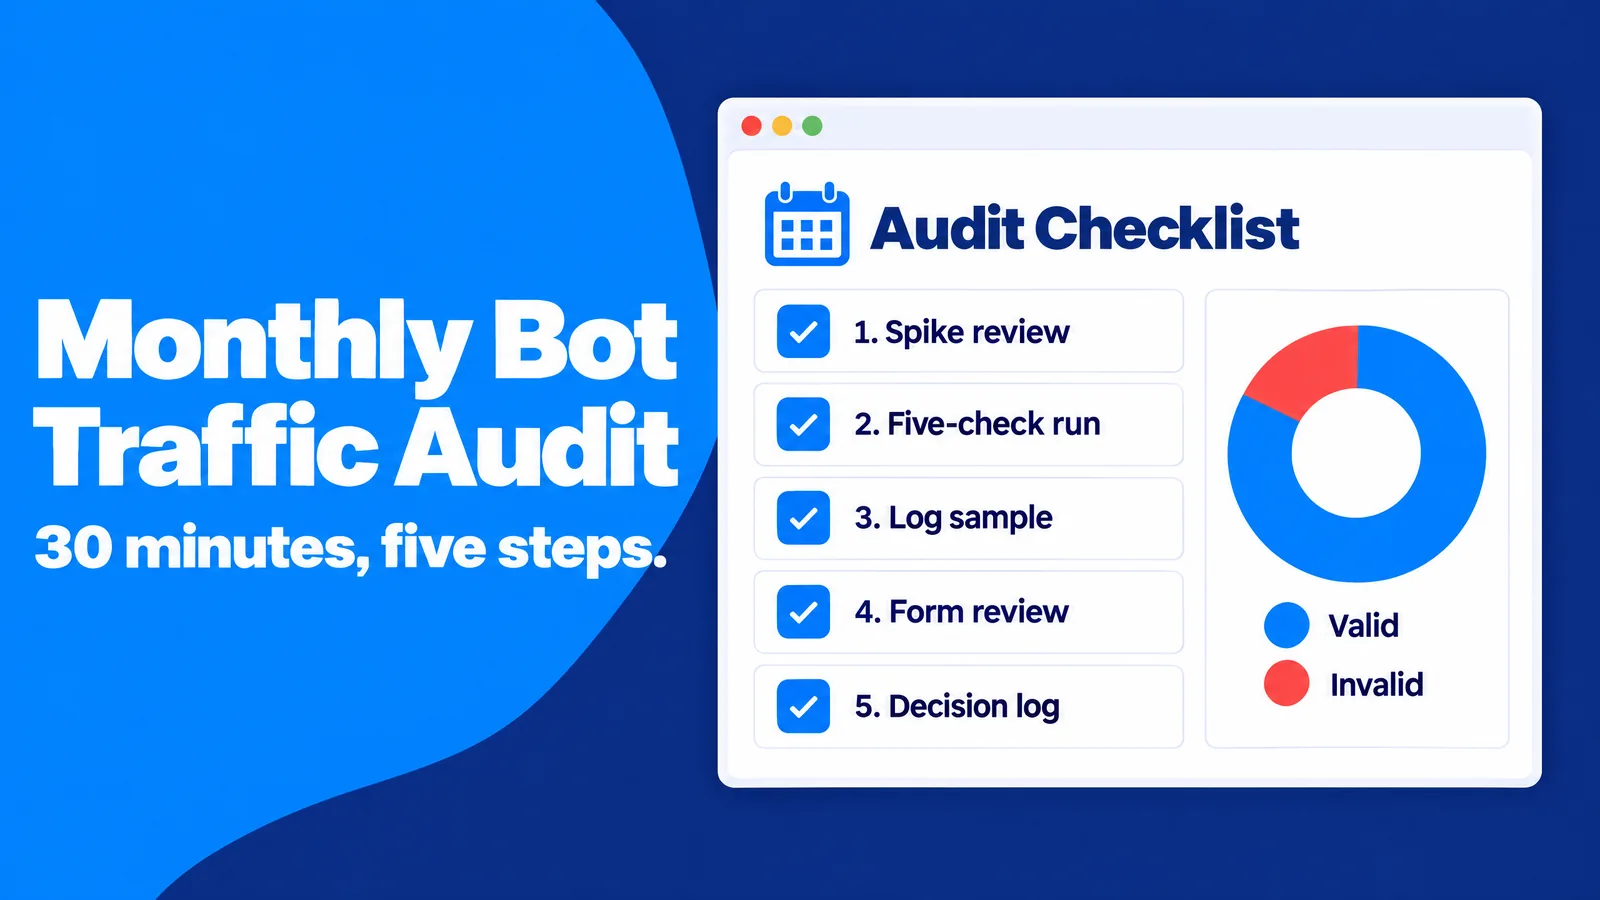
Kiểm toán định kỳ hiệu quả nhất khi tuân theo cùng các bước mỗi lần, để xu hướng trở nên rõ ràng:
- Rà soát đợt tăng: mọi đợt tăng traffic của tháng trước được ghi chú nguyên nhân hoặc đánh dấu là không giải thích được.
- Chạy năm tiêu chí: mỗi nguồn và chiến dịch chính được chấm theo năm tiêu chí.
- Mẫu nhật ký: các crawler tự nhận hàng đầu được xác minh bằng forward-confirmed reverse DNS.
- Rà soát biểu mẫu: kiểm tra đăng ký và khách hàng tiềm năng xem có tên giống nhau, tên miền email dùng một lần hay đợt tăng đột ngột không.
- Nhật ký quyết định: bản ghi về những gì bạn đã lọc, chặn hoặc báo cáo, và lý do.
Quy trình này hiệu quả vì biến việc phát hiện bot thành thói quen có dấu vết tài liệu. Khi bên liên quan hỏi vì sao các con số tháng Ba thay đổi, bạn có câu trả lời.
Viết Chính Sách Lưu Lượng Không Hợp Lệ Một Trang
Ngay cả chuyên gia cũng khó định nghĩa chính xác lưu lượng không hợp lệ. Báo cáo Tuzhilin, một đánh giá độc lập về khả năng phát hiện gian lận nhấp chuột của Google được mô tả trong bài viết Wikipedia về gian lận nhấp chuột, kết luận rằng "không có định nghĩa khái niệm nào về lượt nhấp không hợp lệ có thể được vận hành hóa", trừ các trường hợp rõ ràng. Nếu ngành không thể thống nhất một định nghĩa, nhóm của bạn sẽ hưởng lợi từ định nghĩa riêng.
Bước thực hành: Chính sách một trang giải quyết trước phần lớn tranh luận. Nó nêu rõ những khách truy cập tự động bạn cho phép, ngưỡng nào kích hoạt đánh giá, ai quyết định và cách báo cáo kết quả cho agency cùng nhà cung cấp. Điều này hiệu quả vì quy tắc viết thành văn bản thay thế tranh luận từng trường hợp và trao cho đối tác tiêu chuẩn rõ ràng để đáp ứng.
Bước thực hành: Chính sách một trang giải quyết trước phần lớn tranh luận. Nó nêu rõ những khách truy cập tự động bạn cho phép, ngưỡng nào kích hoạt đánh giá, ai quyết định và cách báo cáo kết quả cho agency cùng nhà cung cấp. Điều này hiệu quả vì quy tắc viết thành văn bản thay thế tranh luận từng trường hợp và trao cho đối tác tiêu chuẩn rõ ràng để đáp ứng.
Theo Dõi Các Chỉ Số Bot Không Thể Làm Giả Rẻ
Lượt xem trang và phiên rất rẻ để làm giả. Doanh thu, khách hàng tiềm năng đủ điều kiện, mua lặp lại, phiếu hỗ trợ và người dùng quay lại đã đăng nhập rất đắt hoặc không thể làm giả ở quy mô lớn. Nguồn traffic tăng số phiên nhưng không bao giờ làm những số liệu này dịch chuyển cần được xem xét kỹ, dù mức tương tác trông tốt đến đâu.
Neo báo cáo vào các chỉ số kết quả này là biện pháp phòng vệ dài hạn mạnh nhất. Nó căn chỉnh mọi quyết định về traffic với điều con người thực sự làm và loại bỏ động lực cho bất kỳ ai trong chuỗi cung ứng của bạn chèn thêm con số.
Neo báo cáo vào các chỉ số kết quả này là biện pháp phòng vệ dài hạn mạnh nhất. Nó căn chỉnh mọi quyết định về traffic với điều con người thực sự làm và loại bỏ động lực cho bất kỳ ai trong chuỗi cung ứng của bạn chèn thêm con số.
Câu Hỏi Thường Gặp về Traffic Bot
Traffic bot là gì theo cách đơn giản?
Traffic bot là phần mềm tự động truy cập website hoặc nhấp quảng cáo để hoạt động trông như đến từ người thật. Nó thường làm phồng các chỉ số như lượt xem trang, lượt nhấp, lượt xem video hoặc người theo dõi.
Mọi bot traffic đều xấu phải không?
Không. Crawler của công cụ tìm kiếm, công cụ giám sát thời gian hoạt động và nhiều crawler AI đều hữu ích. Bot traffic trở thành vấn đề khi nó giả làm con người, lãng phí chi tiêu quảng cáo, quét nội dung trái với quy tắc của bạn hoặc làm sai lệch phân tích.
Bot traffic có thể làm hại SEO của tôi không?
Lượt truy cập giả không cải thiện thứ hạng vì công cụ tìm kiếm dựa vào nhiều tín hiệu chất lượng thay vì số lượt truy cập thô. Bot traffic vẫn có thể gây hại gián tiếp bằng cách làm chậm máy chủ, sao chép nội dung và dẫn bạn tối ưu sai trang dựa trên dữ liệu bị nhiễm bẩn.
Google Analytics 4 có tự động lọc bot traffic không?
Có. GA4 tự động loại trừ bot và spider đã biết, và bạn không thể tắt việc này hoặc biết nó đã loại bỏ bao nhiêu. Bot chưa biết và tinh vi vẫn có thể vào báo cáo của bạn, nên so sánh phân khúc và năm tiêu chí vẫn cần thiết.
Bao nhiêu bot traffic là bình thường?
Không có con số chung cho mọi trường hợp. Hơn một nửa toàn bộ lưu lượng web là tự động, nhưng phần lớn không bao giờ chạy mã phân tích của bạn. Chuẩn đối chiếu thực tế là kênh đường cơ sở đáng tin cậy của bạn: các nguồn lệch mạnh khỏi nó đáng được xem xét kỹ hơn.
Làm cách nào để chặn bot traffic trên website?
Cách tiếp cận hiệu quả nhất là phân cấp. Crawler đã xác minh được cho phép, crawler quyết liệt bị giới hạn tốc độ, traffic chưa xác minh chỉ bị thử thách ở phần đăng nhập và biểu mẫu, còn kẻ lạm dụng đã được chứng minh bị chặn. Trường honeypot, xác thực phía máy chủ, bộ lọc hostname và traffic nội bộ trong GA4 giúp giữ cả biểu mẫu lẫn báo cáo của bạn sạch.
Làm sao biết traffic website của tôi đến từ bot?
Cách nhanh nhất là so sánh nguồn đáng ngờ với kênh bạn tin cậy theo năm khía cạnh: thời lượng phiên, độ phân giải màn hình, thời điểm trong ngày, vị trí và tương tác. Hai lỗi rõ ràng trở lên, như thời lượng phiên giống hệt và lượng truy cập ban đêm bằng ban ngày, cho thấy mạnh mẽ lưu lượng tự động. Nhật ký máy chủ và forward-confirmed reverse DNS sau đó xác nhận các crawler tự khai báo có thực hay không.
Mua bot traffic có hợp pháp không?
Quy định khác nhau theo quốc gia, nhưng mua tương tác giả cho mục đích thương mại có rủi ro pháp lý và kinh doanh thực sự. Tại Hoa Kỳ, quy tắc năm 2024 của FTC cấm mua hoặc bán chỉ dấu ảnh hưởng mạng xã hội giả, như người theo dõi hoặc lượt xem do bot tạo, cho mục đích thương mại. Mạng quảng cáo cũng cấm traffic giả trong chính sách của họ.
Kết Luận: Đo Lường Vì Con Người, Không Vì Các Bộ Đếm
Traffic bot tồn tại vì hoạt động giả rẻ để tạo và dễ để bán. Biện pháp phòng vệ của bạn là bức tranh rõ ràng về diện mạo của người thật trên website. Năm tiêu chí, đường cơ sở đáng tin cậy, xác minh ở cấp máy chủ và kiểm toán hằng tháng mang lại bức tranh đó mà không cần công cụ đắt tiền.
Web cũ thưởng cho những con số lớn. Web hiện tại thưởng cho niềm tin: công cụ tìm kiếm, nhà quảng cáo, hệ thống AI và khách hàng đều phản hồi với tương tác chân thật. Khi bạn bảo vệ dữ liệu khỏi bot, bạn bảo vệ mọi quyết định phụ thuộc vào dữ liệu và giữ sự chú ý vào nhóm đối tượng mua hàng, đăng ký và quay lại: con người thật.
Web cũ thưởng cho những con số lớn. Web hiện tại thưởng cho niềm tin: công cụ tìm kiếm, nhà quảng cáo, hệ thống AI và khách hàng đều phản hồi với tương tác chân thật. Khi bạn bảo vệ dữ liệu khỏi bot, bạn bảo vệ mọi quyết định phụ thuộc vào dữ liệu và giữ sự chú ý vào nhóm đối tượng mua hàng, đăng ký và quay lại: con người thật.