Mais da metade de todo o tráfego da web é gerado por bots, segundo a visão geral da Wikipédia sobre bots da internet. Parte dessa automação mantém a web funcionando. Crawlers de mecanismos de busca indexam suas páginas, e monitores de disponibilidade confirmam que seu checkout ainda carrega às 3h.
Uma parcela crescente do tráfego automatizado faz outra coisa. Ela imita pessoas, infla seus números e consome orçamentos de publicidade destinados a clientes reais. A Juniper Research estimou que a fraude publicitária custou US$ 88 bilhões aos anunciantes em 2023, e grande parte dessa fraude opera com visitas e cliques automatizados.
Para você, profissional de marketing, o maior custo costuma ser invisível. Orçamentos, planos de conteúdo e decisões sobre landing pages podem se basear em visitas que nenhum ser humano fez.
Este guia explica o que é um bot de tráfego, por que existe tráfego de bots e como identificá-lo nas suas análises e nos logs do servidor. Partimos das definições, avançamos para uma rotina prática de detecção e, depois, para hábitos avançados de auditoria. Um princípio permeia tudo: mecanismos de busca e sistemas de IA leem suas páginas, mas o público que importa é sempre formado por pessoas reais.
O Que É um Bot de Tráfego?
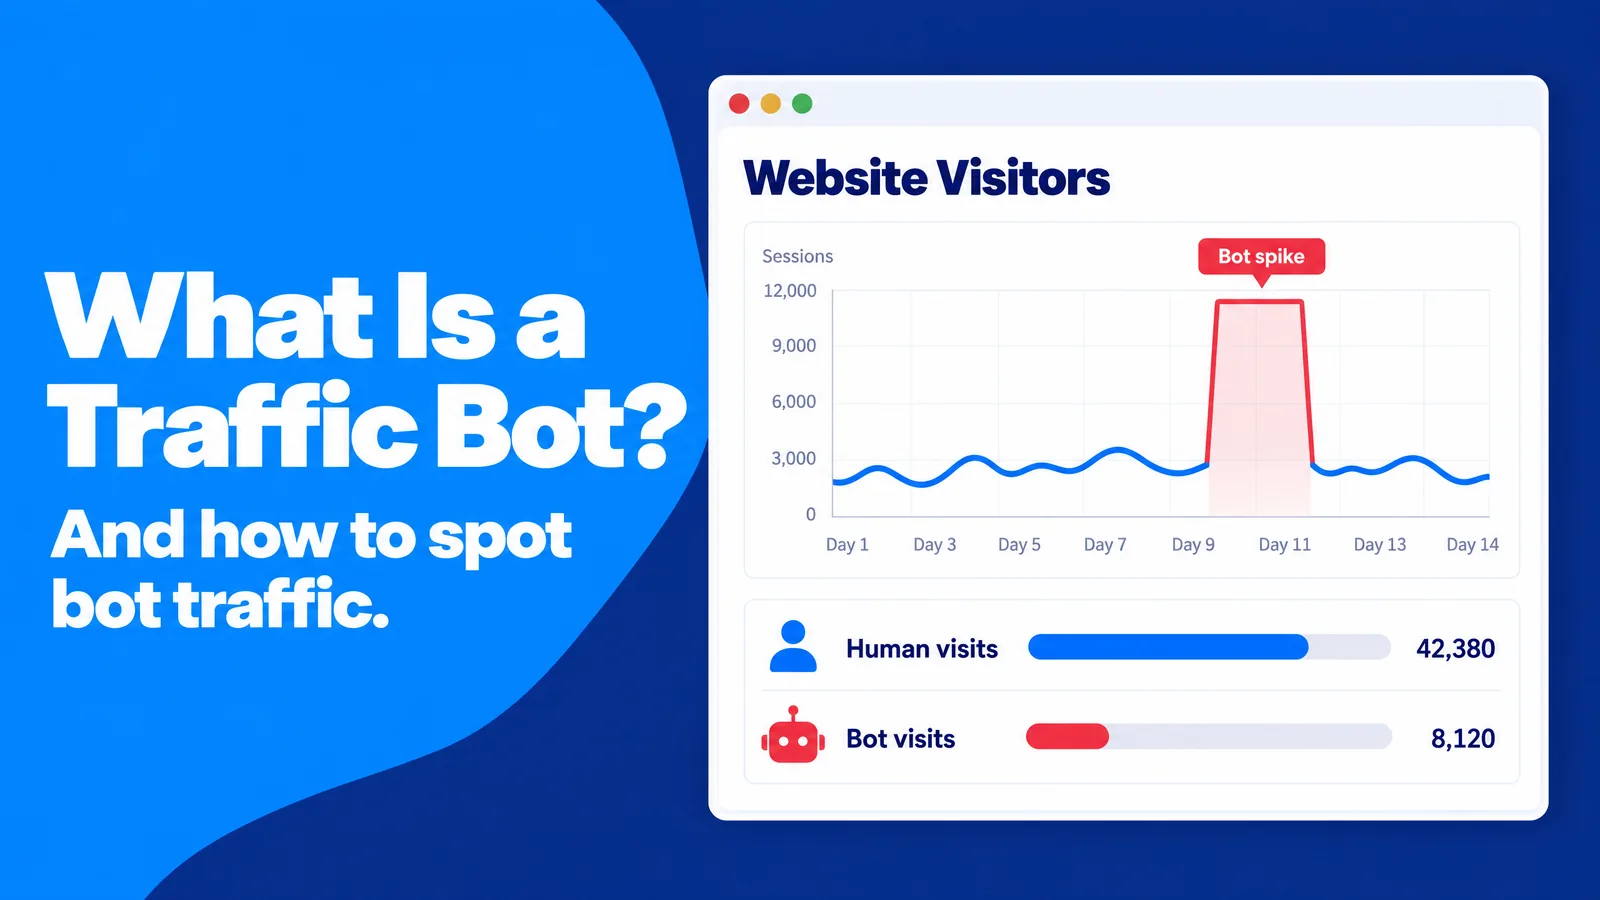
O termo "bot de tráfego" é usado de forma ampla, e isso gera confusão antes mesmo de qualquer análise começar. Um desenvolvedor pode usá-lo para um script de teste de carga. Um vendedor em um marketplace freelancer pode usá-lo para um software que promete "10.000 visitantes por dia". Uma equipe de segurança pode usá-lo para qualquer coisa que não seja uma pessoa e, quando três pessoas em uma reunião querem dizer três coisas diferentes, a equipe discute rótulos em vez de resolver o problema.
Neste guia, um bot de tráfego é um programa de software que envia visitas automatizadas a um site, aplicativo ou anúncio para que a atividade pareça vir de pessoas. Seu objetivo geralmente é inflar uma métrica, como visualizações de página, impressões de anúncios, cliques, visualizações de vídeo ou seguidores. Um bot de tráfego é um tipo de bot da internet, um aplicativo de software que executa tarefas automatizadas pela internet.
Neste guia, um bot de tráfego é um programa de software que envia visitas automatizadas a um site, aplicativo ou anúncio para que a atividade pareça vir de pessoas. Seu objetivo geralmente é inflar uma métrica, como visualizações de página, impressões de anúncios, cliques, visualizações de vídeo ou seguidores. Um bot de tráfego é um tipo de bot da internet, um aplicativo de software que executa tarefas automatizadas pela internet.
Bot de Tráfego vs. Tráfego de Bots
O tráfego de bots é a categoria mais ampla. Ele abrange toda visita ou solicitação feita por um programa, em vez de uma pessoa, qualquer que seja a intenção. Quando o Googlebot rastreia seu blog, isso é tráfego de bots. Ainda assim, ninguém chamaria o Googlebot de bot de tráfego, pois ele se identifica, segue suas regras de rastreamento e não finge ser um consumidor.
Essa diferença define sua resposta. O tráfego de bots de um crawler declarado exige gerenciamento: você decide o que ele pode acessar. Visitas de um bot de tráfego exigem detecção e exclusão, pois todo o objetivo de um bot de tráfego é se misturar a seus visitantes humanos.
Essa diferença define sua resposta. O tráfego de bots de um crawler declarado exige gerenciamento: você decide o que ele pode acessar. Visitas de um bot de tráfego exigem detecção e exclusão, pois todo o objetivo de um bot de tráfego é se misturar a seus visitantes humanos.
Bots Bons, Bots Ruins e a Zona Cinzenta
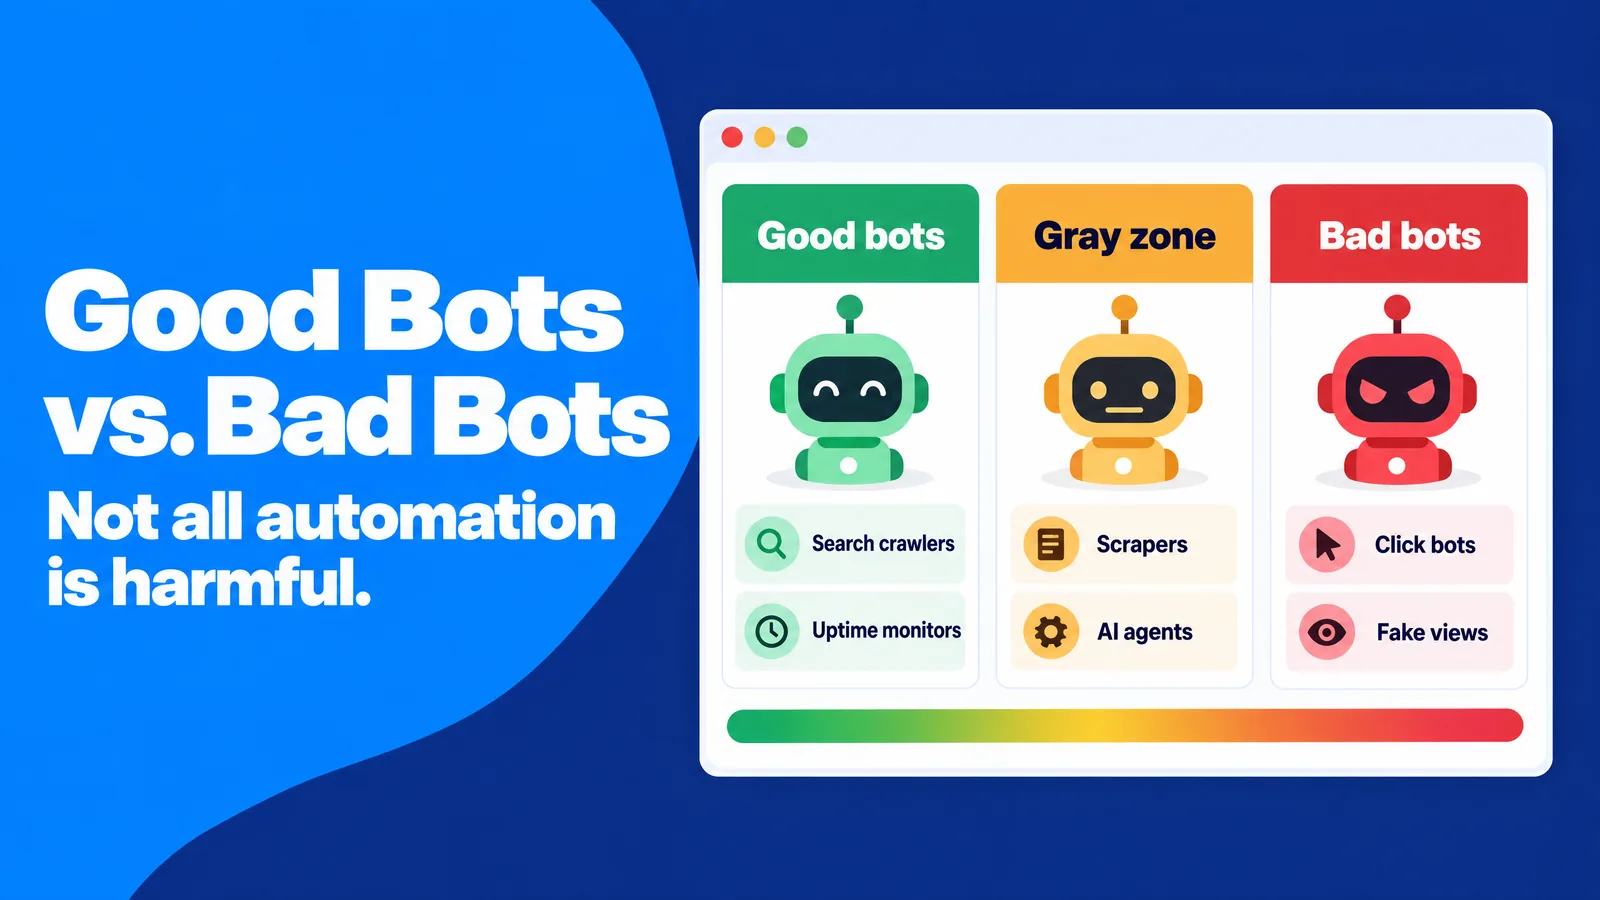
O setor de publicidade tem um vocabulário útil para isso. O Media Rating Council (MRC), órgão dos EUA que credencia a medição publicitária, divide o tráfego inválido em dois grupos nas suas normas de tráfego inválido:
- Tráfego inválido geral (GIVT): crawlers conhecidos, tráfego de data center e outras automações que filtros baseados em listas podem detectar.
- Tráfego inválido sofisticado (SIVT): bots que imitam o comportamento humano, dispositivos sequestrados, malware e atividade incentivada, que exigem uma análise mais profunda para serem identificados.
Entre o claramente bom e o claramente ruim existe uma zona cinzenta. Scrapers de monitoramento de preços, crawlers de ferramentas de SEO, crawlers de treinamento de IA e agentes de IA que navegam em nome de uma pessoa são todos automatizados. O fato de serem bem-vindos depende do seu modelo de negócio, não de uma regra universal.
Tipos Comuns de Bots de Tráfego
Os bots de tráfego se dividem em algumas famílias reconhecíveis. Conhecê-las ajuda você a deduzir qual delas está enfrentando pelo padrão que deixa:
- Bots de clique clicam em anúncios ou resultados de busca para drenar o orçamento de um concorrente ou simular engajamento, prática conhecida como fraude de cliques.
- Bots de impressão carregam anúncios em páginas falsas ou disfarçadas para que os anunciantes paguem por visualizações que ninguém viu.
- Programas de autosurf e de intercâmbio de tráfego alternam páginas entre membros para que todo site registre "visitas" que ninguém lê.
- Bots de spam de referência inserem uma URL nos seus relatórios de referência para induzir você a visitá-la, uma tática chamada spam de referência.
- Navegadores headless são navegadores completos sem tela. Desenvolvedores os usam para testes, e fraudadores já os usaram indevidamente para inflar impressões de anúncios.
- Fazendas de cliques usam pessoas mal remuneradas em vez de código. Os visitantes são tecnicamente humanos, mas a intenção é falsa, por isso as normas de medição tratam a atividade como inválida.
Etapa prática: Um primeiro passo útil é criar um inventário de uma página das automações que você convida. Ele lista seus crawlers de busca, monitores de disponibilidade, crawlers de SEO, webhooks de pagamento e os assistentes de IA dos quais você quer citações, com o user agent que cada um declara. Isso funciona porque muitos falsos positivos vêm das suas próprias ferramentas: um rastreamento de SEO agendado para as 3h parece exatamente um pico noturno suspeito até você conferir o inventário.
Por Que Visitantes Reais Deixam uma Marca Reconhecível
Grande parte dos conselhos sobre tráfego de bots começa pelo que parece errado. Um ponto de partida mais confiável é entender como é o normal, pois você não pode avaliar uma anomalia sem uma referência.
Visitantes humanos são maravilhosamente inconsistentes. Uma pessoa lê sua página de preços no celular durante o deslocamento por 40 segundos. Outra deixa uma aba aberta no desktop por 12 minutos, e uma terceira sai após dois segundos porque tocou no resultado errado.
Essa desordem é o sinal mais forte que você tem. Cada visita humana traz dezenas de pequenas variações: tamanho de tela, versão do navegador, fuso horário, velocidade de rolagem, a pausa antes de um clique. O tráfego automatizado tem dificuldade de copiar toda essa variedade em escala, porque cada nova variação custa tempo de engenharia e infraestrutura ao operador do bot. Uma rede de bots pode falsificar uma ou duas dimensões de forma convincente, mas falsificar todas de uma vez, em milhares de sessões, é caro.
SparkTraffic, uma plataforma de publicidade que entrega visitas geograficamente segmentadas a sites por meio de anúncios em sites de publishers parceiros desde 2015, se baseia nesse princípio de variedade em um teste de cinco verificações publicado para seus próprios anunciantes. O raciocínio é simples: qualquer pessoa que pague por visitas deve poder confirmar, com análises padrão e sem ferramentas especiais, que essas visitas se comportam como pessoas. As mesmas verificações funcionam para qualquer fonte, paga ou orgânica, portanto são uma boa referência de uso geral para seus próprios relatórios.
O Teste de Cinco Verificações da Pegada Humana
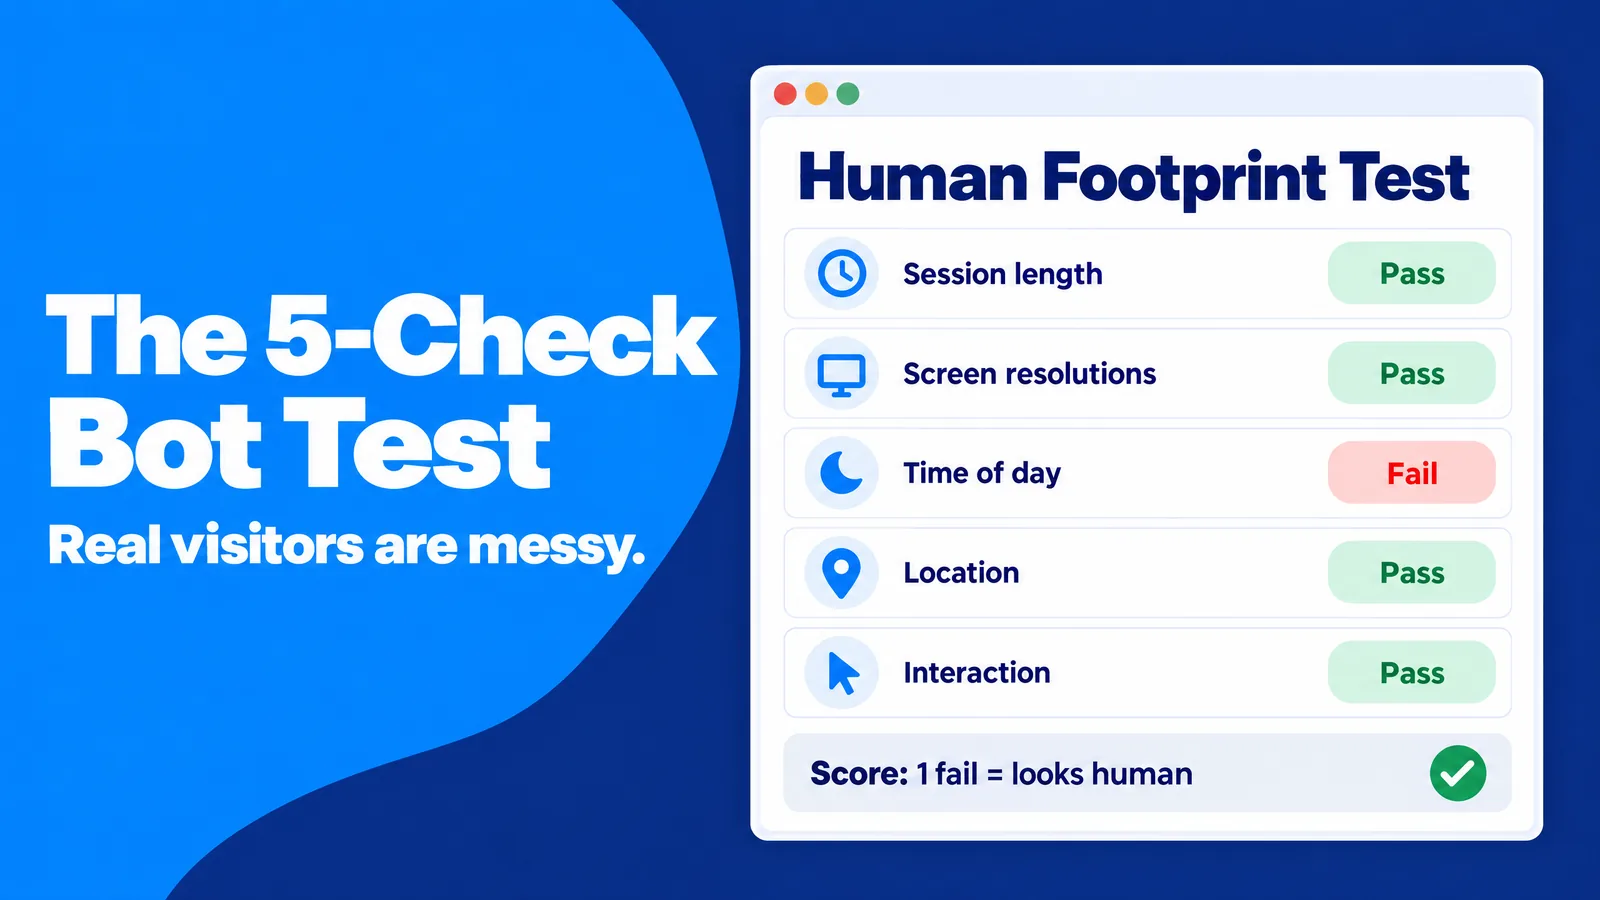
Cada verificação compara uma dimensão do comportamento com a variedade que você esperaria de pessoas reais. Os limites são deliberadamente flexíveis, para que amostras pequenas e flutuações normais não gerem falsos alarmes:
- Duração da sessão: o tráfego saudável varia de menos de 10 segundos a mais de dois minutos. Um sinal de alerta é mais da metade das sessões cair na mesma faixa de cinco segundos.
- Resoluções de tela: o tráfego saudável mostra muitas resoluções diferentes. Um sinal de alerta é uma única resolução representar mais da metade das sessões.
- Hora do dia: o tráfego saudável segue padrões locais diurnos. Um sinal de alerta é o volume local entre 1h e 5h igualar os níveis diurnos.
- Localização: o tráfego saudável e segmentado envia mais de 90% das visitas da área alvo. Um sinal de alerta é mais de 10% chegarem de lugares que você não segmentou.
- Interação: o tráfego saudável inclui algumas rolagens, cliques ou inícios de formulário. Um sinal de alerta é não haver interações em 300 sessões.
Zero ou uma verificação reprovada sugere que o tráfego se comporta como pessoas. Duas ou mais falhas são motivo para pausar a fonte, exportar cerca de 20 sessões como evidência e pedir uma revisão ao fornecedor. Essa pontuação funciona porque uma métrica estranha isolada costuma ter uma causa inocente, como uma campanha somente para celular que reduz as resoluções de tela, enquanto várias falhas ao mesmo tempo raramente têm.
Crie sua Própria Base de Referência Humana
Limites genéricos são um ponto de partida, não um veredito. Um blog de receitas, um site de documentação SaaS e um dentista local têm durações de sessão e ritmos diários diferentes. Uma sessão média de cinco minutos pode parecer suspeita em uma página de localizador de lojas e perfeitamente normal em um tutorial longo.
Etapa prática: A referência mais confiável é um canal no qual você já confia, como cliques de newsletter ou clientes conectados. Registrar sua distribuição nas cinco dimensões acima por 30 dias fornece uma referência, e qualquer fonte nova que pareça estranha pode ser comparada a ela, em vez de à média do setor. Isso funciona porque seu canal confiável já reflete seu público, seus dispositivos e seus fusos horários, então um grande desvio aponta para a fonte, não para seu site.
Etapa prática: A referência mais confiável é um canal no qual você já confia, como cliques de newsletter ou clientes conectados. Registrar sua distribuição nas cinco dimensões acima por 30 dias fornece uma referência, e qualquer fonte nova que pareça estranha pode ser comparada a ela, em vez de à média do setor. Isso funciona porque seu canal confiável já reflete seu público, seus dispositivos e seus fusos horários, então um grande desvio aponta para a fonte, não para seu site.
Por Que Existem Bots de Tráfego e Quanto Eles Custam
Bots de tráfego existem porque alguém lucra com atividade falsa. O lucro pode ser direto, como na fraude publicitária, ou indireto, como no caso de um fornecedor que vende "tráfego" que faz um painel parecer movimentado. Entender o motivo ajuda você a prever o padrão: um fraudador quer impressões e cliques, um vendedor de métricas de vaidade quer visualizações de página e um spammer quer sua atenção.
Fraude Publicitária em Escala Industrial
O exemplo mais bem documentado é o Methbot. Segundo o Departamento de Justiça dos EUA, a operação usou mais de 1.900 servidores e mais de 650.000 endereços IP para carregar anúncios em mais de 5.000 sites falsificados, arrecadando mais de US$ 7 milhões. Um esquema relacionado, o 3ve, operou em cerca de 1,7 milhão de computadores infectados e obteve mais de US$ 29 milhões.
Os bots foram criados para parecer humanos. O anúncio de condenação do DOJ descreve bots que simulavam movimentos do mouse, rolagem e logins em redes sociais, e o principal operador recebeu uma pena de 10 anos de prisão. A lição para profissionais de marketing é que o "engajamento realista" por si só não prova nada, porque o Methbot foi projetado para produzir exatamente isso.
Os bots foram criados para parecer humanos. O anúncio de condenação do DOJ descreve bots que simulavam movimentos do mouse, rolagem e logins em redes sociais, e o principal operador recebeu uma pena de 10 anos de prisão. A lição para profissionais de marketing é que o "engajamento realista" por si só não prova nada, porque o Methbot foi projetado para produzir exatamente isso.
Popularidade Falsa e Métricas de Vaidade
Um segundo motivo é a aparência de popularidade. Alguns fornecedores vendem software de bot de tráfego ou "pacotes de visitantes" que inflam visualizações de página, visualizações de vídeo ou contagens de seguidores. No início da web, contadores de acessos brutos impressionavam as pessoas, e números inflados traziam um retorno de curto prazo. Hoje, mecanismos de busca, anunciantes e investidores analisam engajamento, conversões e receita, portanto volume falso não compra nada e contamina os dados de que você precisa.
Reguladores agora tratam a popularidade falsa como fraude. Em agosto de 2024, a Federal Trade Commission dos EUA finalizou uma regra que proíbe vender ou comprar indicadores falsos de influência em redes sociais, como seguidores ou visualizações gerados por bots. A proibição se aplica quando o comprador sabia ou deveria saber que os indicadores eram falsos e os usava para fins comerciais. As políticas de publicidade do Google também proíbem promover serviços que vendem atividade de usuário falsificada, como cliques inválidos.
Reguladores agora tratam a popularidade falsa como fraude. Em agosto de 2024, a Federal Trade Commission dos EUA finalizou uma regra que proíbe vender ou comprar indicadores falsos de influência em redes sociais, como seguidores ou visualizações gerados por bots. A proibição se aplica quando o comprador sabia ou deveria saber que os indicadores eram falsos e os usava para fins comerciais. As políticas de publicidade do Google também proíbem promover serviços que vendem atividade de usuário falsificada, como cliques inválidos.
Spam de Referência e Tráfego Fantasma
Um terceiro motivo é a atenção. Bots de spam de referência visitam seu site, ou enviam dados diretamente para sua propriedade de análise, com uma URL de referência falsa. Quando você vê um domínio desconhecido no seu relatório de referências, a curiosidade faz o resto, e o spammer consegue uma visita ou uma venda. O artigo da Wikipédia sobre spam de referência descreve como essa tática passou dos logs de servidor para as ferramentas de análise.
O Custo Real: Decisões Baseadas em Dados Falsos
O custo direto do tráfego de bots é o desperdício de verba de anúncios e a carga no servidor. O custo indireto costuma ser maior. Imagine um teste A/B em que a variante B recebe 600 sessões extras de bots sem nenhuma conversão: a taxa de conversão de B cai, você mantém a página mais fraca e ninguém descobre o motivo. Ou imagine uma equipe de conteúdo que investe ainda mais em um tema porque um scraper rastreava esses artigos a cada hora.
Etapa prática: Uma estimativa do custo de contaminação torna o problema concreto. Ela multiplica a parcela de sessões que falharam em duas ou mais das cinco verificações pelo seu gasto trimestral em mídia paga. Depois, lista cada decisão, como alterações de orçamento, vencedores de testes e prioridades de conteúdo, que se baseou nesses relatórios. Isso funciona porque transforma uma questão abstrata de qualidade de dados em um valor de orçamento, o que facilita muito conseguir aprovação para tempo e ferramentas.
Etapa prática: Uma estimativa do custo de contaminação torna o problema concreto. Ela multiplica a parcela de sessões que falharam em duas ou mais das cinco verificações pelo seu gasto trimestral em mídia paga. Depois, lista cada decisão, como alterações de orçamento, vencedores de testes e prioridades de conteúdo, que se baseou nesses relatórios. Isso funciona porque transforma uma questão abstrata de qualidade de dados em um valor de orçamento, o que facilita muito conseguir aprovação para tempo e ferramentas.
Como Identificar Tráfego de Bots no Google Analytics 4
O Google Analytics 4 (GA4) já exclui bots conhecidos automaticamente, usando as próprias pesquisas do Google e a IAB/ABC International Spiders and Bots List. Você não pode desativar isso nem ver quanto tráfego foi removido. Isso parece tranquilizador, mas significa que os bots que restam nos seus relatórios são, por definição, aqueles que não estão em nenhuma lista. A detecção de tráfego de bots além dessa lista é sua responsabilidade.
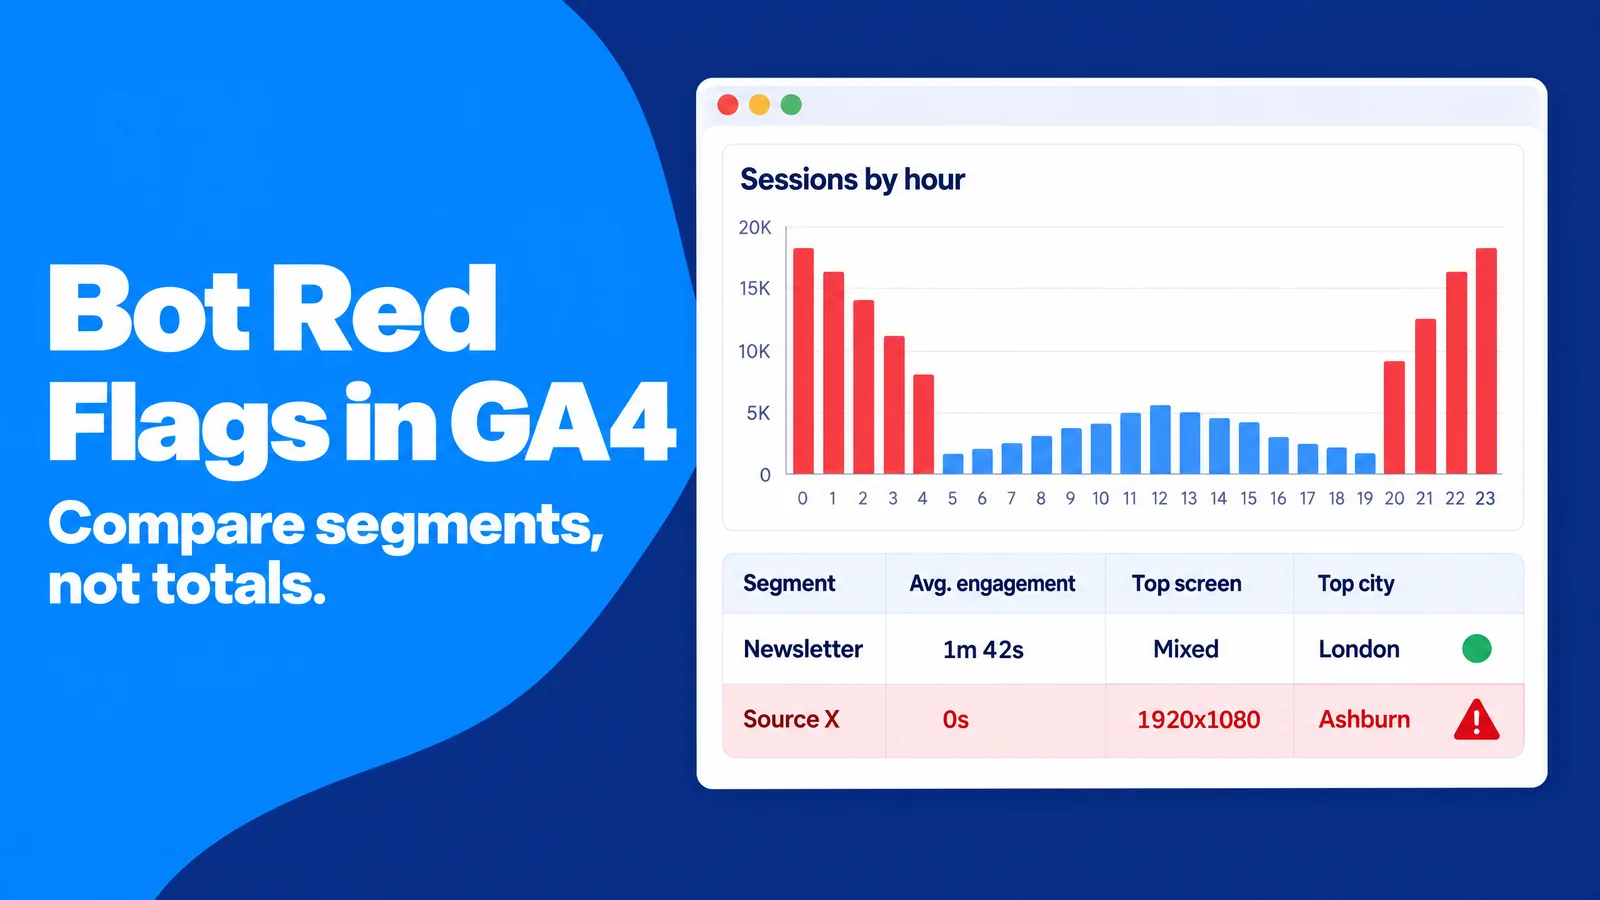
A boa notícia é que bots desconhecidos ainda deixam padrões. Eles tendem a chegar em rajadas, usar um conjunto restrito de dispositivos, ignorar seus caminhos de conversão e se concentrar em lugares onde seus clientes não vivem. Você identifica tráfego de bots comparando segmentos, não olhando apenas para totais.
A boa notícia é que bots desconhecidos ainda deixam padrões. Eles tendem a chegar em rajadas, usar um conjunto restrito de dispositivos, ignorar seus caminhos de conversão e se concentrar em lugares onde seus clientes não vivem. Você identifica tráfego de bots comparando segmentos, não olhando apenas para totais.
Comece pelo Formato do Pico
Picos naturais de tráfego têm uma causa e um formato. Uma newsletter, uma publicação em rede social ou uma menção na imprensa produz uma alta acentuada seguida de uma queda gradual ao longo de horas ou dias, e as conversões sobem junto. Picos de bots costumam parecer diferentes: platôs de topo plano, inícios e paradas em horas cheias e sessões que sobem enquanto os eventos principais permanecem estáveis.
Quando surge um pico, a primeira pergunta é "o que aconteceu naquele momento?". Se nenhuma campanha, menção ou evento sazonal o explica, é melhor tratar o pico como não verificado até que a comparação de segmentos abaixo indique o contrário.
Quando surge um pico, a primeira pergunta é "o que aconteceu naquele momento?". Se nenhuma campanha, menção ou evento sazonal o explica, é melhor tratar o pico como não verificado até que a comparação de segmentos abaixo indique o contrário.
Oito Sinais de Alerta nos Seus Relatórios
Vale a pena verificar estes padrões sempre que uma fonte ou landing page parecer incomum:
- Tempo de engajamento perto de zero: muitas sessões com quase nenhum tempo de engajamento ou durações concentradas nos mesmos poucos segundos.
- Picos de Direct ou Unassigned: crescimento repentino de tráfego Direct ou Unassigned para uma landing page que não está vinculada em nenhum lugar óbvio.
- Hostnames desconhecidos: acessos registrados em domínios que não são seus, o que acontece quando alguém copia seu ID de medição para outro site.
- Um perfil de dispositivo: uma única resolução de tela, versão de navegador ou sistema operacional dominando uma fonte.
- Localizações de data center: grupos em cidades conhecidas por fazendas de servidores, como Ashburn, Virgínia, em vez de onde seus clientes vivem.
- Tráfego no turno da noite: volume local entre 1h e 5h igual ao volume diurno.
- Referenciadores estranhos: domínios desconhecidos, especialmente os que anunciam serviços de SEO ou tráfego.
- Conversões estagnadas: sessões em alta enquanto cadastros, compras ou leads qualificados permanecem estáveis, ou envios de formulário cheios de caracteres sem sentido.
Crie uma Exploração para Investigar Bots
A seção Explorar do GA4 permite criar um relatório reutilizável para esse trabalho. Uma exploração de formato livre com as dimensões certas responde à maioria das perguntas em minutos, e um modelo salvo evita que a próxima investigação comece do zero:
- Configuração: uma exploração de formato livre com as dimensões origem/mídia da sessão, landing page, hostname, resolução de tela, cidade e hora.
- Métricas: sessões, sessões engajadas, tempo médio de engajamento por sessão e eventos principais.
- Segmentos: um para a fonte suspeita e outro para seu canal de referência confiável.
- Comparação: os dois segmentos lado a lado, dimensão por dimensão, usando as cinco verificações como guia.
- Evidências: uma exportação de cerca de 20 sessões suspeitas com seus atributos, pronta para compartilhar com um fornecedor ou plataforma de anúncios.
Esse método funciona porque os bots raramente falham em uma única dimensão isolada. Segmentos lado a lado tornam visíveis, ao mesmo tempo, o perfil estreito de dispositivo, os horários estranhos e as conversões ausentes. Nosso guia sobre como usar análises para melhorar o tráfego do seu site aborda os relatórios centrais do GA4, e o guia sobre atribuição de tráfego por IA explica como interpretar o tráfego Direct sem tirar conclusões precipitadas.
Use Filtros de Dados do GA4 com Cuidado
Os filtros de dados são a principal forma de excluir tráfego de bots no GA4 quando você sabe de onde ele vem. Eles podem remover tráfego interno, tráfego de desenvolvedores e, mais recentemente, acessos de hostnames que não são seus. Um filtro de hostname que inclui apenas seus próprios domínios é uma solução limpa para IDs de medição copiados em outros sites. Filtros são poderosos, mas implacáveis: quando um filtro está ativo, os dados excluídos se perdem para sempre.
Etapa prática: O hábito mais seguro é executar cada novo filtro no modo de teste por pelo menos uma semana e comparar os resultados filtrados e não filtrados antes de ativá-lo. Isso protege você de excluir dados reais de clientes por causa de um erro de digitação em um nome de domínio ou de uma regra ampla demais.
Etapa prática: O hábito mais seguro é executar cada novo filtro no modo de teste por pelo menos uma semana e comparar os resultados filtrados e não filtrados antes de ativá-lo. Isso protege você de excluir dados reais de clientes por causa de um erro de digitação em um nome de domínio ou de uma regra ampla demais.
Como Verificar Bots no Nível do Servidor
Ferramentas de análise só veem visitantes que executam seu código de rastreamento. Muitos bots nunca executam JavaScript, então nunca aparecem no GA4, mas ainda consomem largura de banda, raspam conteúdo e sondam formulários de login. Os logs do seu servidor, os logs de CDN ou o painel de hospedagem mostram cada solicitação, o que faz deles o lugar para confirmar quem realmente está visitando.
Por Que User Agents Não Provam Nada
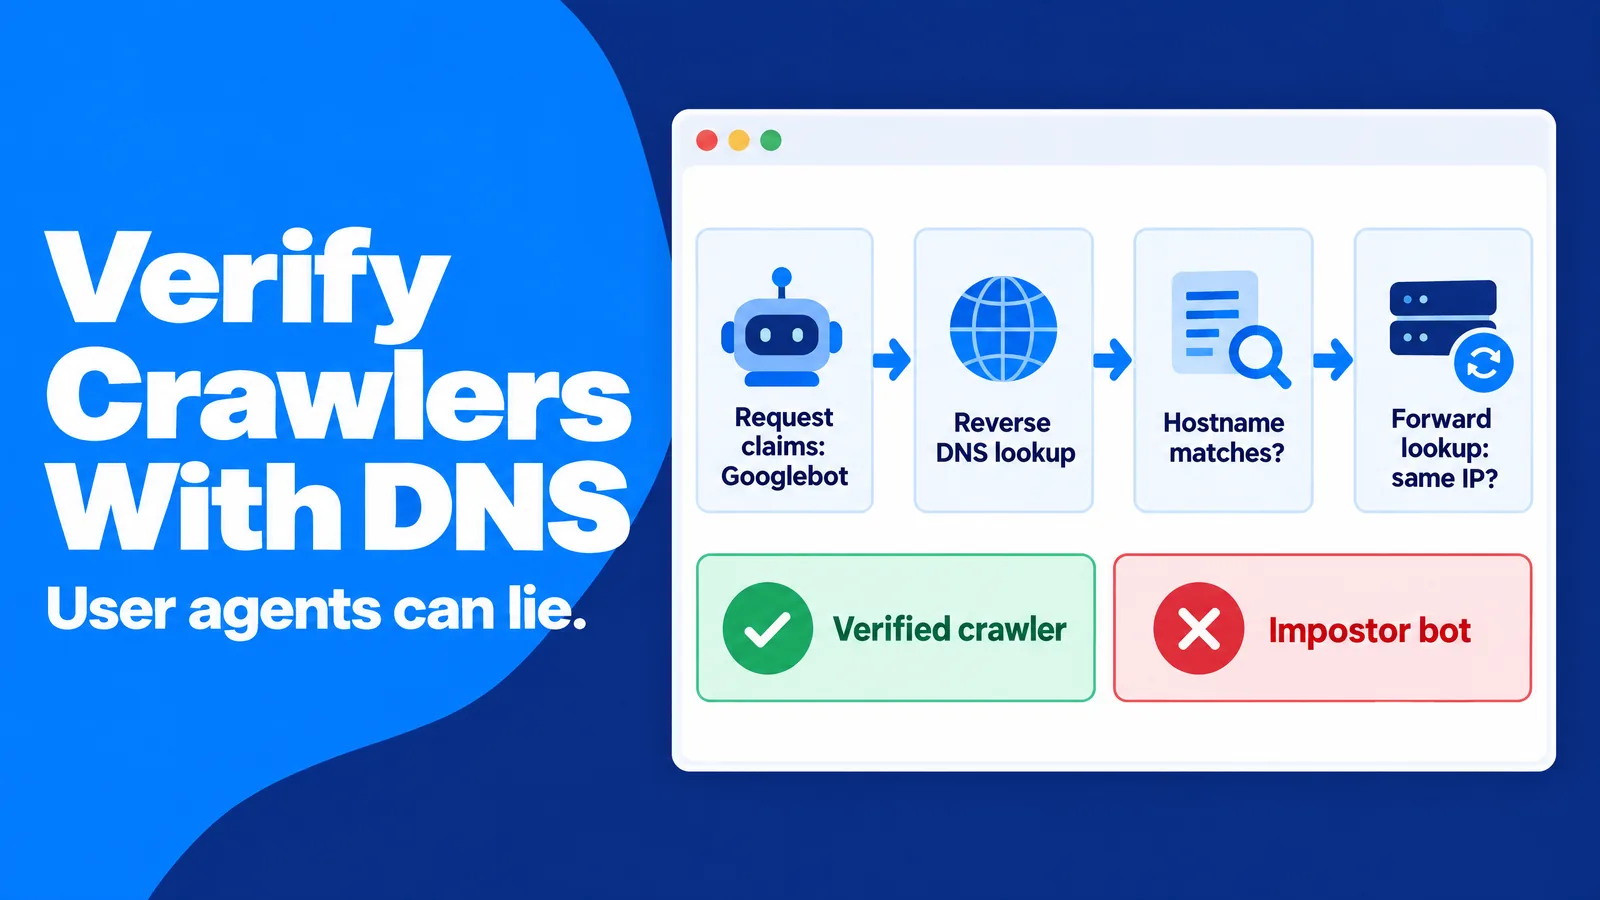
Toda solicitação traz uma string de user agent que identifica o navegador ou bot. O problema é que o visitante a escreve. Um scraper pode alegar ser o Googlebot, o Chrome em um iPhone ou qualquer outra coisa com uma linha de código, portanto tratar o user agent como identidade é como aceitar um crachá como passaporte.
Confirme Crawlers com DNS Reverso Confirmado por Encaminhamento
A forma padrão de verificar um crawler autodeclarado é o DNS reverso confirmado por encaminhamento. Ela exige duas consultas. Uma consulta DNS reversa no endereço IP do visitante retorna um hostname, que deve pertencer ao domínio do operador declarado. Uma consulta direta nesse hostname precisa retornar o mesmo IP, portanto um Googlebot falso falha porque seu endereço IP não é resolvido de volta para os domínios do Google.
Etapa prática: Uma amostra mensal de logs mantém isso administrável. Extrair os 20 user agents que fizeram mais solicitações e executar a verificação em qualquer um que alegue ser um mecanismo de busca ou um crawler importante de IA leva poucos minutos. Isso funciona porque impostores se concentram onde a recompensa é maior: fingir ser um crawler confiável é a maneira mais fácil de passar por limites de taxa e firewalls.
Etapa prática: Uma amostra mensal de logs mantém isso administrável. Extrair os 20 user agents que fizeram mais solicitações e executar a verificação em qualquer um que alegue ser um mecanismo de busca ou um crawler importante de IA leva poucos minutos. Isso funciona porque impostores se concentram onde a recompensa é maior: fingir ser um crawler confiável é a maneira mais fácil de passar por limites de taxa e firewalls.
Robots.txt É um Pedido, Não um Cadeado
O arquivo robots.txt informa aos crawlers o que eles podem acessar, e o formato é padronizado na RFC 9309. A conformidade é voluntária. Crawlers bem-comportados o respeitam, enquanto bots de tráfego e muitos scrapers o ignoram ou mudam seus nomes para escapar de bloqueios.
O robots.txt ainda é útil porque separa bots que respeitam suas regras daqueles que não respeitam. A Wikipédia observa que 306 dos 1.000 sites mais visitados bloquearam o GPTBot da OpenAI em 2023, o que mostra como donos de sites agora usam o arquivo como uma declaração de política. Um bot que solicita páginas que você proibiu revelou algo importante sobre sua intenção.
O robots.txt ainda é útil porque separa bots que respeitam suas regras daqueles que não respeitam. A Wikipédia observa que 306 dos 1.000 sites mais visitados bloquearam o GPTBot da OpenAI em 2023, o que mostra como donos de sites agora usam o arquivo como uma declaração de política. Um bot que solicita páginas que você proibiu revelou algo importante sobre sua intenção.
A Identidade de Bots Assinada Está Chegando
A solução de longo prazo para a falsificação de identidade é a identidade criptográfica. A Internet Engineering Task Force (IETF) criou um grupo de trabalho Web Bot Auth para padronizar como bots podem provar quem são, com base em HTTP Message Signatures. Um bot assinado anexa uma assinatura verificável a cada solicitação, para que um site possa confirmar seu operador sem depender de listas de IPs. Acompanhar esse trabalho agora ajuda você a planejar quais visitantes automatizados permitirá quando as assinaturas se tornarem comuns.
Como Bloquear o Tráfego de Bots sem Bloquear Pessoas Reais
Bloquear bots parece simples até clientes reais ficarem presos na rede. Barreiras agressivas de CAPTCHA frustram pessoas em celulares lentos e criam obstáculos para usuários de tecnologia assistiva. Bloqueios amplos por país ou data center podem impedir viajantes, usuários de VPN corporativa e visitantes preocupados com privacidade, e cada falso positivo é um lead perdido que nunca aparece em nenhum relatório.
Uma abordagem moderna também precisa considerar automações úteis. Assistentes de IA buscam páginas, comparam produtos e preenchem formulários cada vez mais em nome de uma pessoa. Tratar toda solicitação não humana como hostil pode afastar visitas que um cliente real pediu.
Uma abordagem moderna também precisa considerar automações úteis. Assistentes de IA buscam páginas, comparam produtos e preenchem formulários cada vez mais em nome de uma pessoa. Tratar toda solicitação não humana como hostil pode afastar visitas que um cliente real pediu.
Associe a Resposta ao Bot
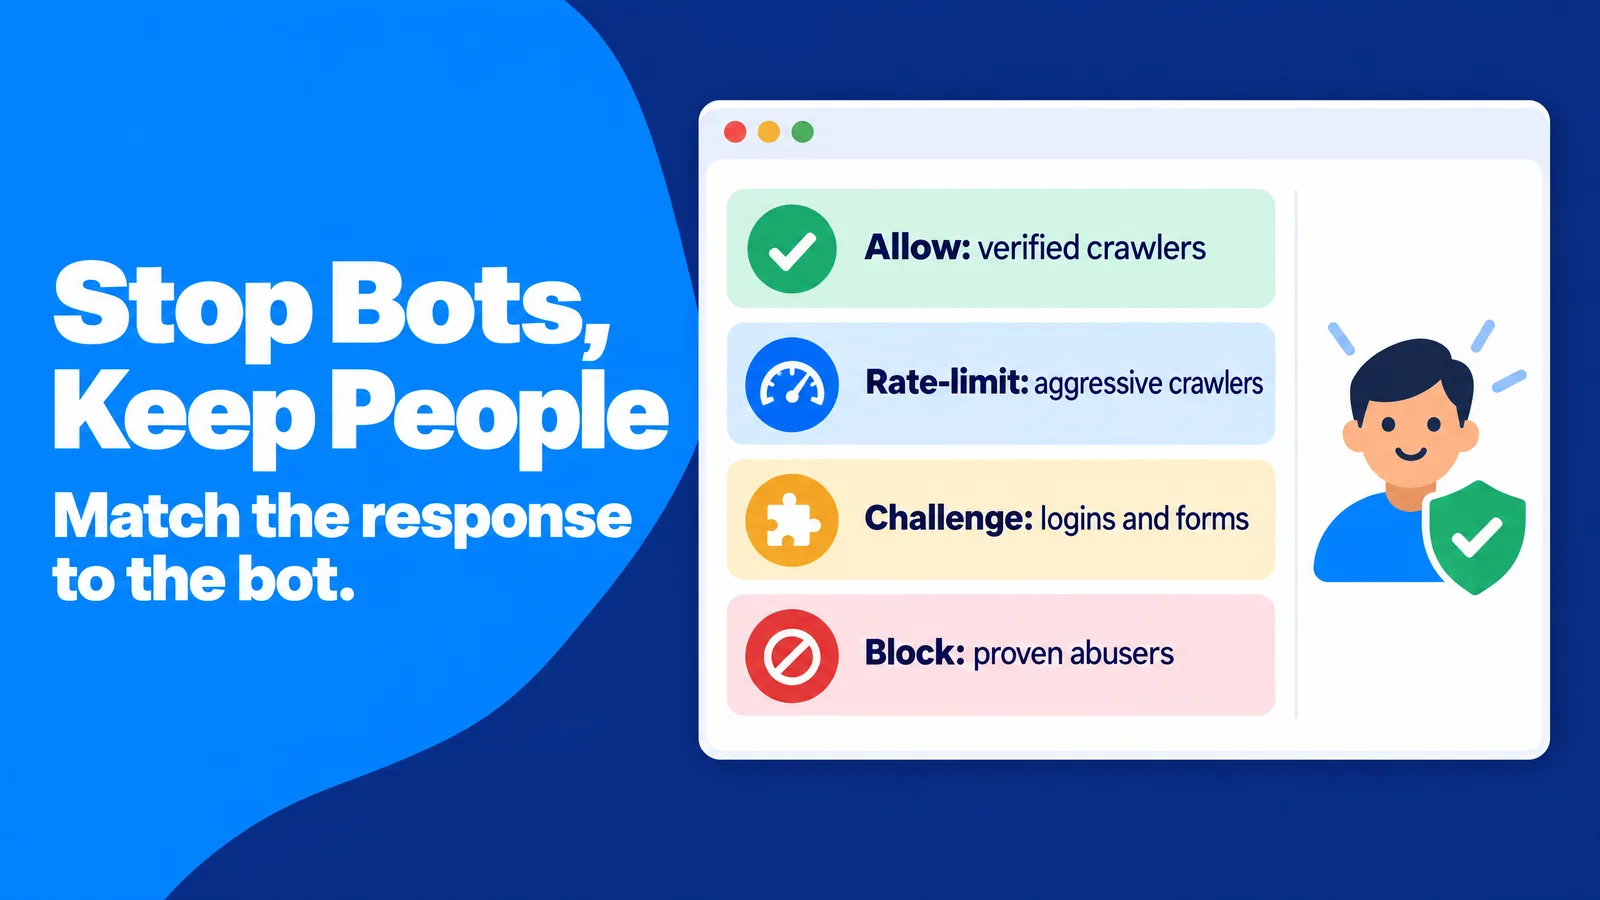
As defesas mais eficazes são graduais, não de tudo ou nada. Cada tipo de visitante automatizado recebe a resposta mais leve que resolve o problema:
- Crawlers verificados que você quer: permitidos, pois trazem visibilidade em buscas e citações de IA.
- Crawlers agressivos, mas legítimos: limitados por taxa, o que protege o desempenho do servidor sem quebrar nada.
- Tráfego não verificado em páginas sensíveis: desafiado com um CAPTCHA ou teste semelhante apenas em logins, cadastros e checkout, onde o custo do abuso é maior.
- Infratores comprovados: bloqueados por faixa de IP, rede ou assinatura quando a evidência é clara.
Essa gradação funciona porque concentra atrito onde o abuso causa dano real e mantém o resto do seu site rápido e aberto para as pessoas.
Proteja Formulários, Cadastros e Checkout
Os formulários são onde os bots causam os danos mais duradouros. Cadastros falsos poluem seu CRM, disparam e-mails de boas-vindas para endereços que retornam erro e prejudicam sua reputação de remetente. Leads falsos desperdiçam o tempo da equipe de vendas e distorcem relatórios de custo por lead.
Etapa prática: Uma primeira camada simples é um campo honeypot: um campo de formulário oculto para pessoas, mas visível para bots, de modo que qualquer envio que o preencha possa ser rejeitado. Validação no servidor, limites de taxa por endereço IP e double opt-in para listas de e-mail acrescentam outras camadas. Essa configuração funciona porque cada camada interrompe um tipo diferente de bot, enquanto uma pessoa real não percebe nenhuma delas.
Etapa prática: Uma primeira camada simples é um campo honeypot: um campo de formulário oculto para pessoas, mas visível para bots, de modo que qualquer envio que o preencha possa ser rejeitado. Validação no servidor, limites de taxa por endereço IP e double opt-in para listas de e-mail acrescentam outras camadas. Essa configuração funciona porque cada camada interrompe um tipo diferente de bot, enquanto uma pessoa real não percebe nenhuma delas.
Deixe a Porta Aberta para Agentes de IA que Agem pelas Pessoas
Algumas visitas automatizadas agora representam demanda real. Um agente de IA que verifica seus preços ou agenda uma demonstração para um usuário é uma interação de cliente realizada por software. Bloqueá-lo totalmente pode custar uma venda, enquanto deixá-lo passar sem análise pode distorcer suas métricas de engajamento.
O meio-termo prático é identificar esses agentes separadamente, permiti-los em páginas públicas e medi-los no próprio segmento. Nosso guia sobre tráfego de IA agêntica explica como visitas assistidas por agentes aparecem nas análises e como preparar suas páginas para elas.
O meio-termo prático é identificar esses agentes separadamente, permiti-los em páginas públicas e medi-los no próprio segmento. Nosso guia sobre tráfego de IA agêntica explica como visitas assistidas por agentes aparecem nas análises e como preparar suas páginas para elas.
Como Manter as Campanhas de Tráfego Pago Livres de Bots
O tráfego pago é onde o tráfego de bots prejudica seu orçamento de forma mais direta. Cada clique ou impressão inválida é dinheiro gasto com ninguém. O risco é maior em inventário barato e amplo e com fornecedores que não conseguem dizer de onde vêm suas visitas, pois o incentivo deles é volume, não resultados.
Algumas ofertas são bots de tráfego disfarçados. Os sinais de alerta incluem promessas de visitas "indetectáveis" ou "com aparência real", melhorias garantidas em ranking de busca, visitantes ilimitados por uma taxa fixa e redes de proxies residenciais apresentadas como recurso. Plataformas de publicidade legítimas falam, em vez disso, sobre segmentação, posicionamentos, revisão de landing pages e mensuração. Comprar visitas de bots sempre sai pela culatra: as visitas nunca convertem, corrompem seus testes, redes de anúncios podem banir sites monetizados que as recebem, e a própria compra pode infringir regras de proteção ao consumidor.
Algumas ofertas são bots de tráfego disfarçados. Os sinais de alerta incluem promessas de visitas "indetectáveis" ou "com aparência real", melhorias garantidas em ranking de busca, visitantes ilimitados por uma taxa fixa e redes de proxies residenciais apresentadas como recurso. Plataformas de publicidade legítimas falam, em vez disso, sobre segmentação, posicionamentos, revisão de landing pages e mensuração. Comprar visitas de bots sempre sai pela culatra: as visitas nunca convertem, corrompem seus testes, redes de anúncios podem banir sites monetizados que as recebem, e a própria compra pode infringir regras de proteção ao consumidor.
Marque Cada Fonte Paga
O tráfego pago sem tags se mistura a Direct e Referral, onde bots se escondem facilmente. Os parâmetros UTM são tags adicionadas a um link que informam à sua ferramenta de análise exatamente qual fonte, campanha e posicionamento enviou uma visita.
Etapa prática: Uma regra simples de UTM resolve a maioria das lacunas de atribuição: cada campanha paga recebe seus próprios valores de fonte, mídia e campanha, registrados em uma planilha de nomenclatura compartilhada. Isso funciona porque o teste de cinco verificações precisa de um segmento limpo para funcionar, e se as visitas pagas estiverem misturadas a Direct, você não poderá saber qual fornecedor enviou as sessões suspeitas.
Etapa prática: Uma regra simples de UTM resolve a maioria das lacunas de atribuição: cada campanha paga recebe seus próprios valores de fonte, mídia e campanha, registrados em uma planilha de nomenclatura compartilhada. Isso funciona porque o teste de cinco verificações precisa de um segmento limpo para funcionar, e se as visitas pagas estiverem misturadas a Direct, você não poderá saber qual fornecedor enviou as sessões suspeitas.
Faça um Teste Pequeno Antes de Escalar
Um orçamento pequeno de teste indica se uma fonte se comporta como pessoas antes de você comprometer dinheiro de verdade. Algumas centenas de sessões são suficientes para executar as cinco verificações, e uma semana de dados mostra os ritmos diários. A mesma disciplina melhora seu trabalho com landing pages, como mostra nosso guia sobre testes A/B de uma landing page com tráfego pago.
Os formatos de anúncio também importam. Tráfego popunder, nativo e push produz padrões de engajamento diferentes, pois um visitante de popunder se comporta de modo diferente de alguém que escolheu clicar em um anúncio nativo. Avaliar cada formato pela própria referência evita falsos alarmes.
Os formatos de anúncio também importam. Tráfego popunder, nativo e push produz padrões de engajamento diferentes, pois um visitante de popunder se comporta de modo diferente de alguém que escolheu clicar em um anúncio nativo. Avaliar cada formato pela própria referência evita falsos alarmes.
Trate as Políticas de Reembolso e Crédito como Sinais de Qualidade
Plataformas respeitáveis esperam que você verifique o tráfego delas e explicam o que acontece quando algo parece errado. Uma boa plataforma tem um processo claro: quais evidências precisa, como revisa um relatório e se concede crédito por atividade inválida. Um fornecedor que recusa qualquer revisão ou afirma que seu tráfego é "100% humano" está lhe dizendo algo. Até o MRC evita chamar tráfego filtrado de "humano" e prefere a palavra "válido", pois nenhum filtro pode garantir que toda visita restante seja de uma pessoa.
Estratégia Avançada: Faça uma Auditoria Mensal do Tráfego de Bots
Investigações pontuais resolvem problemas pontuais. Bots mudam, campanhas mudam e suas próprias ferramentas mudam, então uma rotina mensal curta detecta problemas antes que distorçam um trimestre de decisões. O objetivo não é ter tráfego de bots zero, o que é impossível. O objetivo é ter tráfego de bots conhecido, medido e documentado.
Uma Rotina Mensal de 30 Minutos
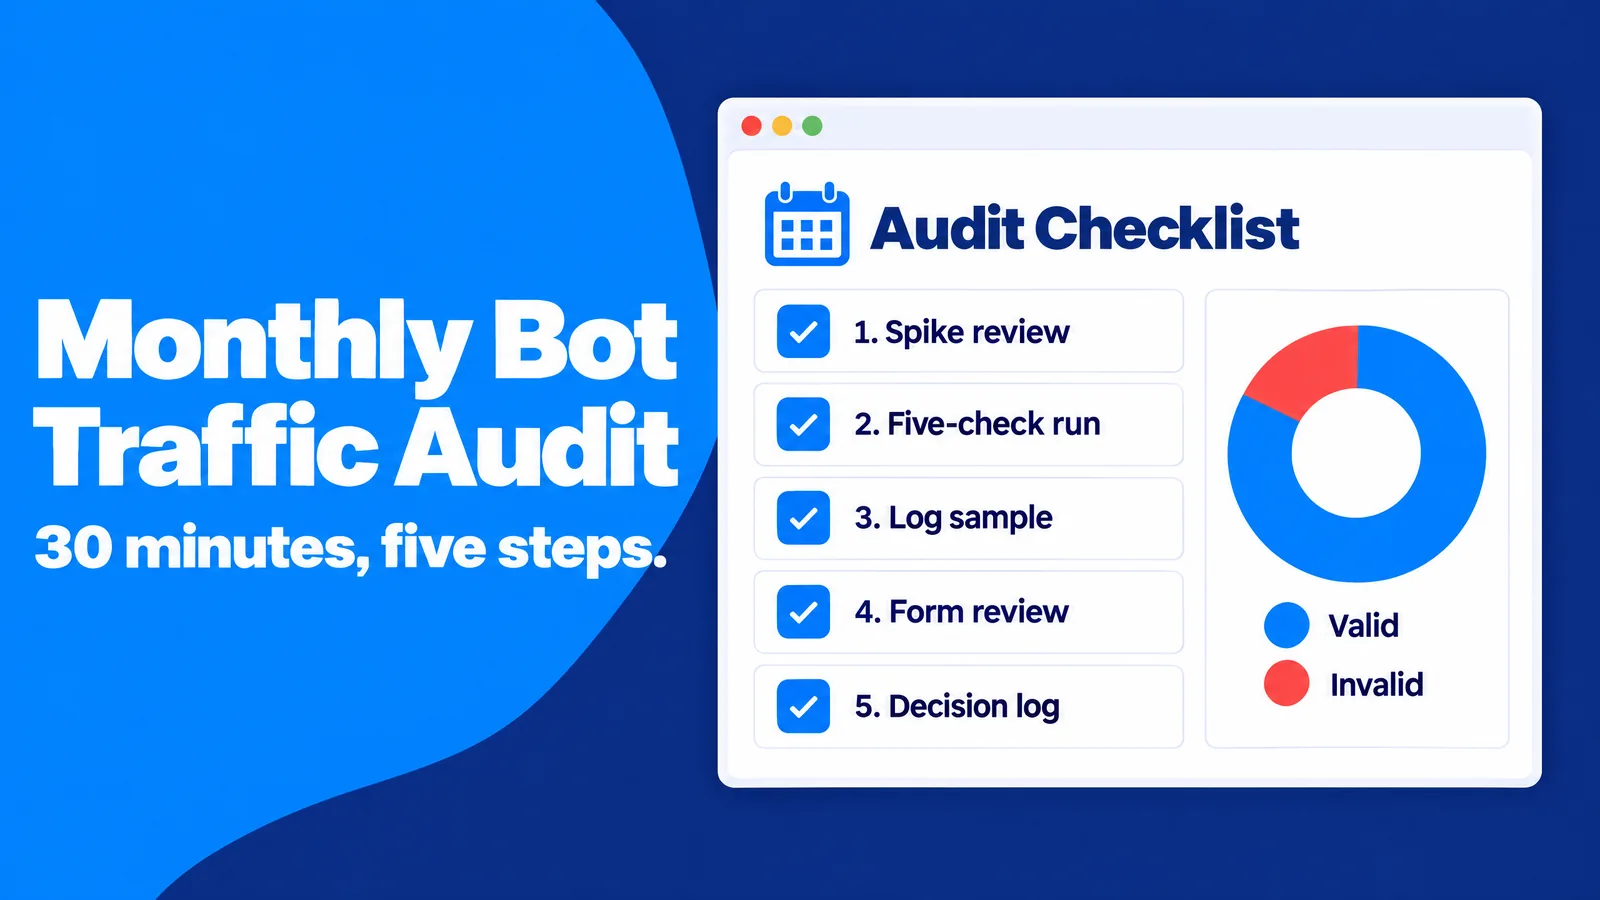
Uma auditoria recorrente funciona melhor quando segue os mesmos passos todas as vezes, para que as tendências se tornem visíveis:
- Revisão de picos: cada pico de tráfego do último mês anotado com sua causa ou marcado como inexplicado.
- Execução das cinco verificações: cada fonte e campanha principal pontuada pelas cinco verificações.
- Amostra de logs: os principais crawlers declarados verificados com DNS reverso confirmado por encaminhamento.
- Revisão de formulários: cadastros e leads verificados em busca de nomes idênticos, domínios de e-mail descartáveis ou rajadas repentinas.
- Registro de decisões: um registro do que você filtrou, bloqueou ou reportou e por quê.
Essa rotina funciona porque transforma a detecção de bots em um hábito com uma trilha documental. Quando uma parte interessada pergunta por que os números de março mudaram, você tem a resposta.
Crie uma Política de Tráfego Inválido de Uma Página
Até especialistas têm dificuldade para definir precisamente o tráfego inválido. O Relatório Tuzhilin, uma revisão independente da detecção de fraude de cliques do Google, descrita no artigo da Wikipédia sobre fraude de cliques, concluiu que "não há uma definição conceitual de cliques inválidos que possa ser operacionalizada" exceto em casos óbvios. Se o setor não consegue concordar com uma definição, sua equipe se beneficia de ter a própria.
Etapa prática: Uma política de uma página resolve a maioria das discussões antecipadamente. Ela define quais visitantes automatizados você permite, quais limites acionam uma revisão, quem decide e como as descobertas são reportadas a agências e fornecedores. Isso funciona porque uma regra escrita substitui debates caso a caso e dá aos parceiros um padrão claro a cumprir.
Etapa prática: Uma política de uma página resolve a maioria das discussões antecipadamente. Ela define quais visitantes automatizados você permite, quais limites acionam uma revisão, quem decide e como as descobertas são reportadas a agências e fornecedores. Isso funciona porque uma regra escrita substitui debates caso a caso e dá aos parceiros um padrão claro a cumprir.
Acompanhe as Métricas que Bots Não Conseguem Falsificar Baratamente
Visualizações de página e sessões são baratas de falsificar. Receita, leads qualificados, compras repetidas, tickets de suporte e usuários conectados que retornam são caros ou impossíveis de falsificar em escala. Uma fonte de tráfego que adiciona sessões, mas nunca altera esses números, merece análise, por melhor que seu engajamento pareça.
Basear seus relatórios nessas métricas de resultado é a defesa de longo prazo mais forte. Isso alinha cada decisão de tráfego ao que as pessoas realmente fazem e remove o incentivo para que qualquer pessoa na sua cadeia de fornecimento infle os números.
Basear seus relatórios nessas métricas de resultado é a defesa de longo prazo mais forte. Isso alinha cada decisão de tráfego ao que as pessoas realmente fazem e remove o incentivo para que qualquer pessoa na sua cadeia de fornecimento infle os números.
Perguntas Frequentes sobre Bots de Tráfego
O que é um bot de tráfego em termos simples?
Um bot de tráfego é um software que visita sites ou clica em anúncios automaticamente para fazer a atividade parecer vir de pessoas reais. Ele geralmente infla métricas como visualizações de página, cliques, visualizações de vídeo ou seguidores.
Todo tráfego de bots é ruim?
Não. Crawlers de mecanismos de busca, monitores de disponibilidade e muitos crawlers de IA são úteis. O tráfego de bots se torna um problema quando finge ser humano, desperdiça verba de anúncios, raspa conteúdo contra suas regras ou distorce suas análises.
O tráfego de bots pode prejudicar meu SEO?
Visitas falsas não melhoram rankings, pois mecanismos de busca se baseiam em muitos sinais de qualidade, e não em contagens brutas de visitas. O tráfego de bots ainda pode prejudicar indiretamente ao deixar seu servidor lento, copiar seu conteúdo e levar você a otimizar as páginas erradas com base em dados contaminados.
O Google Analytics 4 filtra tráfego de bots automaticamente?
Sim. O GA4 exclui bots e spiders conhecidos automaticamente, e você não pode desativar isso nem ver quanto foi removido. Bots desconhecidos e sofisticados ainda podem chegar aos seus relatórios, portanto comparações de segmentos e as cinco verificações continuam necessárias.
Quanto tráfego de bots é normal?
Não existe um número universal. Mais da metade de todo o tráfego da web é automatizado, mas a maior parte dele nunca executa seu código de análise. Uma referência prática é seu próprio canal de referência confiável: fontes que se desviam muito dele merecem uma análise mais atenta.
Como interrompo o tráfego de bots no meu site?
A abordagem mais eficaz é gradual. Crawlers verificados são permitidos, crawlers agressivos têm a taxa limitada, tráfego não verificado é desafiado apenas em logins e formulários, e infratores comprovados são bloqueados. Campos honeypot, validação no servidor e filtros de hostname e tráfego interno do GA4 mantêm seus formulários e relatórios limpos.
Como saber se o tráfego do meu site vem de bots?
A maneira mais rápida é comparar uma fonte suspeita com um canal em que você confia em cinco dimensões: duração da sessão, resoluções de tela, hora do dia, localização e interação. Duas ou mais falhas claras, como durações de sessão idênticas e volume noturno igual ao volume diurno, sugerem fortemente tráfego automatizado. Os logs do servidor e o DNS reverso confirmado por encaminhamento confirmam depois se crawlers autodeclarados são genuínos.
É legal comprar tráfego de bots?
As regras variam de país para país, mas comprar engajamento falso para uso comercial traz riscos legais e empresariais reais. Nos Estados Unidos, a regra de 2024 da FTC proíbe comprar ou vender indicadores falsos de influência em redes sociais, como seguidores ou visualizações gerados por bots, para fins comerciais. Redes de publicidade também proíbem tráfego falso nas suas políticas.
Conclusão: Meça Pessoas, Não Contadores
Bots de tráfego existem porque atividade falsa é barata de produzir e fácil de vender. Sua defesa é ter uma imagem clara de como são as pessoas reais no seu site. As cinco verificações, uma referência confiável, a verificação no nível do servidor e uma auditoria mensal fornecem essa imagem sem ferramentas caras.
A web antiga recompensava números grandes. A web atual recompensa confiança: mecanismos de busca, anunciantes, sistemas de IA e clientes respondem a engajamento genuíno. Quando você protege seus dados de bots, protege cada decisão que depende deles e mantém a atenção no público que compra, assina e volta: pessoas reais.
A web antiga recompensava números grandes. A web atual recompensa confiança: mecanismos de busca, anunciantes, sistemas de IA e clientes respondem a engajamento genuíno. Quando você protege seus dados de bots, protege cada decisão que depende deles e mantém a atenção no público que compra, assina e volta: pessoas reais.