Mehr als die Hälfte des gesamten Web-Traffics wird laut Wikipedia-Überblick über Internet-Bots von Bots erzeugt. Ein Teil dieser Automatisierung hält das Web am Laufen. Suchmaschinen-Crawler indexieren Ihre Seiten und Uptime-Monitore bestätigen, dass Ihr Checkout um 3 Uhr morgens noch lädt.
Ein wachsender Anteil des automatisierten Traffics tut jedoch etwas anderes. Er imitiert Menschen, bläht Ihre Kennzahlen auf und zehrt Werbebudgets auf, die für echte Kunden gedacht waren. Juniper Research schätzte, dass Werbebetrug Werbetreibende 2023 88 Milliarden US-Dollar kostete, und ein großer Teil dieses Betrugs läuft über automatisierte Besuche und Klicks.
Für Sie als Marketer sind die größeren Kosten oft unsichtbar. Budgets, Content-Pläne und Entscheidungen zu Landingpages können auf Besuchen beruhen, die nie von einem Menschen kamen.
Dieser Leitfaden erklärt, was ein Traffic-Bot ist, warum Bot-Traffic existiert und wie Sie ihn in Ihren Analysedaten und Serverprotokollen erkennen. Wir gehen von Definitionen zu einer praktischen Routine zur Erkennung und anschließend zu fortgeschrittenen Prüfgewohnheiten über. Ein Grundsatz zieht sich durch den gesamten Artikel: Suchmaschinen und KI-Systeme lesen Ihre Seiten, aber die Zielgruppe, die zählt, besteht immer aus echten Menschen.
Was ist ein Traffic-Bot?
Der Begriff "Traffic-Bot" wird unscharf verwendet, und das sorgt schon vor jeder Analyse für Verwirrung. Ein Entwickler kann damit ein Skript für Lasttests meinen. Ein Verkäufer auf einem Freelancer-Marktplatz kann damit Software bezeichnen, die "10.000 Besucher pro Tag" verspricht. Ein Sicherheitsteam kann damit alles meinen, was keine Person ist. Wenn drei Personen in einem Meeting drei verschiedene Dinge meinen, diskutiert das Team über Begriffe, statt das Problem zu lösen.
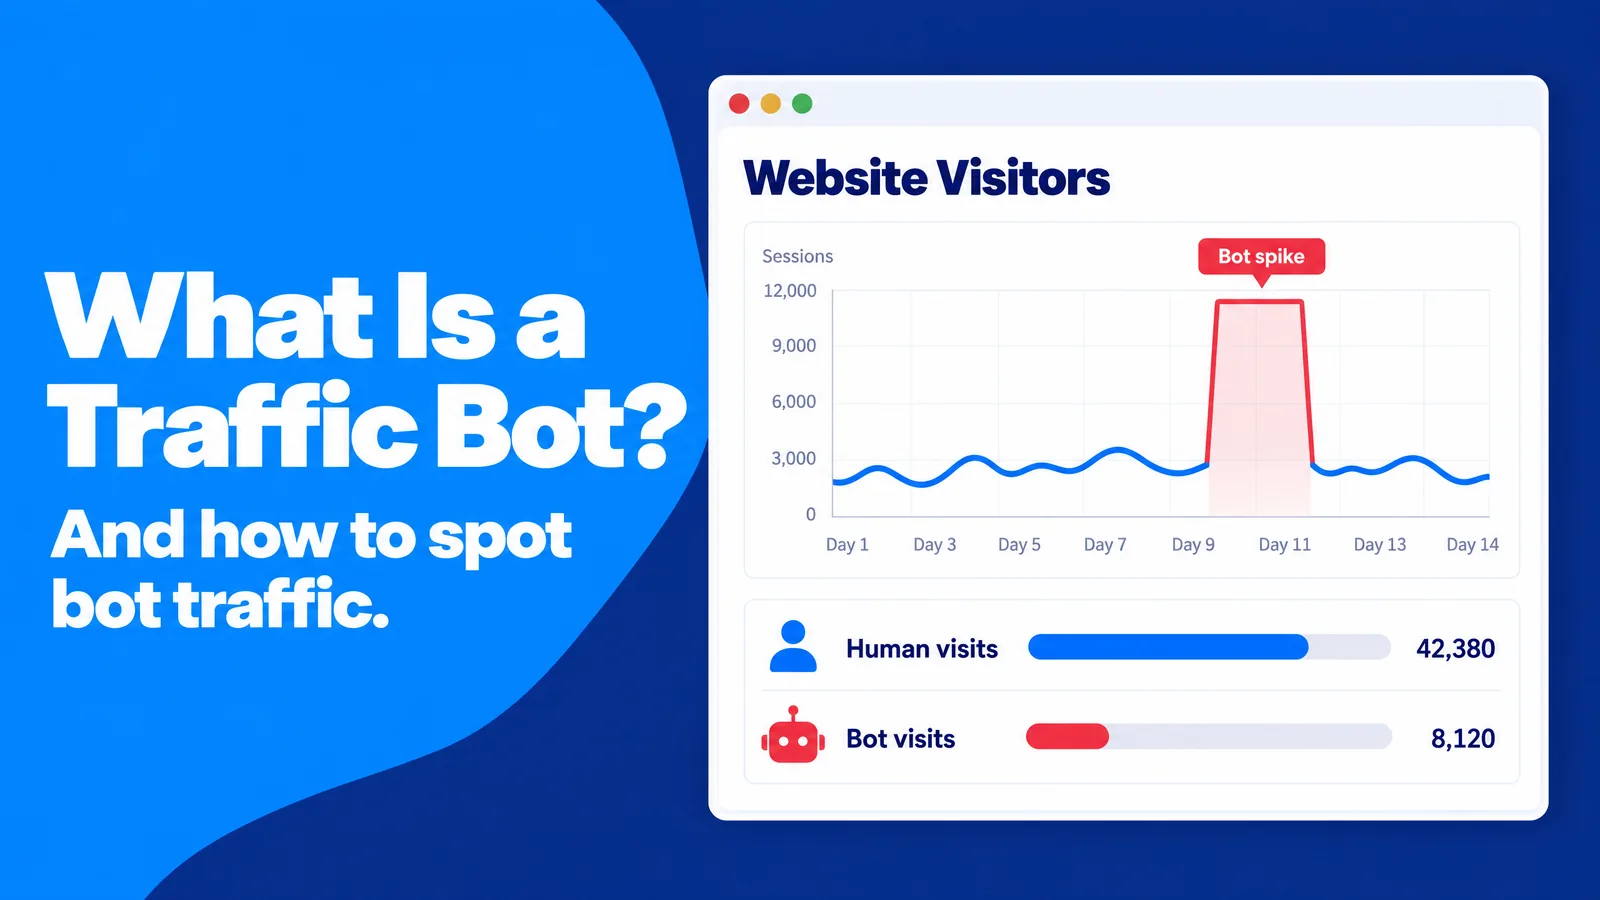
In diesem Leitfaden ist ein Traffic-Bot ein Softwareprogramm, das automatisierte Besuche auf eine Website, App oder Anzeige sendet, damit die Aktivität wie die von Menschen aussieht. Sein Zweck ist meist, eine Kennzahl wie Seitenaufrufe, Anzeigenimpressionen, Klicks, Videoaufrufe oder Follower aufzublähen. Ein Traffic-Bot ist eine Art Internet-Bot, also eine Softwareanwendung, die automatisierte Aufgaben über das Internet ausführt.
In diesem Leitfaden ist ein Traffic-Bot ein Softwareprogramm, das automatisierte Besuche auf eine Website, App oder Anzeige sendet, damit die Aktivität wie die von Menschen aussieht. Sein Zweck ist meist, eine Kennzahl wie Seitenaufrufe, Anzeigenimpressionen, Klicks, Videoaufrufe oder Follower aufzublähen. Ein Traffic-Bot ist eine Art Internet-Bot, also eine Softwareanwendung, die automatisierte Aufgaben über das Internet ausführt.
Traffic-Bot vs. Bot-Traffic
Bot-Traffic ist die umfassendere Kategorie. Er umfasst jeden Besuch oder jede Anfrage, die ein Programm statt einer Person ausführt, unabhängig von der Absicht. Wenn Googlebot Ihren Blog crawlt, ist das Bot-Traffic. Dennoch würde niemand Googlebot einen Traffic-Bot nennen, weil er sich zu erkennen gibt, Ihre Crawling-Regeln befolgt und nicht vorgibt, ein Käufer zu sein.
Dieser Unterschied bestimmt Ihre Reaktion. Bot-Traffic von einem deklarierten Crawler muss verwaltet werden: Sie entscheiden, worauf er zugreifen darf. Besuche von einem Traffic-Bot müssen erkannt und ausgeschlossen werden, denn genau darum geht es bei einem Traffic-Bot: Er soll sich unter Ihre menschlichen Besucher mischen.
Dieser Unterschied bestimmt Ihre Reaktion. Bot-Traffic von einem deklarierten Crawler muss verwaltet werden: Sie entscheiden, worauf er zugreifen darf. Besuche von einem Traffic-Bot müssen erkannt und ausgeschlossen werden, denn genau darum geht es bei einem Traffic-Bot: Er soll sich unter Ihre menschlichen Besucher mischen.
Gute Bots, schlechte Bots und die Grauzone
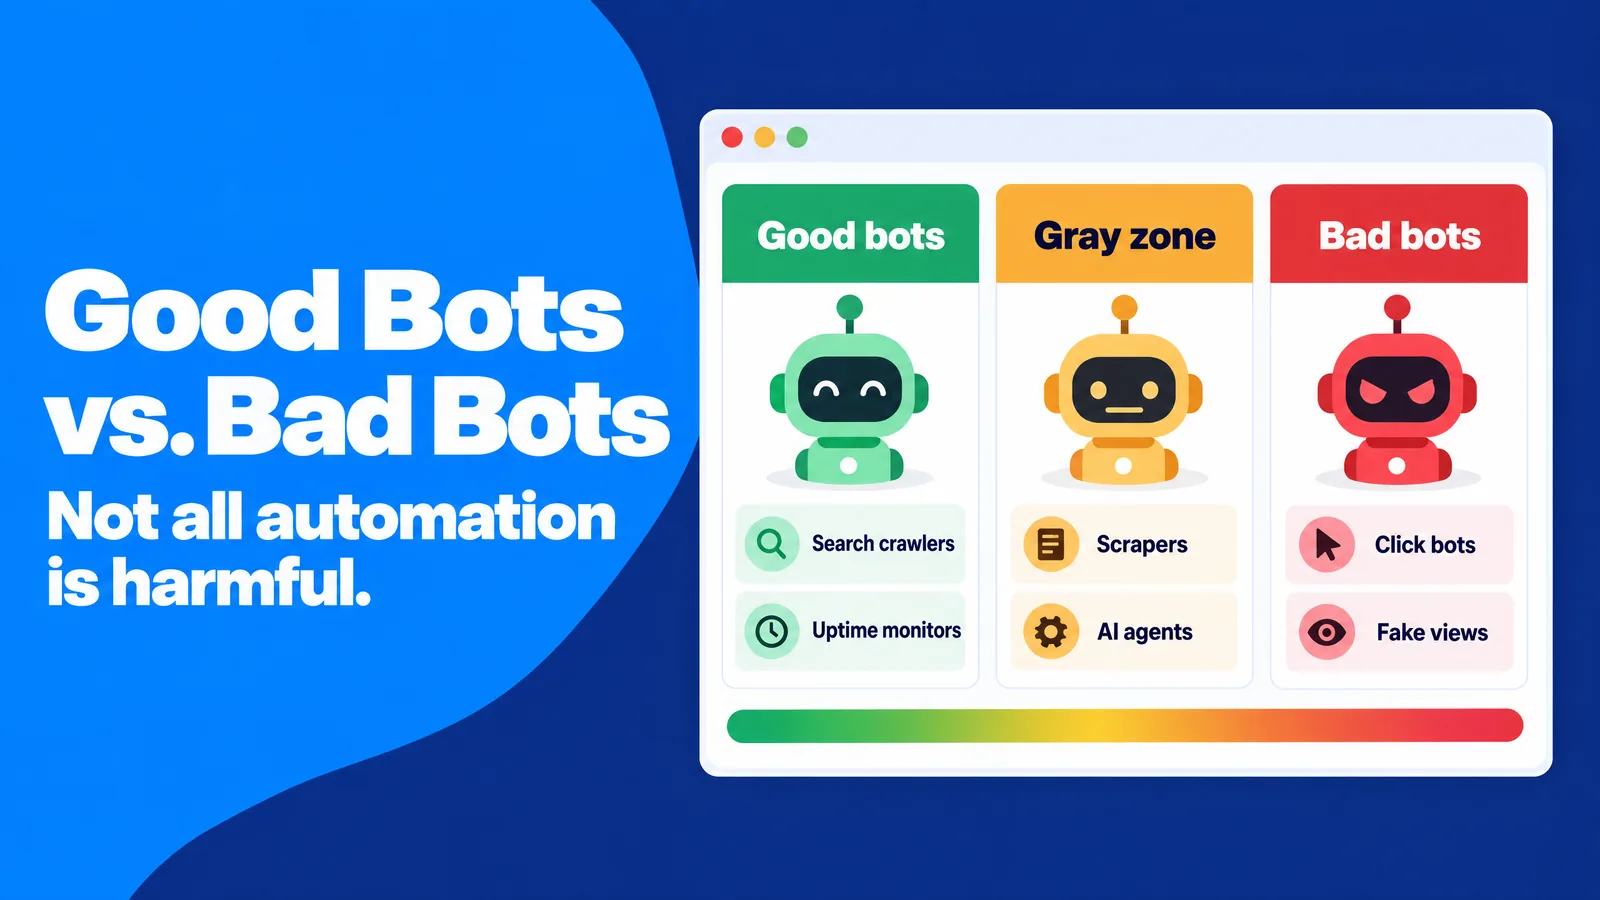
Die Werbebranche verfügt dafür über einen hilfreichen Wortschatz. Der Media Rating Council (MRC), die US-Organisation zur Akkreditierung von Werbemessungen, teilt ungültigen Traffic in seinen Standards für ungültigen Traffic in zwei Gruppen ein:
- Allgemeiner ungültiger Traffic (GIVT): bekannte Crawler, Rechenzentrum-Traffic und andere Automatisierungen, die listenbasierte Filter erfassen können.
- Ausgefeilter ungültiger Traffic (SIVT): Bots, die menschliches Verhalten imitieren, kompromittierte Geräte, Malware und vergütete Aktivitäten, die für ihre Identifizierung eine tiefere Analyse erfordern.
Zwischen dem eindeutig Guten und dem eindeutig Schlechten liegt eine Grauzone. Scraper zur Preisüberwachung, Crawler von SEO-Tools, Crawler für KI-Training und KI-Agenten, die im Auftrag einer Person browsen, sind alle automatisiert. Ob sie willkommen sind, hängt von Ihrem Geschäftsmodell ab, nicht von einer universellen Regel.
Häufige Arten von Traffic-Bots
Traffic-Bots treten in einigen gut erkennbaren Kategorien auf. Wenn Sie sie kennen, können Sie anhand des hinterlassenen Musters besser einschätzen, welchem Typ Sie begegnen:
- Klick-Bots klicken auf Anzeigen oder Suchergebnisse, um das Budget eines Wettbewerbers aufzubrauchen oder Engagement zu fälschen. Diese Praxis wird als Klickbetrug bezeichnet.
- Impressions-Bots laden Anzeigen auf gefälschten oder getarnten Seiten, damit Werbetreibende für Aufrufe zahlen, die niemand gesehen hat.
- Autosurf- und Besuchertausch-Programme wechseln Seiten zwischen Mitgliedern ab, sodass jede Website "Besuche" verzeichnet, die niemand liest.
- Referrer-Spam-Bots platzieren eine URL in Ihren Verweisberichten, um Sie zum Besuch zu verleiten. Diese Taktik heißt Referrer-Spam.
- Headless-Browser sind vollwertige Browser ohne Bildschirm. Entwickler verwenden sie für Tests, und Betrüger haben sie missbraucht, um Anzeigenimpressionen aufzublähen.
- Klickfarmen setzen niedrig bezahlte Menschen statt Code ein. Die Besucher sind technisch gesehen Menschen, doch die Absicht ist gefälscht. Deshalb behandeln Messstandards diese Aktivität als ungültig.
Praktischer Schritt: Ein hilfreicher erster Schritt ist eine einseitige Übersicht über die Automatisierungen, die Sie zulassen. Darin listen Sie Ihre Such-Crawler, Uptime-Monitore, SEO-Crawler, Zahlungs-Webhooks und die KI-Assistenten auf, von denen Sie Zitate erhalten möchten, jeweils mit dem user agent, den sie angeben. Das funktioniert, weil viele Fehlalarme von Ihren eigenen Tools stammen: Ein für 3 Uhr morgens geplanter SEO-Crawl sieht genauso aus wie eine verdächtige nächtliche Spitze, bis Sie die Übersicht prüfen.
Warum echte Besucher erkennbare Spuren hinterlassen
Die meisten Ratschläge zu Bot-Traffic beginnen mit dem, was falsch aussieht. Zuverlässiger ist es, damit zu beginnen, wie normal aussieht, denn ohne Vergleichswert können Sie keine Anomalie beurteilen.
Menschliche Besucher sind wunderbar uneinheitlich. Eine Person liest Ihre Preisseite unterwegs 40 Sekunden lang auf dem Smartphone. Eine andere lässt einen Desktop-Tab 12 Minuten offen, und eine dritte verlässt die Seite nach zwei Sekunden, weil sie auf das falsche Ergebnis getippt hat.
Diese Unordnung ist Ihr stärkstes Signal. Jeder menschliche Besuch bringt Dutzende kleiner Unterschiede mit: Bildschirmgröße, Browserversion, Zeitzone, Scrollgeschwindigkeit und die Pause vor einem Klick. Automatisierter Traffic kann diese vollständige Vielfalt nur schwer im großen Maßstab kopieren, denn jede neue Variation kostet dem Bot-Betreiber Entwicklungszeit und Infrastruktur. Ein Bot-Netzwerk kann ein oder zwei Dimensionen überzeugend fälschen, doch alle gleichzeitig für Tausende von Sitzungen zu fälschen, ist teuer.
SparkTraffic, eine Werbeplattform, die seit 2015 über Anzeigen auf Partner-Publisher-Websites geografisch zielgerichtete Website-Besuche liefert, baut auf diesem Prinzip der Vielfalt auf. Dafür veröffentlicht die Plattform für ihre eigenen Werbetreibenden einen Test mit fünf Prüfungen. Die Überlegung ist einfach: Wer für Besuche bezahlt, sollte mit Standardanalysen und ohne Spezialtools bestätigen können, dass sich diese Besuche wie Menschen verhalten. Dieselben Prüfungen funktionieren für jede Quelle, bezahlt oder organisch, und sind daher eine gute allgemeine Grundlage für Ihre eigenen Berichte.
Der Fünf-Prüfungen-Test für menschliche Spuren
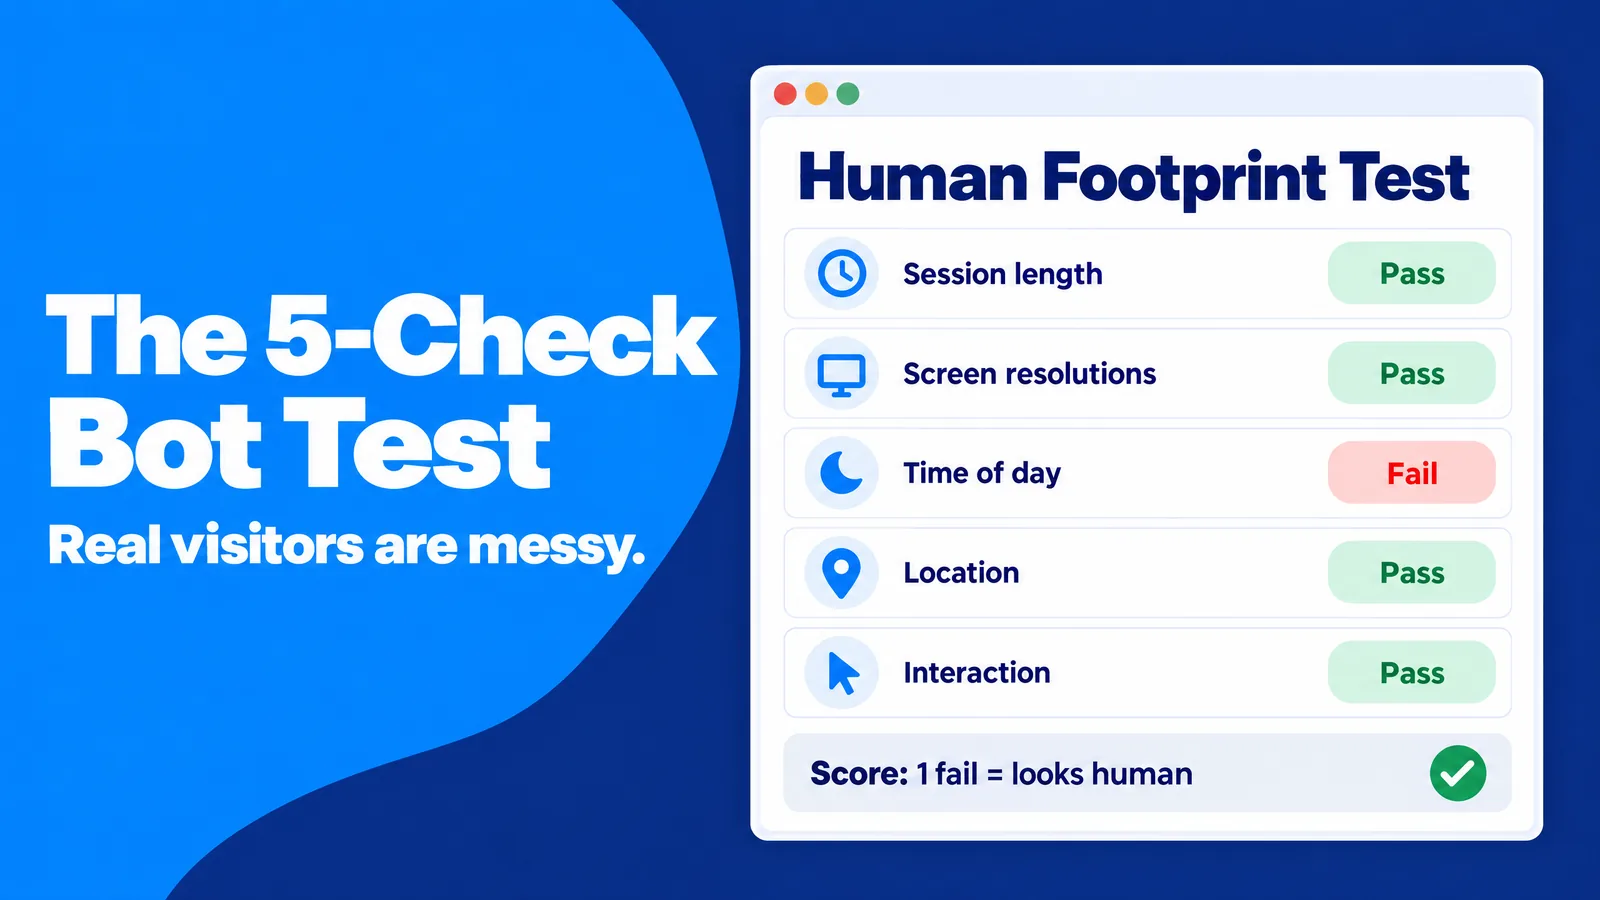
Jede Prüfung vergleicht eine Verhaltensdimension mit der Vielfalt, die Sie von echten Menschen erwarten würden. Die Schwellenwerte sind bewusst großzügig, damit kleine Stichproben und normale Schwankungen keine Fehlalarme auslösen:
- Sitzungsdauer: Gesunder Traffic verteilt sich von unter 10 Sekunden bis über zwei Minuten. Ein Warnsignal liegt vor, wenn mehr als die Hälfte der Sitzungen in derselben Fünf-Sekunden-Spanne landet.
- Bildschirmauflösungen: Gesunder Traffic zeigt viele verschiedene Auflösungen. Ein Warnsignal liegt vor, wenn eine Auflösung mehr als die Hälfte der Sitzungen ausmacht.
- Tageszeit: Gesunder Traffic folgt lokalen Mustern für die Tageszeit. Ein Warnsignal liegt vor, wenn das lokale Volumen von 1 bis 5 Uhr morgens dem Tagesniveau entspricht.
- Standort: Gesunder, zielgerichteter Traffic liefert mehr als 90 % der Besuche aus dem Zielgebiet. Ein Warnsignal liegt vor, wenn mehr als 10 % aus Orten kommen, die Sie nicht angesprochen haben.
- Interaktion: Gesunder Traffic umfasst einige Scrolls, Klicks oder Formularstarts. Ein Warnsignal sind null Interaktionen über 300 Sitzungen hinweg.
Null oder eine fehlgeschlagene Prüfung deutet darauf hin, dass sich der Traffic wie Menschen verhält. Zwei oder mehr Fehlschläge sind ein Grund, die Quelle zu pausieren, etwa 20 Sitzungen als Beleg zu exportieren und den Anbieter um eine Prüfung zu bitten. Diese Bewertung funktioniert, weil eine einzelne auffällige Kennzahl oft eine harmlose Ursache hat, etwa eine reine Mobilkampagne, die die Bildschirmgrößen einengt. Mehrere Fehlschläge zugleich haben das dagegen selten.
Erstellen Sie Ihren eigenen Vergleichswert für Menschen
Allgemeine Schwellenwerte sind ein Ausgangspunkt, kein Urteil. Ein Rezeptblog, eine SaaS-Dokumentationswebsite und eine lokale Zahnarztpraxis haben alle unterschiedliche Sitzungsdauern und Tagesrhythmen. Eine durchschnittliche Sitzung von fünf Minuten kann auf einer Filialsuchseite verdächtig und bei einem langen Tutorial vollkommen normal sein.
Praktischer Schritt: Der zuverlässigste Vergleichswert ist ein Kanal, dem Sie bereits vertrauen, etwa Newsletter-Klicks oder eingeloggte Kunden. Wenn Sie seine Verteilung über 30 Tage für die fünf genannten Dimensionen erfassen, erhalten Sie eine Grundlage. Jede neue Quelle, die auffällig aussieht, können Sie dann mit ihr statt mit einem Branchendurchschnitt vergleichen. Das funktioniert, weil Ihr vertrauenswürdiger Kanal bereits Ihre Zielgruppe, Ihre Geräte und Ihre Zeitzonen widerspiegelt. Eine große Abweichung weist daher eher auf die Quelle als auf Ihre Website hin.
Praktischer Schritt: Der zuverlässigste Vergleichswert ist ein Kanal, dem Sie bereits vertrauen, etwa Newsletter-Klicks oder eingeloggte Kunden. Wenn Sie seine Verteilung über 30 Tage für die fünf genannten Dimensionen erfassen, erhalten Sie eine Grundlage. Jede neue Quelle, die auffällig aussieht, können Sie dann mit ihr statt mit einem Branchendurchschnitt vergleichen. Das funktioniert, weil Ihr vertrauenswürdiger Kanal bereits Ihre Zielgruppe, Ihre Geräte und Ihre Zeitzonen widerspiegelt. Eine große Abweichung weist daher eher auf die Quelle als auf Ihre Website hin.
Warum Traffic-Bots existieren und was sie Sie kosten
Traffic-Bots existieren, weil jemand von gefälschter Aktivität profitiert. Der Gewinn kann direkt sein, etwa durch Werbebetrug, oder indirekt, etwa durch einen Anbieter, der "Traffic" verkauft, damit ein Dashboard belebt aussieht. Wenn Sie das Motiv verstehen, können Sie das Muster besser vorhersagen: Ein Betrüger will Impressionen und Klicks, ein Verkäufer von Eitelkeitskennzahlen will Seitenaufrufe, und ein Spammer will Ihre Aufmerksamkeit.
Werbebetrug im industriellen Maßstab
Das am besten dokumentierte Beispiel ist Methbot. Laut dem US-Justizministerium nutzte die Operation mehr als 1.900 Server und mehr als 650.000 IP-Adressen, um Anzeigen auf über 5.000 gefälschten Websites zu laden, und nahm mehr als 7 Millionen US-Dollar ein. Ein verwandtes System, 3ve, lief auf etwa 1,7 Millionen infizierten Computern und erbeutete mehr als 29 Millionen US-Dollar.
Die Bots wurden so gebaut, dass sie menschlich wirken. Die Mitteilung zur Verurteilung des DOJ beschreibt Bots, die Mausbewegungen, Scrollen und Anmeldungen bei sozialen Netzwerken fälschten, und der Hauptverantwortliche erhielt eine zehnjährige Haftstrafe. Die Lehre für Marketer lautet: "Realistisch wirkendes Engagement" allein beweist nichts, weil Methbot genau dafür entwickelt wurde.
Die Bots wurden so gebaut, dass sie menschlich wirken. Die Mitteilung zur Verurteilung des DOJ beschreibt Bots, die Mausbewegungen, Scrollen und Anmeldungen bei sozialen Netzwerken fälschten, und der Hauptverantwortliche erhielt eine zehnjährige Haftstrafe. Die Lehre für Marketer lautet: "Realistisch wirkendes Engagement" allein beweist nichts, weil Methbot genau dafür entwickelt wurde.
Gefälschte Popularität und Eitelkeitskennzahlen
Ein zweites Motiv ist der Anschein von Popularität. Manche Anbieter verkaufen Traffic-Bot-Software oder "Besucherpakete", die Seitenaufrufe, Videoaufrufe oder Follower-Zahlen aufblähen. Im frühen Web beeindruckten rohe Hit-Zähler die Menschen, und aufgeblähte Zahlen brachten kurzfristig etwas. Heute achten Suchmaschinen, Werbetreibende und Investoren auf Engagement, Conversions und Umsatz. Gefälschtes Volumen bringt also nichts und verunreinigt die Daten, die Sie benötigen.
Aufsichtsbehörden behandeln gefälschte Popularität inzwischen als Täuschung. Im August 2024 erließ die US Federal Trade Commission eine Regel, die den Verkauf oder Kauf gefälschter Indikatoren für sozialen Medieneinfluss verbietet, etwa durch Bots erzeugte Follower oder Aufrufe. Das Verbot gilt, wenn der Käufer wusste oder hätte wissen müssen, dass die Indikatoren gefälscht waren, und sie zu einem geschäftlichen Zweck nutzte. Auch die Werberichtlinien von Google untersagen die Bewerbung von Diensten, die gefälschte Nutzeraktivität wie ungültige Klicks verkaufen.
Aufsichtsbehörden behandeln gefälschte Popularität inzwischen als Täuschung. Im August 2024 erließ die US Federal Trade Commission eine Regel, die den Verkauf oder Kauf gefälschter Indikatoren für sozialen Medieneinfluss verbietet, etwa durch Bots erzeugte Follower oder Aufrufe. Das Verbot gilt, wenn der Käufer wusste oder hätte wissen müssen, dass die Indikatoren gefälscht waren, und sie zu einem geschäftlichen Zweck nutzte. Auch die Werberichtlinien von Google untersagen die Bewerbung von Diensten, die gefälschte Nutzeraktivität wie ungültige Klicks verkaufen.
Referrer-Spam und Ghost-Traffic
Ein drittes Motiv ist Aufmerksamkeit. Referrer-Spam-Bots besuchen Ihre Website oder senden Daten mit einer gefälschten verweisenden URL direkt an Ihre Analytics-Property. Wenn Sie in Ihrem Verweisbericht eine unbekannte Domain sehen, erledigt Neugier den Rest, und der Spammer erhält einen Besuch oder einen Verkauf. Der Wikipedia-Artikel über Referrer-Spam beschreibt, wie diese Taktik von Serverprotokollen in Analyse-Tools wanderte.
Die tatsächlichen Kosten: Entscheidungen auf Basis gefälschter Daten
Die direkten Kosten von Bot-Traffic sind verschwendete Werbeausgaben und Serverlast. Die indirekten Kosten sind meist höher. Stellen Sie sich einen A/B-Test vor, bei dem Variante B 600 zusätzliche Bot-Sitzungen ohne Conversions erhält: Die Conversion-Rate von B sinkt, Sie behalten die schwächere Seite, und niemand erfährt jemals warum. Oder stellen Sie sich ein Content-Team vor, das ein Thema weiter ausbaut, weil ein Scraper diese Artikel jede Stunde crawlte.
Praktischer Schritt: Eine Schätzung der Verunreinigungskosten macht das Problem greifbar. Sie multipliziert den Anteil der Sitzungen, die bei zwei oder mehr der fünf Prüfungen durchgefallen sind, mit Ihren Ausgaben für bezahlte Medien im Quartal. Anschließend listet sie jede Entscheidung auf, die auf diesen Berichten beruhte, etwa Budgetverschiebungen, Testsieger und Content-Prioritäten. Das funktioniert, weil aus einem abstrakten Datenqualitätsproblem eine Budgetzahl wird. So lassen sich Zeit und Tools wesentlich leichter genehmigen.
Praktischer Schritt: Eine Schätzung der Verunreinigungskosten macht das Problem greifbar. Sie multipliziert den Anteil der Sitzungen, die bei zwei oder mehr der fünf Prüfungen durchgefallen sind, mit Ihren Ausgaben für bezahlte Medien im Quartal. Anschließend listet sie jede Entscheidung auf, die auf diesen Berichten beruhte, etwa Budgetverschiebungen, Testsieger und Content-Prioritäten. Das funktioniert, weil aus einem abstrakten Datenqualitätsproblem eine Budgetzahl wird. So lassen sich Zeit und Tools wesentlich leichter genehmigen.
So erkennen Sie Bot-Traffic in Google Analytics 4
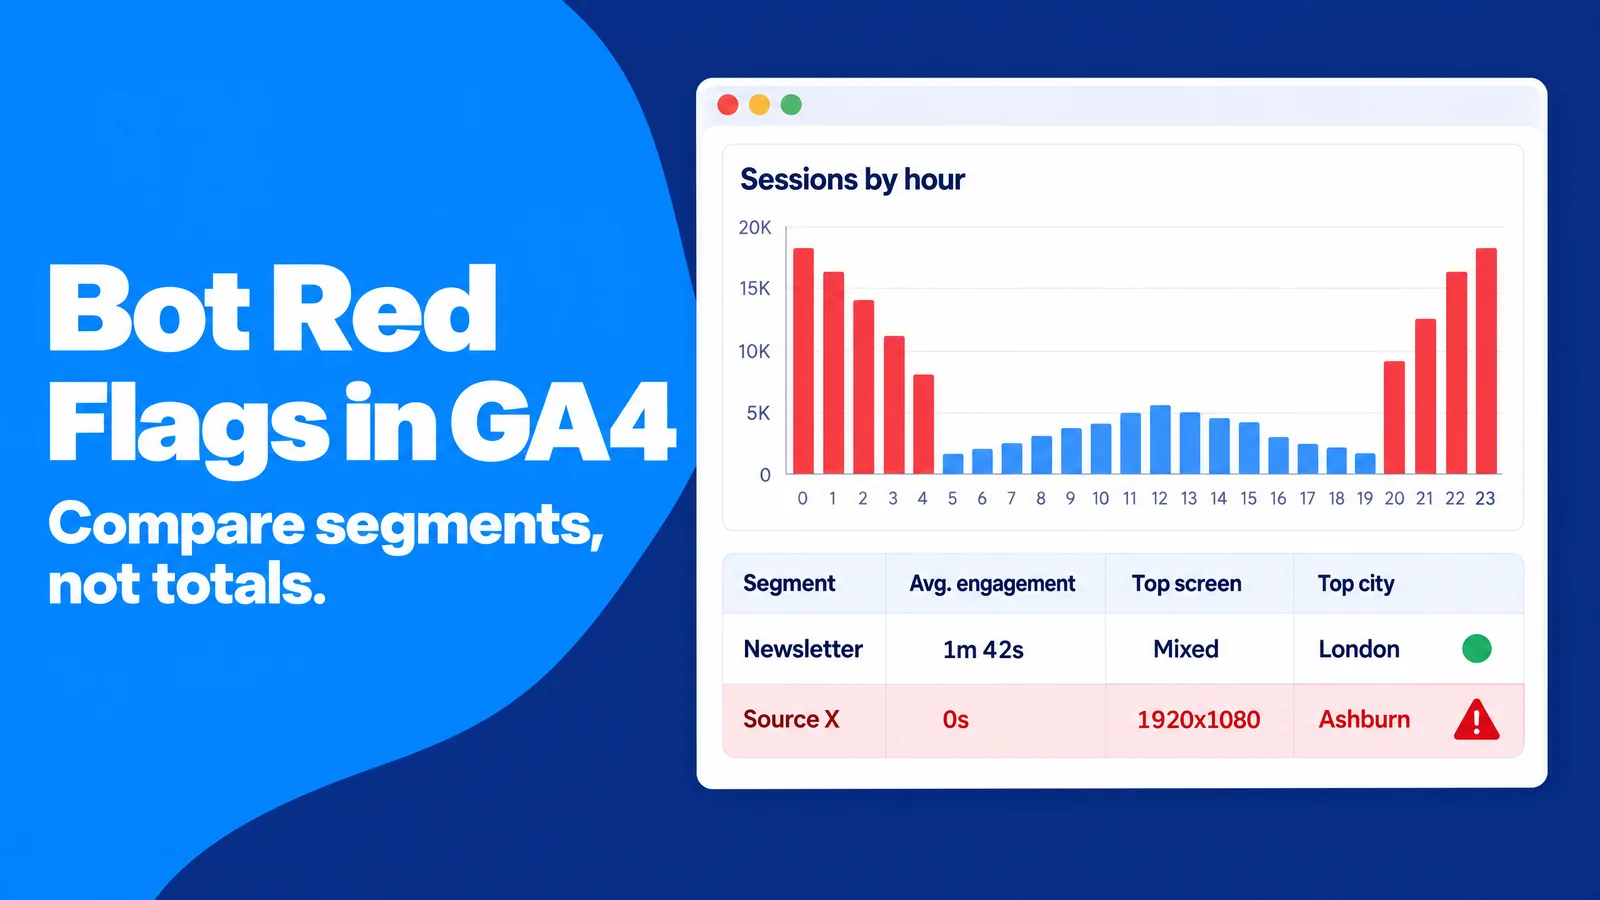
Google Analytics 4 (GA4) schließt bekannte Bots bereits automatisch aus. Dafür nutzt es Googles eigene Forschung und die IAB/ABC International Spiders and Bots List. Sie können dies nicht abschalten und auch nicht sehen, wie viel Traffic entfernt wurde. Das klingt beruhigend, bedeutet aber, dass die in Ihren Berichten verbleibenden Bots per Definition nicht auf einer Liste stehen. Die Erkennung von Bot-Traffic über diese Liste hinaus ist Ihre Aufgabe.
Die gute Nachricht ist, dass unbekannte Bots weiterhin Muster hinterlassen. Sie treffen oft gebündelt ein, verwenden eine begrenzte Auswahl an Geräten, ignorieren Ihre Conversion-Pfade und konzentrieren sich an Orten, an denen Ihre Kunden nicht leben. Sie erkennen Bot-Traffic, indem Sie Segmente vergleichen, nicht indem Sie auf Summen starren.
Die gute Nachricht ist, dass unbekannte Bots weiterhin Muster hinterlassen. Sie treffen oft gebündelt ein, verwenden eine begrenzte Auswahl an Geräten, ignorieren Ihre Conversion-Pfade und konzentrieren sich an Orten, an denen Ihre Kunden nicht leben. Sie erkennen Bot-Traffic, indem Sie Segmente vergleichen, nicht indem Sie auf Summen starren.
Beginnen Sie mit der Form der Spitze
Natürliche Traffic-Spitzen haben eine Ursache und eine Form. Ein Newsletter, ein Social-Media-Beitrag oder eine Presserwähnung erzeugt einen starken Anstieg, gefolgt von einem allmählichen Abfall über Stunden oder Tage. Auch die Conversions steigen mit. Bot-Spitzen sehen oft anders aus: Plateaus mit flacher Oberseite, Starts und Stopps zu vollen Stunden und steigende Sitzungen, während wichtige Ereignisse unverändert bleiben.
Wenn eine Spitze auftaucht, lautet die erste Frage: "Was ist in diesem Moment passiert?" Wenn keine Kampagne, Erwähnung oder saisonale Entwicklung sie erklärt, behandeln Sie die Spitze am besten als nicht bestätigt, bis der unten stehende Segmentvergleich etwas anderes zeigt.
Wenn eine Spitze auftaucht, lautet die erste Frage: "Was ist in diesem Moment passiert?" Wenn keine Kampagne, Erwähnung oder saisonale Entwicklung sie erklärt, behandeln Sie die Spitze am besten als nicht bestätigt, bis der unten stehende Segmentvergleich etwas anderes zeigt.
Acht Warnsignale in Ihren Berichten
Diese Muster sollten Sie prüfen, wenn eine Quelle oder Landingpage ungewöhnlich aussieht:
- Engagement-Zeit nahe null: viele Sitzungen mit fast keiner Engagement-Zeit oder Dauern, die sich auf dieselben wenigen Sekunden konzentrieren.
- Spitzen bei Direct oder Unassigned: plötzliches Wachstum von Direct- oder Unassigned-Traffic auf einer Landingpage, die nirgends offensichtlich verlinkt ist.
- Unbekannte Hostnamen: Aufrufe auf Domains, die nicht Ihnen gehören. Das passiert, wenn jemand Ihre Mess-ID auf eine andere Website kopiert.
- Ein Geräteprofil: eine einzelne Bildschirmauflösung, Browserversion oder ein Betriebssystem dominiert eine Quelle.
- Standorte von Rechenzentren: Cluster in Städten, die für Serverfarmen bekannt sind, etwa Ashburn, Virginia, statt dort, wo Ihre Kunden leben.
- Traffic in der Nachtschicht: lokales Volumen von 1 bis 5 Uhr morgens entspricht dem Tagesvolumen.
- Seltsame Referrer: unbekannte Domains, besonders solche, die SEO- oder Traffic-Dienste bewerben.
- Flache Conversions: Sitzungen steigen, während Anmeldungen, Käufe oder qualifizierte Leads unverändert bleiben, oder Formularübermittlungen voller Unsinn sind.
Erstellen Sie eine Exploration zur Bot-Untersuchung
Der Bereich Explore von GA4 ermöglicht Ihnen, einen wiederverwendbaren Bericht für diese Aufgabe zu erstellen. Eine Freiform-Exploration mit den richtigen Dimensionen beantwortet die meisten Fragen in Minuten, und eine gespeicherte Vorlage sorgt dafür, dass die nächste Untersuchung nicht bei null beginnt:
- Einrichtung: eine Freiform-Exploration mit den Dimensionen Sitzung-Quelle/Medium, Landingpage, Hostname, Bildschirmauflösung, Stadt und Stunde.
- Messwerte: Sitzungen, Interaktionssitzungen, durchschnittliche Engagement-Zeit pro Sitzung und wichtige Ereignisse.
- Segmente: eines für die verdächtige Quelle und eines für Ihren vertrauenswürdigen Vergleichskanal.
- Vergleich: die beiden Segmente nebeneinander, Dimension für Dimension, mit den fünf Prüfungen als Leitfaden.
- Belege: ein Export von etwa 20 verdächtigen Sitzungen mit ihren Attributen, bereit zur Weitergabe an einen Anbieter oder eine Werbeplattform.
Dieser Ansatz funktioniert, weil Bots selten nur in einer einzelnen Dimension versagen. Nebeneinanderliegende Segmente machen das eingeschränkte Geräteprofil, die ungewöhnlichen Stunden und die fehlenden Conversions gleichzeitig sichtbar. Unser Leitfaden zur Nutzung von Analysen zur Verbesserung Ihres Web-Traffics behandelt die wichtigsten GA4-Berichte. Der Leitfaden zur KI-Traffic-Attribution erklärt, wie Sie Direct-Traffic lesen, ohne voreilige Schlüsse zu ziehen.
Setzen Sie GA4-Datenfilter mit Bedacht ein
Datenfilter sind die wichtigste Möglichkeit, Bot-Traffic in GA4 auszuschließen, sobald Sie wissen, woher er kommt. Sie können internen Traffic, Entwickler-Traffic und neuerdings auch Treffer von Hostnamen entfernen, die Ihnen nicht gehören. Ein Hostname-Filter, der nur Ihre eigenen Domains enthält, löst sauber das Problem von Mess-IDs, die auf andere Websites kopiert wurden. Filter sind leistungsstark, aber unerbittlich: Sobald ein Filter aktiv ist, sind die ausgeschlossenen Daten endgültig weg.
Praktischer Schritt: Die sicherste Gewohnheit besteht darin, jeden neuen Filter mindestens eine Woche im Testmodus laufen zu lassen und gefilterte mit ungefilterten Ergebnissen zu vergleichen, bevor Sie ihn aktivieren. So verhindern Sie, dass Sie durch einen Tippfehler in einem Domainnamen oder eine zu weit gefasste Regel echte Kundendaten löschen.
Praktischer Schritt: Die sicherste Gewohnheit besteht darin, jeden neuen Filter mindestens eine Woche im Testmodus laufen zu lassen und gefilterte mit ungefilterten Ergebnissen zu vergleichen, bevor Sie ihn aktivieren. So verhindern Sie, dass Sie durch einen Tippfehler in einem Domainnamen oder eine zu weit gefasste Regel echte Kundendaten löschen.
So überprüfen Sie Bots auf Serverebene
Analyse-Tools sehen nur Besucher, die Ihren Tracking-Code ausführen. Viele Bots führen niemals JavaScript aus. Deshalb erscheinen sie nicht in GA4, verbrauchen aber dennoch Bandbreite, scrapen Inhalte und prüfen Anmeldeformulare. Ihre Serverprotokolle, CDN-Logs oder das Hosting-Dashboard zeigen jede Anfrage und sind daher der Ort, an dem Sie bestätigen können, wer Sie wirklich besucht.
Warum User Agents nichts beweisen
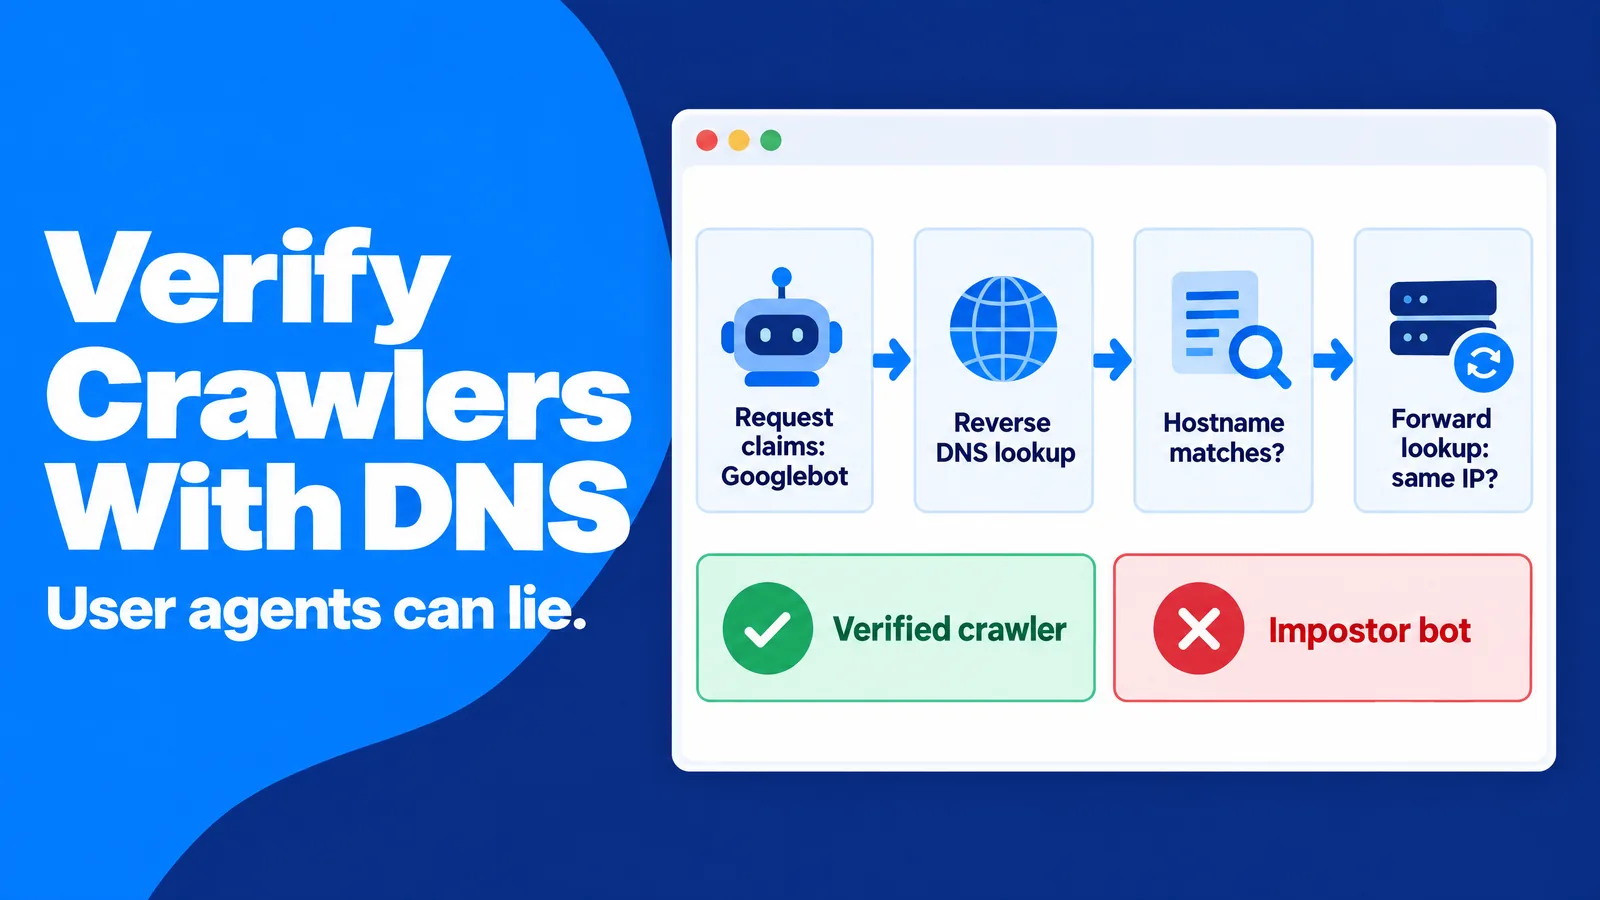
Jede Anfrage enthält einen user agent-String, der den Browser oder Bot benennt. Der Haken ist, dass der Besucher ihn selbst schreibt. Ein Scraper kann mit einer einzigen Codezeile behaupten, Googlebot, Chrome auf einem iPhone oder etwas anderes zu sein. Den user agent als Identität zu behandeln, ist daher wie ein Namensschild als Pass zu akzeptieren.
Crawler mit Forward-confirmed Reverse DNS bestätigen
Die Standardmethode zur Überprüfung eines selbst deklarierten Crawlers ist Forward-confirmed Reverse DNS. Sie besteht aus zwei Abfragen. Eine Reverse-DNS-Abfrage zur IP-Adresse des Besuchers gibt einen Hostnamen zurück, der zur Domain des behaupteten Betreibers gehören muss. Eine Forward-Abfrage für diesen Hostnamen muss dann dieselbe IP-Adresse zurückgeben. Ein gefälschter Googlebot fällt somit durch, weil seine IP-Adresse nicht zurück auf die Domains von Google aufgelöst wird.
Praktischer Schritt: Eine monatliche Protokollstichprobe hält den Aufwand überschaubar. Wenn Sie die 20 user agents mit den meisten Anfragen abrufen und die Prüfung für alle durchführen, die behaupten, eine Suchmaschine oder ein wichtiger KI-Crawler zu sein, dauert das nur wenige Minuten. Das funktioniert, weil sich Betrüger dort konzentrieren, wo der Nutzen am größten ist: Sich als vertrauenswürdiger Crawler auszugeben, ist der einfachste Weg an Ratenlimits und Firewalls vorbei.
Praktischer Schritt: Eine monatliche Protokollstichprobe hält den Aufwand überschaubar. Wenn Sie die 20 user agents mit den meisten Anfragen abrufen und die Prüfung für alle durchführen, die behaupten, eine Suchmaschine oder ein wichtiger KI-Crawler zu sein, dauert das nur wenige Minuten. Das funktioniert, weil sich Betrüger dort konzentrieren, wo der Nutzen am größten ist: Sich als vertrauenswürdiger Crawler auszugeben, ist der einfachste Weg an Ratenlimits und Firewalls vorbei.
Robots.txt ist eine Bitte, kein Schloss
Die Datei robots.txt teilt Crawlern mit, worauf sie zugreifen dürfen, und das Format ist in RFC 9309 standardisiert. Die Einhaltung ist freiwillig. Gut erzogene Crawler respektieren sie, während Traffic-Bots und viele Scraper sie ignorieren oder ihre Namen ändern, um Sperren zu umgehen.
Robots.txt ist dennoch nützlich, weil die Datei Bots, die Ihre Regeln respektieren, von Bots trennt, die das nicht tun. Wikipedia weist darauf hin, dass 306 der 1.000 meistbesuchten Websites OpenAIs GPTBot im Jahr 2023 blockierten. Das zeigt, wie Website-Betreiber die Datei heute als Grundsatzerklärung nutzen. Ein Bot, der Seiten anfragt, die Sie ausgeschlossen haben, verrät Ihnen etwas Wichtiges über seine Absicht.
Robots.txt ist dennoch nützlich, weil die Datei Bots, die Ihre Regeln respektieren, von Bots trennt, die das nicht tun. Wikipedia weist darauf hin, dass 306 der 1.000 meistbesuchten Websites OpenAIs GPTBot im Jahr 2023 blockierten. Das zeigt, wie Website-Betreiber die Datei heute als Grundsatzerklärung nutzen. Ein Bot, der Seiten anfragt, die Sie ausgeschlossen haben, verrät Ihnen etwas Wichtiges über seine Absicht.
Signierte Bot-Identität kommt
Die langfristige Lösung für Identitätsvortäuschung ist eine kryptografische Identität. Die Internet Engineering Task Force (IETF) hat eine Web Bot Auth Working Group eingerichtet, um zu standardisieren, wie Bots ihre Identität beweisen können. Sie baut dabei auf HTTP Message Signatures auf. Ein signierter Bot fügt jeder Anfrage eine überprüfbare Signatur hinzu, sodass eine Website seinen Betreiber bestätigen kann, ohne sich auf IP-Listen zu verlassen. Wenn Sie diese Arbeit jetzt verfolgen, können Sie planen, welche automatisierten Besucher Sie zulassen werden, sobald Signaturen üblich werden.
So stoppen Sie Bot-Traffic, ohne echte Menschen zu blockieren
Bots zu blockieren klingt einfach, bis echte Kunden im Netz hängen bleiben. Aggressive CAPTCHA-Schranken frustrieren Menschen mit langsamen Smartphones und schaffen Barrieren für Nutzer assistiver Technologien. Pauschale Länder- oder Rechenzentrumssperren können Reisende, Nutzer von Unternehmens-VPNs und datenschutzbewusste Besucher ausschließen. Jeder Fehlalarm ist ein verlorener Lead, der in keinem Bericht erscheint.
Ein moderner Ansatz muss auch hilfreiche Automatisierung berücksichtigen. KI-Assistenten rufen zunehmend Seiten ab, vergleichen Produkte und füllen im Auftrag einer Person Formulare aus. Jede nichtmenschliche Anfrage als feindlich zu behandeln, kann Sie von Besuchen abschneiden, die ein echter Kunde angefordert hat.
Ein moderner Ansatz muss auch hilfreiche Automatisierung berücksichtigen. KI-Assistenten rufen zunehmend Seiten ab, vergleichen Produkte und füllen im Auftrag einer Person Formulare aus. Jede nichtmenschliche Anfrage als feindlich zu behandeln, kann Sie von Besuchen abschneiden, die ein echter Kunde angefordert hat.
Passen Sie die Reaktion an den Bot an
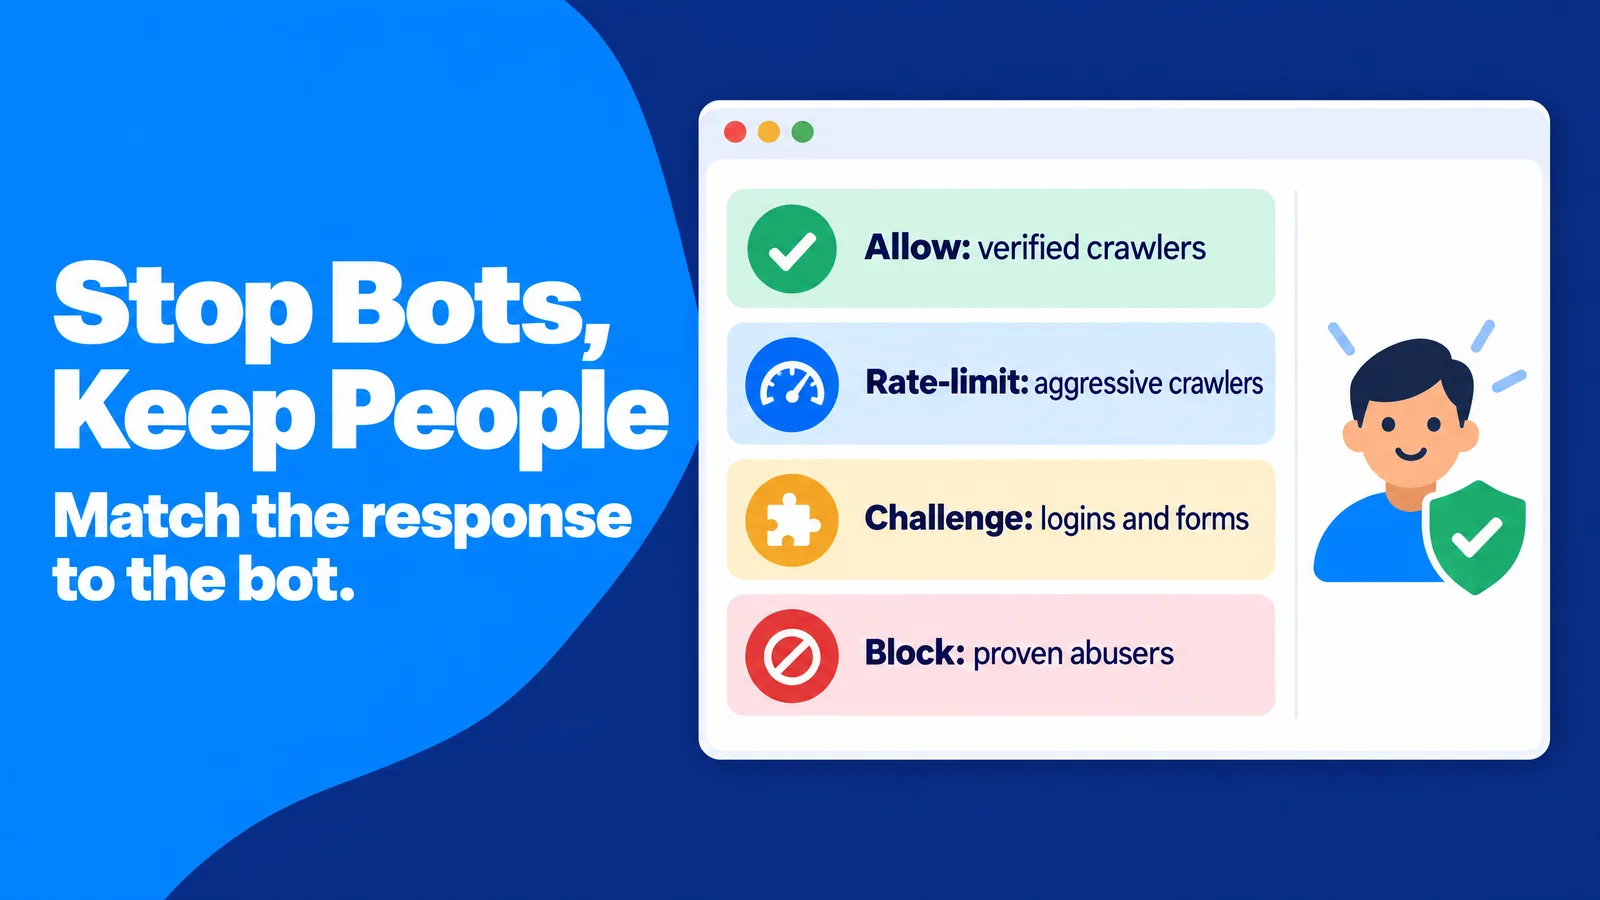
Die wirksamsten Schutzmaßnahmen sind abgestuft statt alles oder nichts. Jede Art automatisierter Besucher erhält die leichteste Reaktion, die das Problem löst:
- Bestätigte Crawler, die Sie wünschen: zugelassen, weil sie Sichtbarkeit in der Suche und KI-Zitate bringen.
- Aggressive, aber legitime Crawler: rate-limitiert, was die Serverleistung schützt, ohne etwas zu beeinträchtigen.
- Nicht bestätigter Traffic auf sensiblen Seiten: nur bei Anmeldungen, Registrierungen und im Checkout mit einem CAPTCHA oder einem ähnlichen Test herausfordern, wo die Missbrauchskosten am höchsten sind.
- Nachgewiesene Missbraucher: nach klarer Beweislage nach IP-Bereich, Netzwerk oder Signatur blockieren.
Diese Abstufung funktioniert, weil sie Reibung dort konzentriert, wo Missbrauch echten Schaden verursacht, und den Rest Ihrer Website für Menschen schnell und offen hält.
Schützen Sie Formulare, Registrierungen und Checkout
Formulare sind der Ort, an dem Bots den nachhaltigsten Schaden anrichten. Gefälschte Registrierungen verunreinigen Ihr CRM, lösen Willkommens-E-Mails an Adressen aus, die zurückgewiesen werden, und schaden Ihrer Sender-Reputation. Gefälschte Leads verschwenden Vertriebszeit und verzerren Berichte zu Kosten pro Lead.
Praktischer Schritt: Eine einfache erste Ebene ist ein Honeypot-Feld: ein Formularfeld, das für Menschen verborgen, für Bots aber sichtbar ist. Jede Übermittlung, die es ausfüllt, kann abgelehnt werden. Serverseitige Validierung, Ratenlimits pro IP-Adresse und Double-Opt-in für E-Mail-Listen ergänzen weitere Ebenen. Diese Einrichtung funktioniert, weil jede Ebene eine andere Art von Bot stoppt, während eine echte Person keine davon bemerkt.
Praktischer Schritt: Eine einfache erste Ebene ist ein Honeypot-Feld: ein Formularfeld, das für Menschen verborgen, für Bots aber sichtbar ist. Jede Übermittlung, die es ausfüllt, kann abgelehnt werden. Serverseitige Validierung, Ratenlimits pro IP-Adresse und Double-Opt-in für E-Mail-Listen ergänzen weitere Ebenen. Diese Einrichtung funktioniert, weil jede Ebene eine andere Art von Bot stoppt, während eine echte Person keine davon bemerkt.
Lassen Sie KI-Agenten, die für Menschen handeln, eine Tür offen
Einige automatisierte Besuche stehen inzwischen für echte Nachfrage. Ein KI-Agent, der Ihre Preise prüft oder für einen Nutzer eine Demo bucht, ist eine von Software ausgeführte Kundeninteraktion. Ihn pauschal zu blockieren, kann Sie einen Verkauf kosten. Ihn ungeprüft durchzulassen, kann dagegen Ihre Engagement-Kennzahlen verzerren.
Der praktische Mittelweg besteht darin, diese Agenten getrennt zu identifizieren, sie auf öffentlichen Seiten zuzulassen und sie in einem eigenen Segment zu messen. Unser Leitfaden zu agentischem KI-Traffic erklärt, wie von Agenten unterstützte Besuche in Analysen erscheinen und wie Sie Ihre Seiten darauf vorbereiten.
Der praktische Mittelweg besteht darin, diese Agenten getrennt zu identifizieren, sie auf öffentlichen Seiten zuzulassen und sie in einem eigenen Segment zu messen. Unser Leitfaden zu agentischem KI-Traffic erklärt, wie von Agenten unterstützte Besuche in Analysen erscheinen und wie Sie Ihre Seiten darauf vorbereiten.
So halten Sie bezahlte Traffic-Kampagnen frei von Bot-Traffic
Bei bezahltem Traffic schadet Bot-Traffic Ihrem Budget am unmittelbarsten. Jeder ungültige Klick oder jede ungültige Impression ist Geld, das für niemanden ausgegeben wird. Das Risiko ist bei günstigem, breit gestreutem Inventar und bei Anbietern am höchsten, die nicht sagen können, woher ihre Besuche kommen, denn ihr Anreiz ist Volumen, nicht Ergebnisse.
Manche Angebote sind verkleidete Traffic-Bots. Warnzeichen sind Versprechen von "nicht erkennbaren" oder "echt wirkenden" Besuchen, garantierte Verbesserungen im Suchranking, unbegrenzte Besucher für eine Pauschale und als Vorteil dargestellte Residential-Proxy-Netzwerke. Legitime Werbeplattformen sprechen stattdessen über Targeting, Platzierungen, Landingpage-Prüfung und Messung. Bot-Besuche zu kaufen, schlägt jedes Mal fehl: Die Besuche konvertieren nie, sie verfälschen Ihre Tests, Werbenetzwerke können monetarisierte Websites sperren, die sie erhalten, und der Kauf selbst kann gegen Verbraucherschutzregeln verstoßen.
Manche Angebote sind verkleidete Traffic-Bots. Warnzeichen sind Versprechen von "nicht erkennbaren" oder "echt wirkenden" Besuchen, garantierte Verbesserungen im Suchranking, unbegrenzte Besucher für eine Pauschale und als Vorteil dargestellte Residential-Proxy-Netzwerke. Legitime Werbeplattformen sprechen stattdessen über Targeting, Platzierungen, Landingpage-Prüfung und Messung. Bot-Besuche zu kaufen, schlägt jedes Mal fehl: Die Besuche konvertieren nie, sie verfälschen Ihre Tests, Werbenetzwerke können monetarisierte Websites sperren, die sie erhalten, und der Kauf selbst kann gegen Verbraucherschutzregeln verstoßen.
Taggen Sie jede bezahlte Quelle
Nicht getaggter bezahlter Traffic vermischt sich mit Direct und Referral, wo sich Bots leicht verstecken. UTM-Parameter sind Tags, die einem Link hinzugefügt werden und Ihrem Analyse-Tool genau mitteilen, welche Quelle, Kampagne und Platzierung einen Besuch gesendet hat.
Praktischer Schritt: Eine einfache UTM-Regel schließt die meisten Attributionslücken: Jede bezahlte Kampagne erhält eigene Werte für Quelle, Medium und Kampagne, die in einer gemeinsamen Benennungstabelle dokumentiert werden. Das funktioniert, weil der Fünf-Prüfungen-Test ein sauberes Segment braucht. Wenn bezahlte Besuche mit Direct vermischt sind, können Sie nicht erkennen, welcher Anbieter die verdächtigen Sitzungen gesendet hat.
Praktischer Schritt: Eine einfache UTM-Regel schließt die meisten Attributionslücken: Jede bezahlte Kampagne erhält eigene Werte für Quelle, Medium und Kampagne, die in einer gemeinsamen Benennungstabelle dokumentiert werden. Das funktioniert, weil der Fünf-Prüfungen-Test ein sauberes Segment braucht. Wenn bezahlte Besuche mit Direct vermischt sind, können Sie nicht erkennen, welcher Anbieter die verdächtigen Sitzungen gesendet hat.
Führen Sie einen kleinen Test durch, bevor Sie skalieren
Ein kleines Testbudget zeigt Ihnen, ob sich eine Quelle wie Menschen verhält, bevor Sie echtes Geld einsetzen. Einige Hundert Sitzungen reichen aus, um die fünf Prüfungen durchzuführen, und Daten aus einer Woche zeigen Tagesrhythmen. Dieselbe Disziplin verbessert Ihre Arbeit an Landingpages, wie unser Leitfaden zum A/B-Test einer Landingpage mit bezahltem Traffic zeigt.
Auch Anzeigenformate spielen eine Rolle. Popunder-, Native- und Push-Traffic erzeugen jeweils unterschiedliche Engagement-Muster, weil sich ein Popunder-Besucher anders verhält als jemand, der sich bewusst für einen Klick auf eine Native-Anzeige entschieden hat. Wenn Sie jedes Format an seinem eigenen Vergleichswert messen, vermeiden Sie Fehlalarme.
Auch Anzeigenformate spielen eine Rolle. Popunder-, Native- und Push-Traffic erzeugen jeweils unterschiedliche Engagement-Muster, weil sich ein Popunder-Besucher anders verhält als jemand, der sich bewusst für einen Klick auf eine Native-Anzeige entschieden hat. Wenn Sie jedes Format an seinem eigenen Vergleichswert messen, vermeiden Sie Fehlalarme.
Betrachten Sie Erstattungs- und Gutschriftrichtlinien als Qualitätssignale
Seriöse Plattformen erwarten, dass Sie ihren Traffic prüfen, und erklären, was passiert, wenn etwas falsch aussieht. Eine gute Plattform verfügt über einen klaren Prozess: welche Belege sie benötigt, wie sie einen Bericht prüft und ob sie ungültige Aktivitäten gutschreibt. Ein Anbieter, der jede Prüfung verweigert oder behauptet, sein Traffic sei "zu 100 % menschlich", sagt Ihnen damit etwas. Selbst der MRC bezeichnet gefilterten Traffic nicht als "menschlich", sondern bevorzugt das Wort "gültig", weil kein Filter garantieren kann, dass jeder verbleibende Besuch von einer Person stammt.
Fortgeschrittene Strategie: Führen Sie monatlich ein Bot-Traffic-Audit durch
Einmalige Untersuchungen lösen einmalige Probleme. Bots ändern sich, Kampagnen ändern sich, und Ihre eigenen Tools ändern sich. Eine kurze monatliche Routine erkennt Probleme, bevor sie ein Quartal voller Entscheidungen verzerren. Das Ziel ist nicht null Bot-Traffic, denn das ist unmöglich. Das Ziel ist bekannter, gemessener und dokumentierter Bot-Traffic.
Eine monatliche Routine von 30 Minuten
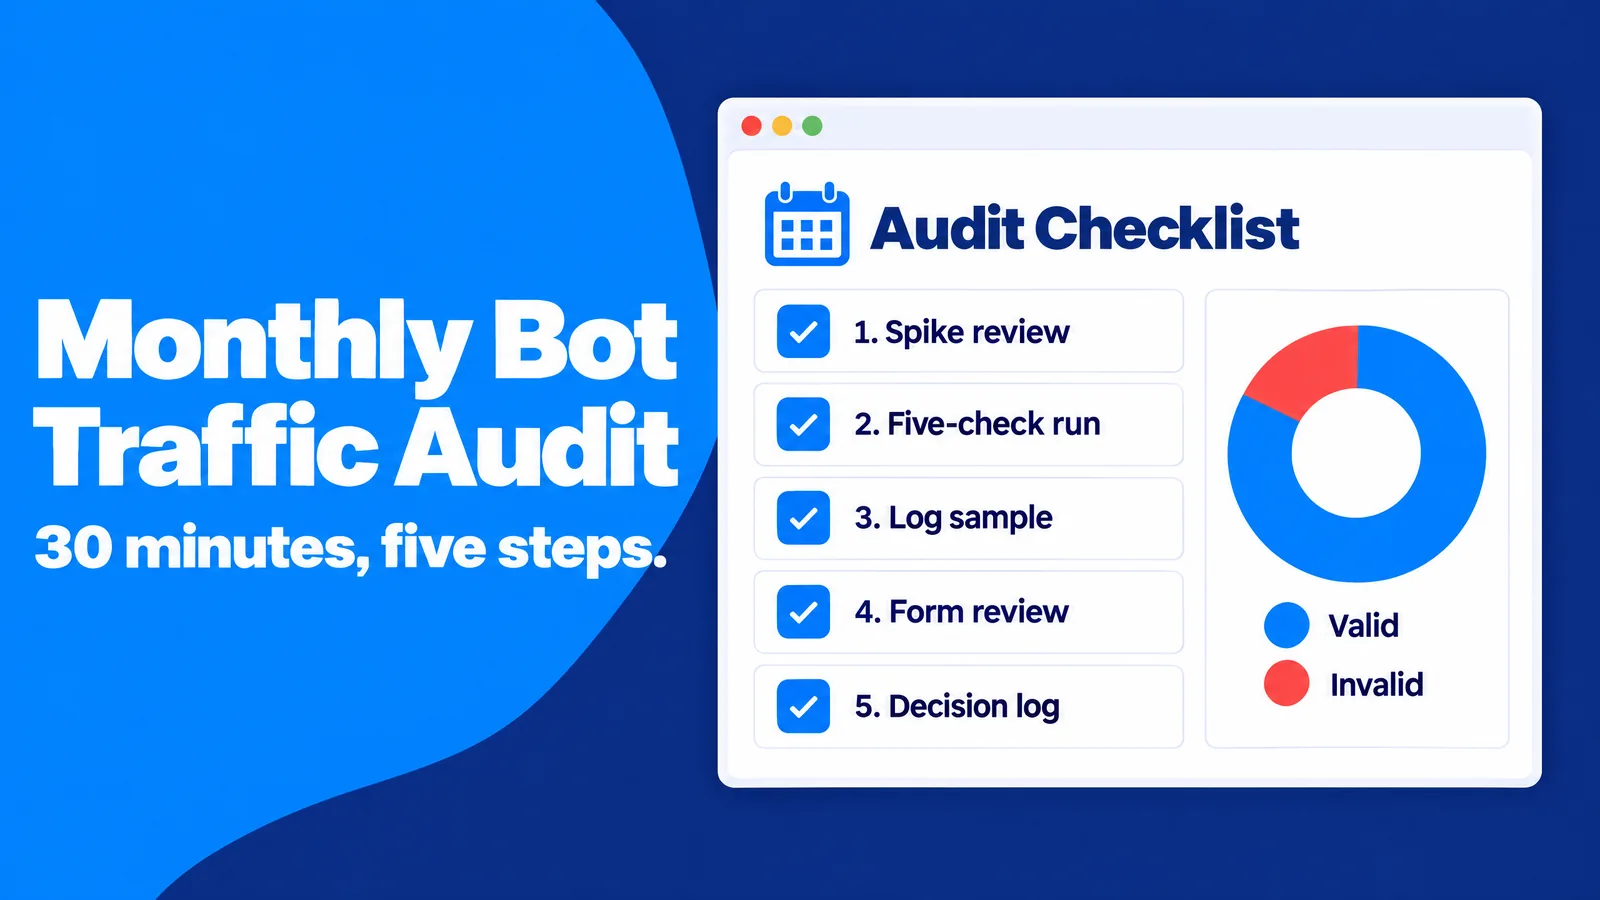
Ein wiederkehrendes Audit funktioniert am besten, wenn es jedes Mal denselben Schritten folgt, damit Trends sichtbar werden:
- Prüfung von Spitzen: jede Traffic-Spitze des vergangenen Monats mit ihrer Ursache kommentieren oder als ungeklärt markieren.
- Durchlauf der fünf Prüfungen: jede wichtige Quelle und Kampagne anhand der fünf Prüfungen bewerten.
- Protokollstichprobe: die wichtigsten behaupteten Crawler mit Forward-confirmed Reverse DNS überprüfen.
- Formularprüfung: Registrierungen und Leads auf identische Namen, Wegwerf-E-Mail-Domains oder plötzliche Spitzen prüfen.
- Entscheidungsprotokoll: festhalten, was Sie gefiltert, blockiert oder gemeldet haben und warum.
Diese Routine funktioniert, weil sie die Bot-Erkennung zu einer Gewohnheit mit nachvollziehbarer Dokumentation macht. Wenn ein Stakeholder fragt, warum sich die Zahlen im März verändert haben, haben Sie die Antwort.
Schreiben Sie eine einseitige Richtlinie für ungültigen Traffic
Selbst Experten tun sich schwer, ungültigen Traffic präzise zu definieren. Der Tuzhilin Report, eine unabhängige Überprüfung der Erkennung von Klickbetrug durch Google, die im Wikipedia-Artikel über Klickbetrug beschrieben wird, kam zu dem Schluss, dass es außer in offensichtlichen Fällen "keine konzeptionelle Definition ungültiger Klicks gibt, die operationalisiert werden kann". Wenn sich die Branche nicht auf eine Definition einigen kann, profitiert Ihr Team von einer eigenen.
Praktischer Schritt: Eine einseitige Richtlinie klärt die meisten Diskussionen im Voraus. Sie legt fest, welche automatisierten Besucher Sie zulassen, welche Schwellenwerte eine Prüfung auslösen, wer entscheidet und wie Erkenntnisse an Agenturen und Anbieter gemeldet werden. Das funktioniert, weil eine schriftliche Regel Einzelfalldebatten ersetzt und Partnern einen klaren Maßstab bietet.
Praktischer Schritt: Eine einseitige Richtlinie klärt die meisten Diskussionen im Voraus. Sie legt fest, welche automatisierten Besucher Sie zulassen, welche Schwellenwerte eine Prüfung auslösen, wer entscheidet und wie Erkenntnisse an Agenturen und Anbieter gemeldet werden. Das funktioniert, weil eine schriftliche Regel Einzelfalldebatten ersetzt und Partnern einen klaren Maßstab bietet.
Beobachten Sie Kennzahlen, die Bots nicht günstig fälschen können
Seitenaufrufe und Sitzungen lassen sich günstig fälschen. Umsatz, qualifizierte Leads, Wiederholungskäufe, Support-Tickets und wiederkehrende eingeloggte Nutzer sind im großen Maßstab teuer oder unmöglich zu fälschen. Eine Traffic-Quelle, die Sitzungen hinzufügt, diese Zahlen aber nie bewegt, verdient eine Prüfung, unabhängig davon, wie gut ihr Engagement aussieht.
Ihre Berichte auf diesen Ergebniskennzahlen zu verankern, ist die stärkste langfristige Verteidigung. Dadurch richten Sie jede Traffic-Entscheidung danach aus, was Menschen tatsächlich tun, und nehmen jedem in Ihrer Lieferkette den Anreiz, die Zahlen aufzupolstern.
Ihre Berichte auf diesen Ergebniskennzahlen zu verankern, ist die stärkste langfristige Verteidigung. Dadurch richten Sie jede Traffic-Entscheidung danach aus, was Menschen tatsächlich tun, und nehmen jedem in Ihrer Lieferkette den Anreiz, die Zahlen aufzupolstern.
Häufig gestellte Fragen zu Traffic-Bots
Was ist ein Traffic-Bot einfach erklärt?
Ein Traffic-Bot ist Software, die Websites besucht oder Anzeigen automatisch anklickt, damit die Aktivität wie die von echten Menschen aussieht. Er bläht in der Regel Kennzahlen wie Seitenaufrufe, Klicks, Videoaufrufe oder Follower auf.
Ist jeder Bot-Traffic schlecht?
Nein. Suchmaschinen-Crawler, Uptime-Monitore und viele KI-Crawler sind nützlich. Bot-Traffic wird zum Problem, wenn er vorgibt, menschlich zu sein, Werbeausgaben verschwendet, Inhalte gegen Ihre Regeln scrapt oder Ihre Analysedaten verzerrt.
Kann Bot-Traffic meiner SEO schaden?
Gefälschte Besuche verbessern keine Rankings, weil Suchmaschinen sich auf viele Qualitätssignale statt auf reine Besucherzahlen verlassen. Bot-Traffic kann dennoch indirekt schaden, indem er Ihren Server verlangsamt, Ihre Inhalte kopiert und Sie dazu bringt, anhand verunreinigter Daten die falschen Seiten zu optimieren.
Filtert Google Analytics 4 Bot-Traffic automatisch?
Ja. GA4 schließt bekannte Bots und Spider automatisch aus, und Sie können dies weder deaktivieren noch sehen, wie viel entfernt wurde. Unbekannte und ausgefeilte Bots können Ihre Berichte dennoch erreichen. Segmentvergleiche und die fünf Prüfungen bleiben daher notwendig.
Wie viel Bot-Traffic ist normal?
Es gibt keine allgemeingültige Zahl. Mehr als die Hälfte des gesamten Web-Traffics ist automatisiert, doch der Großteil davon führt Ihren Analytics-Code nie aus. Ein praktischer Vergleichswert ist Ihr eigener vertrauenswürdiger Basiskanal: Quellen, die stark davon abweichen, verdienen einen genaueren Blick.
Wie stoppe ich Bot-Traffic auf meiner Website?
Der wirksamste Ansatz ist abgestuft. Bestätigte Crawler werden zugelassen, aggressive Crawler rate-limitiert, nicht bestätigter Traffic wird nur bei Anmeldungen und Formularen herausgefordert, und nachgewiesene Missbraucher werden blockiert. Honeypot-Felder, serverseitige Validierung sowie GA4-Filter für Hostnamen und internen Traffic halten sowohl Ihre Formulare als auch Ihre Berichte sauber.
Wie erkenne ich, ob mein Website-Traffic von Bots stammt?
Am schnellsten vergleichen Sie eine verdächtige Quelle mit einem Kanal, dem Sie vertrauen, über fünf Dimensionen: Sitzungsdauer, Bildschirmauflösungen, Tageszeit, Standort und Interaktion. Zwei oder mehr klare Fehlschläge, etwa identische Sitzungsdauern und nächtliches Volumen auf Tagesniveau, deuten stark auf automatisierten Traffic hin. Serverprotokolle und Forward-confirmed Reverse DNS bestätigen anschließend, ob selbst deklarierte Crawler echt sind.
Ist es legal, Bot-Traffic zu kaufen?
Die Regeln unterscheiden sich je nach Land, doch der Kauf gefälschten Engagements für geschäftliche Zwecke birgt echte rechtliche und wirtschaftliche Risiken. In den Vereinigten Staaten verbietet die Regel der FTC von 2024 den Kauf oder Verkauf gefälschter Indikatoren für sozialen Medieneinfluss, etwa von Bots erzeugte Follower oder Aufrufe, zu geschäftlichen Zwecken. Auch Werbenetzwerke verbieten gefälschten Traffic in ihren Richtlinien.
Fazit: Messen Sie für Menschen, nicht für Zähler
Traffic-Bots existieren, weil gefälschte Aktivität billig zu erzeugen und leicht zu verkaufen ist. Ihre Verteidigung ist ein klares Bild davon, wie echte Menschen auf Ihrer Website aussehen. Die fünf Prüfungen, ein vertrauenswürdiger Vergleichswert, die Überprüfung auf Serverebene und ein monatliches Audit geben Ihnen dieses Bild ohne teure Tools.
Das alte Web belohnte große Zahlen. Das heutige Web belohnt Vertrauen: Suchmaschinen, Werbetreibende, KI-Systeme und Kunden reagieren alle auf echtes Engagement. Wenn Sie Ihre Daten vor Bots schützen, schützen Sie jede Entscheidung, die davon abhängt, und richten Ihre Aufmerksamkeit auf die Zielgruppe, die kauft, abonniert und zurückkehrt: echte Menschen.
Das alte Web belohnte große Zahlen. Das heutige Web belohnt Vertrauen: Suchmaschinen, Werbetreibende, KI-Systeme und Kunden reagieren alle auf echtes Engagement. Wenn Sie Ihre Daten vor Bots schützen, schützen Sie jede Entscheidung, die davon abhängt, und richten Ihre Aufmerksamkeit auf die Zielgruppe, die kauft, abonniert und zurückkehrt: echte Menschen.