Más de la mitad de todo el tráfico web lo generan bots, según el resumen de Wikipedia sobre los bots de internet. Parte de esa automatización mantiene la web en funcionamiento. Los rastreadores de los motores de búsqueda indexan tus páginas y los monitores de disponibilidad confirman que tu proceso de compra sigue cargando a las 3 a. m.
Una parte cada vez mayor del tráfico automatizado hace otra cosa. Imita a las personas, infla tus cifras y agota presupuestos publicitarios destinados a clientes reales. Juniper Research estimó que el fraude publicitario costó a los anunciantes 88.000 millones de dólares en 2023, y gran parte de ese fraude se basa en visitas y clics automatizados.
Para ti, como profesional del marketing, el coste mayor suele ser invisible. Los presupuestos, los planes de contenido y las decisiones sobre páginas de destino pueden basarse en visitas que ninguna persona realizó jamás.
Esta guía explica qué es un bot de tráfico, por qué existe el tráfico de bots y cómo puedes detectarlo en tus analíticas y registros del servidor. Pasamos de las definiciones a una rutina práctica de detección y después a hábitos avanzados de auditoría. Un principio se mantiene en toda la guía: los motores de búsqueda y los sistemas de IA leen tus páginas, pero el público que importa siempre está formado por personas reales.
¿Qué es un bot de tráfico?
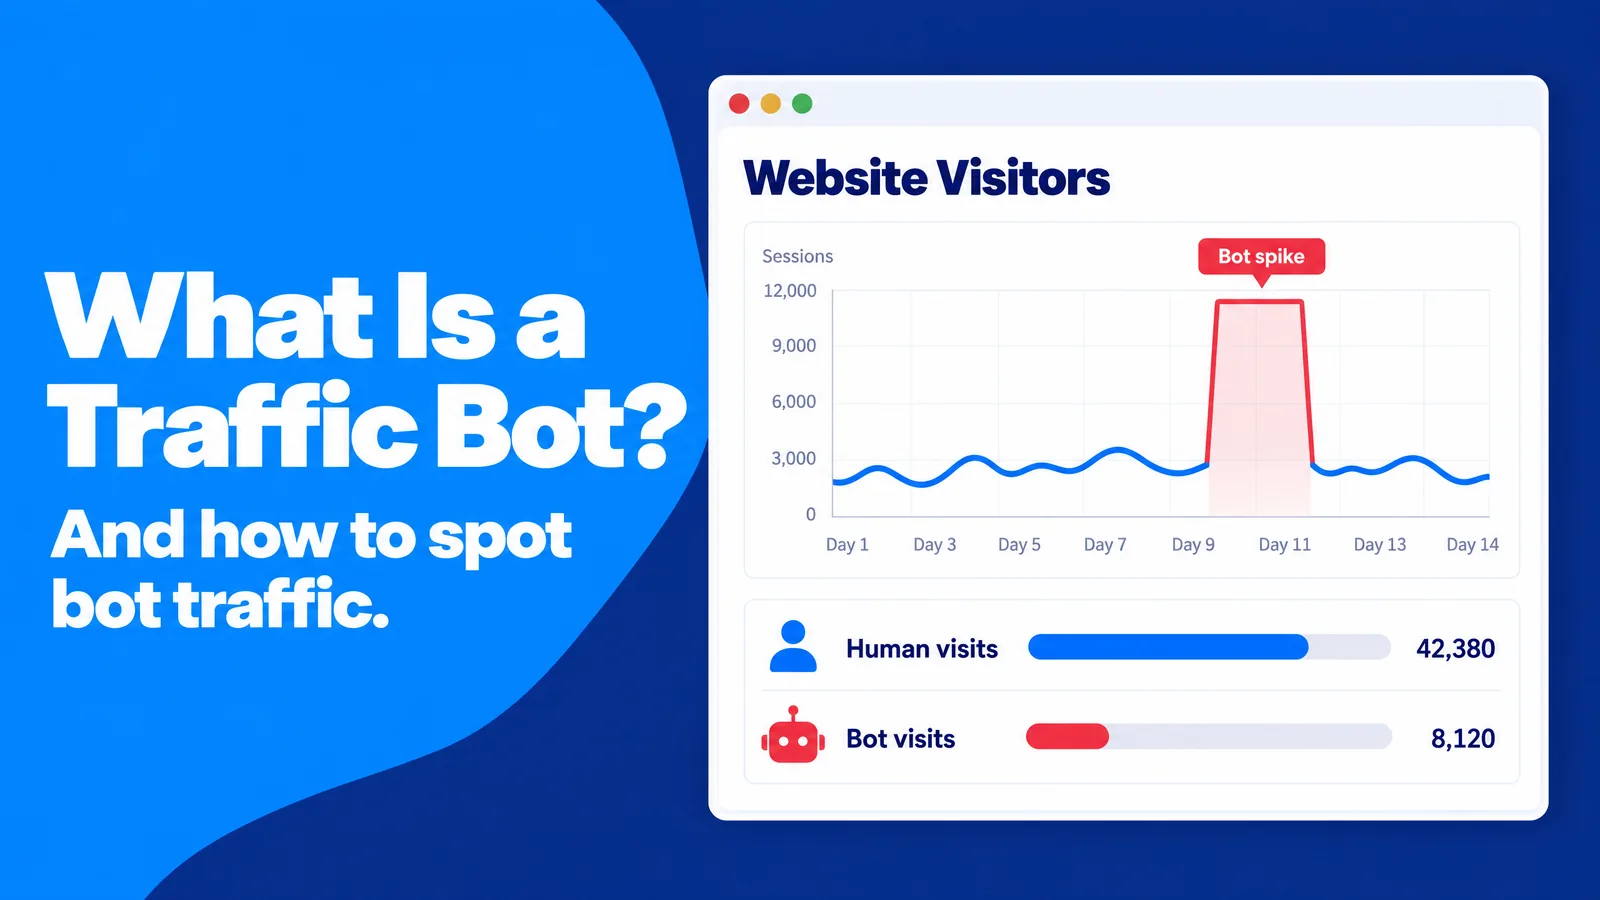
El término "bot de tráfico" se usa de forma imprecisa, y eso crea confusión antes de que empiece cualquier análisis. Un desarrollador puede usarlo para un script de pruebas de carga. Un vendedor en una plataforma freelance puede usarlo para un software que promete "10.000 visitantes al día". Un equipo de seguridad puede usarlo para referirse a todo lo que no sea una persona, y cuando tres personas en una reunión quieren decir tres cosas distintas, el equipo discute sobre etiquetas en vez de solucionar el problema.
En esta guía, un bot de tráfico es un programa de software que envía visitas automatizadas a un sitio web, una aplicación o un anuncio para que la actividad parezca proceder de personas. Su objetivo suele ser inflar una métrica como las páginas vistas, las impresiones publicitarias, los clics, las visualizaciones de vídeo o los seguidores. Un bot de tráfico es un tipo de bot de internet, una aplicación de software que ejecuta tareas automatizadas a través de internet.
En esta guía, un bot de tráfico es un programa de software que envía visitas automatizadas a un sitio web, una aplicación o un anuncio para que la actividad parezca proceder de personas. Su objetivo suele ser inflar una métrica como las páginas vistas, las impresiones publicitarias, los clics, las visualizaciones de vídeo o los seguidores. Un bot de tráfico es un tipo de bot de internet, una aplicación de software que ejecuta tareas automatizadas a través de internet.
Bot de tráfico frente a tráfico de bots
El tráfico de bots es la categoría más amplia. Abarca cada visita o solicitud que realiza un programa en lugar de una persona, sea cual sea la intención. Cuando Googlebot rastrea tu blog, eso es tráfico de bots. Sin embargo, nadie llamaría a Googlebot un bot de tráfico, porque se identifica, respeta tus reglas de rastreo y no pretende ser un comprador.
La diferencia determina tu respuesta. El tráfico de bots de un rastreador declarado requiere gestión: tú decides a qué puede acceder. Las visitas de un bot de tráfico exigen detección y exclusión, porque el objetivo de un bot de tráfico es confundirse con tus visitantes humanos.
La diferencia determina tu respuesta. El tráfico de bots de un rastreador declarado requiere gestión: tú decides a qué puede acceder. Las visitas de un bot de tráfico exigen detección y exclusión, porque el objetivo de un bot de tráfico es confundirse con tus visitantes humanos.
Bots buenos, bots malos y la zona gris
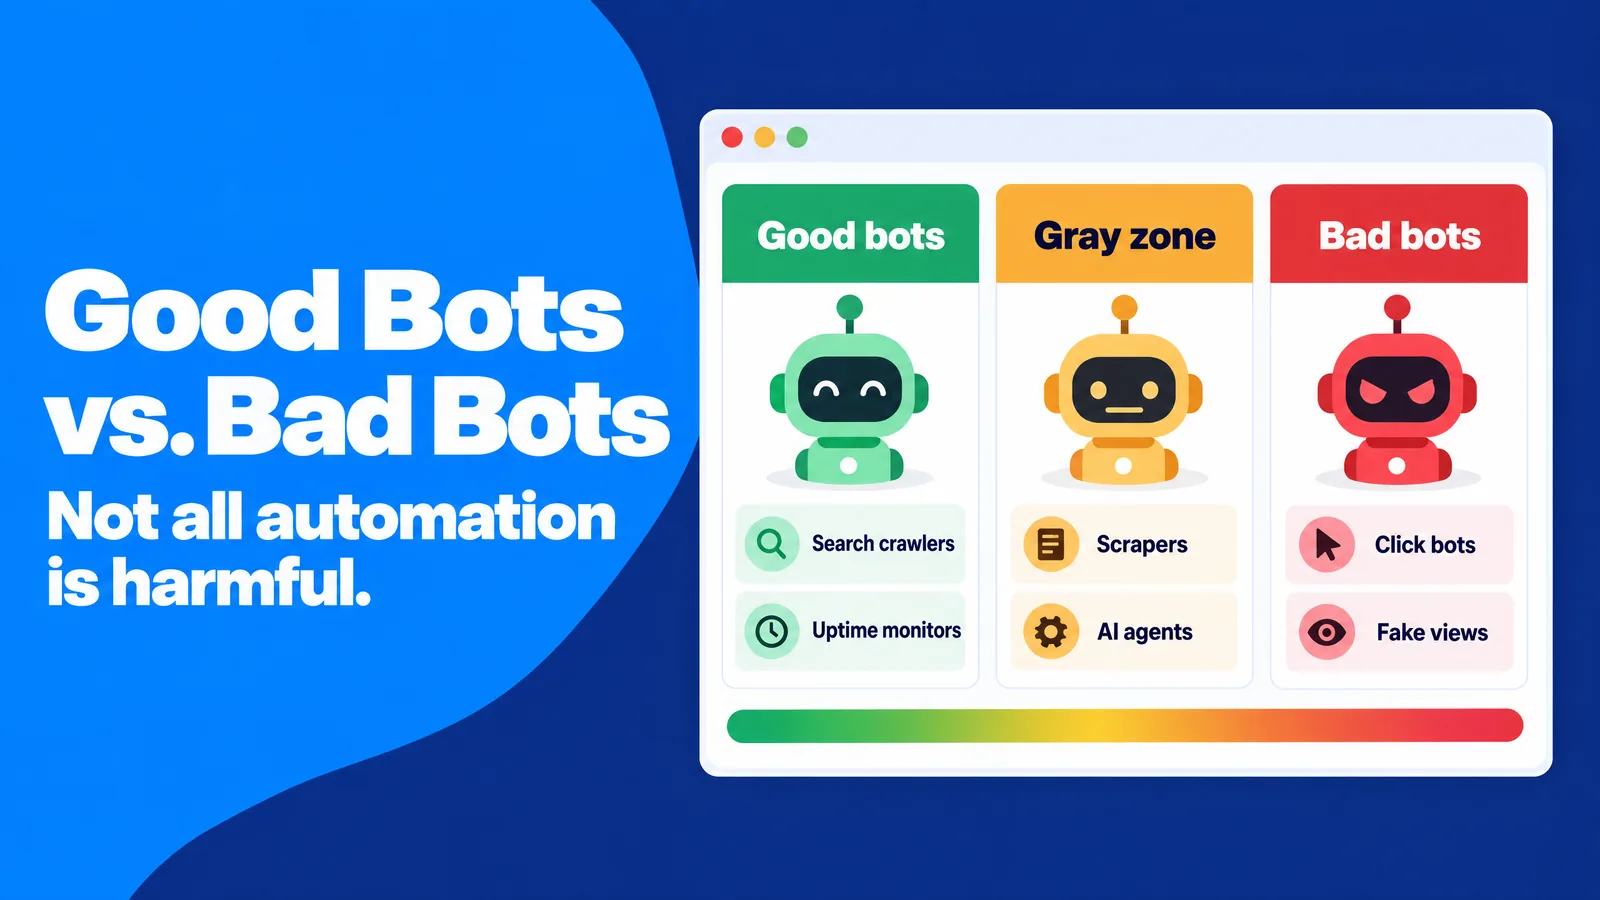
La industria publicitaria cuenta con un vocabulario útil para esto. El Media Rating Council (MRC), el organismo estadounidense que acredita la medición publicitaria, divide el tráfico no válido en dos grupos en sus estándares de tráfico no válido:
- Tráfico no válido general (GIVT): rastreadores conocidos, tráfico de centros de datos y otra automatización que los filtros basados en listas pueden detectar.
- Tráfico no válido sofisticado (SIVT): bots que imitan el comportamiento humano, dispositivos comprometidos, malware y actividad incentivada, que requieren un análisis más profundo para identificarse.
Entre lo claramente bueno y lo claramente malo existe una zona gris. Los scrapers de seguimiento de precios, los rastreadores de herramientas SEO, los rastreadores de entrenamiento de IA y los agentes de IA que navegan en nombre de una persona están todos automatizados. Que sean bienvenidos depende de tu modelo de negocio, no de una regla universal.
Tipos habituales de bots de tráfico
Los bots de tráfico se dividen en varias familias reconocibles. Conocerlas te ayuda a adivinar a cuál te enfrentas por el patrón que deja:
- Bots de clics hacen clic en anuncios o resultados de búsqueda para agotar el presupuesto de un competidor o simular interacción, una práctica conocida como fraude de clics.
- Bots de impresiones cargan anuncios en páginas falsas o camufladas para que los anunciantes paguen por visualizaciones que nadie vio.
- Los programas de autosurf e intercambio de tráfico rotan páginas entre miembros para que cada sitio registre "visitas" que nadie lee.
- Bots de spam de referencia colocan una URL en tus informes de referencias para tentarte a visitarla, una táctica llamada spam de referencia.
- Navegadores sin interfaz gráfica son navegadores completos sin pantalla. Los desarrolladores los usan para pruebas y los defraudadores los han utilizado indebidamente para inflar impresiones publicitarias.
- Granjas de clics usan personas mal remuneradas en lugar de código. Los visitantes son técnicamente humanos, pero la intención es falsa, por lo que los estándares de medición tratan la actividad como no válida.
Paso práctico: Un primer paso útil es elaborar un inventario de una página de la automatización que permites. Incluye tus rastreadores de búsqueda, monitores de disponibilidad, rastreadores SEO, webhooks de pago y asistentes de IA de los que quieres recibir citas, junto con el user agent que declara cada uno. Esto funciona porque muchas falsas alarmas proceden de tus propias herramientas: un rastreo SEO programado para las 3 a. m. se parece exactamente a un pico nocturno sospechoso hasta que consultas el inventario.
Por qué los visitantes reales dejan una huella reconocible
La mayoría de los consejos sobre el tráfico de bots empiezan por lo que parece incorrecto. Un punto de partida más fiable es saber cómo es lo normal, porque no puedes juzgar una anomalía sin una referencia.
Los visitantes humanos son maravillosamente incoherentes. Una persona lee tu página de precios en el teléfono durante un trayecto de 40 segundos. Otra deja abierta una pestaña de escritorio durante 12 minutos, y una tercera se va a los dos segundos porque tocó el resultado equivocado.
Esa irregularidad es la señal más fuerte que tienes. Cada visita humana presenta decenas de pequeñas variaciones: tamaño de pantalla, versión del navegador, zona horaria, velocidad de desplazamiento y la pausa antes de un clic. Al tráfico automatizado le cuesta copiar toda esa variedad a escala, porque cada nueva variación cuesta al operador del bot tiempo de ingeniería e infraestructura. Una red de bots puede falsear una o dos dimensiones de manera convincente, pero falsearlas todas a la vez, en miles de sesiones, es caro.
SparkTraffic, una plataforma publicitaria que ofrece visitas web segmentadas geográficamente mediante anuncios en sitios de editores asociados desde 2015, se apoya en este principio de variedad en una prueba de cinco comprobaciones que publica para sus propios anunciantes. El razonamiento es sencillo: cualquiera que pague por visitas debería poder confirmar, con analíticas estándar y sin herramientas especiales, que esas visitas se comportan como personas. Las mismas comprobaciones sirven para cualquier fuente, de pago u orgánica, por lo que constituyen una buena referencia general para tus propios informes.
La prueba de huella humana de cinco comprobaciones
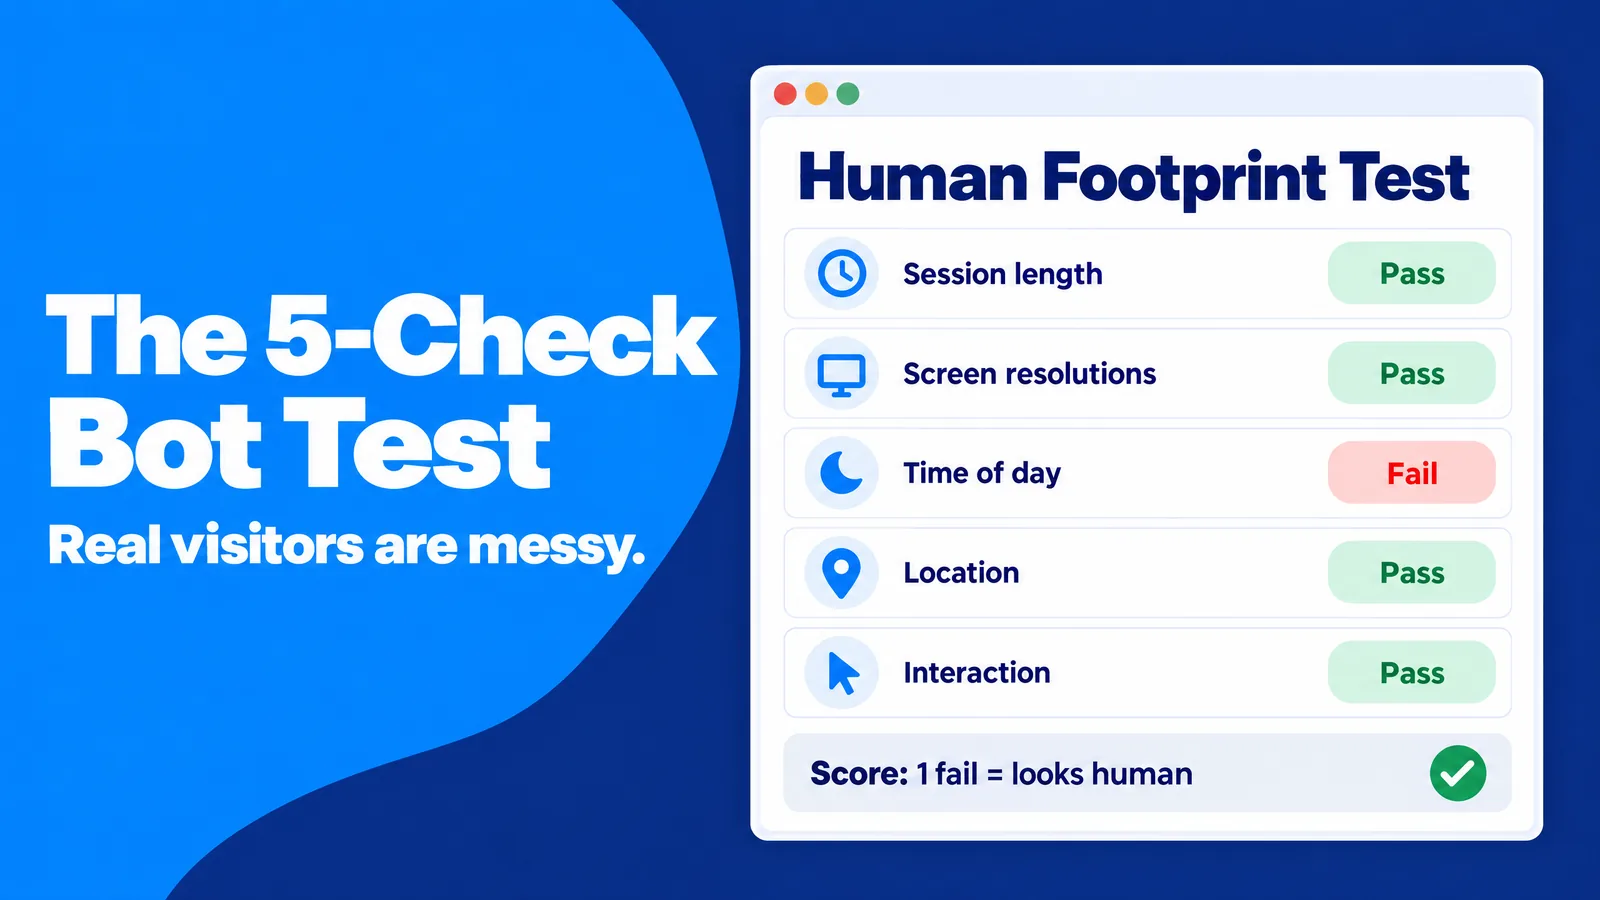
Cada comprobación compara una dimensión del comportamiento con la variedad que esperarías de personas reales. Los umbrales son deliberadamente flexibles, para que las muestras pequeñas y las fluctuaciones normales no provoquen falsas alarmas:
- Duración de la sesión: el tráfico saludable se distribuye desde menos de 10 segundos hasta más de dos minutos. Una señal de alerta es que más de la mitad de las sesiones caigan en el mismo intervalo de cinco segundos.
- Resoluciones de pantalla: el tráfico saludable muestra muchas resoluciones diferentes. Una señal de alerta es que una sola resolución represente más de la mitad de las sesiones.
- Hora del día: el tráfico saludable sigue patrones diurnos locales. Una señal de alerta es que el volumen local de la 1 a. m. a las 5 a. m. iguale los niveles diurnos.
- Ubicación: el tráfico saludable y segmentado envía más del 90 % de las visitas desde la zona objetivo. Una señal de alerta es que más del 10 % llegue desde lugares a los que no te dirigiste.
- Interacción: el tráfico saludable incluye algunos desplazamientos, clics o inicios de formularios. Una señal de alerta es no tener interacciones en 300 sesiones.
Cero o una comprobación fallida sugiere que el tráfico se comporta como personas. Dos o más fallos son motivo para pausar la fuente, exportar unas 20 sesiones como prueba y pedir una revisión al proveedor. Esta puntuación funciona porque una métrica extraña aislada suele tener una causa inocente, como una campaña solo para móviles que reduce las resoluciones de pantalla, mientras que varios fallos a la vez rara vez la tienen.
Crea tu propia referencia humana
Los umbrales genéricos son un punto de partida, no un veredicto. Un blog de recetas, un sitio de documentación SaaS y un dentista local tienen duraciones de sesión y ritmos diarios diferentes. Una sesión media de cinco minutos puede ser sospechosa en una página de localizador de tiendas y perfectamente normal en un tutorial largo.
Paso práctico: La referencia más fiable es un canal en el que ya confías, como los clics de una newsletter o los clientes que han iniciado sesión. Registrar su distribución en las cinco dimensiones anteriores durante 30 días te da una referencia, y cualquier fuente nueva que parezca extraña puede compararse con ella en vez de con una media del sector. Esto funciona porque tu canal de confianza ya refleja tu público, tus dispositivos y tus zonas horarias, por lo que una gran desviación señala a la fuente y no a tu sitio.
Paso práctico: La referencia más fiable es un canal en el que ya confías, como los clics de una newsletter o los clientes que han iniciado sesión. Registrar su distribución en las cinco dimensiones anteriores durante 30 días te da una referencia, y cualquier fuente nueva que parezca extraña puede compararse con ella en vez de con una media del sector. Esto funciona porque tu canal de confianza ya refleja tu público, tus dispositivos y tus zonas horarias, por lo que una gran desviación señala a la fuente y no a tu sitio.
Por qué existen los bots de tráfico y cuánto te cuestan
Los bots de tráfico existen porque alguien se beneficia de la actividad falsa. El beneficio puede ser directo, como en el fraude publicitario, o indirecto, como en el caso de un proveedor que vende "tráfico" para que un panel parezca activo. Comprender el motivo te ayuda a predecir el patrón: un defraudador quiere impresiones y clics, un vendedor de métricas de vanidad quiere páginas vistas y un spammer quiere tu atención.
Fraude publicitario a escala industrial
El ejemplo mejor documentado es Methbot. Según el Departamento de Justicia de Estados Unidos, la operación utilizó más de 1.900 servidores y más de 650.000 direcciones IP para cargar anuncios en más de 5.000 sitios web falsificados y recaudó más de 7 millones de dólares. Un plan relacionado, 3ve, funcionó en unos 1,7 millones de ordenadores infectados y obtuvo más de 29 millones de dólares.
Los bots se crearon para parecer humanos. El anuncio de la sentencia del DOJ describe bots que simulaban movimientos de ratón, desplazamiento e inicios de sesión en redes sociales, y el principal operador recibió una pena de prisión de 10 años. La lección para profesionales del marketing es que la "interacción realista" por sí sola no demuestra nada, porque Methbot se diseñó precisamente para producirla.
Los bots se crearon para parecer humanos. El anuncio de la sentencia del DOJ describe bots que simulaban movimientos de ratón, desplazamiento e inicios de sesión en redes sociales, y el principal operador recibió una pena de prisión de 10 años. La lección para profesionales del marketing es que la "interacción realista" por sí sola no demuestra nada, porque Methbot se diseñó precisamente para producirla.
Popularidad falsa y métricas de vanidad
Un segundo motivo es la apariencia de popularidad. Algunos proveedores venden software de bots de tráfico o "paquetes de visitantes" que inflan las páginas vistas, las visualizaciones de vídeo o el número de seguidores. En los inicios de la web, los contadores de visitas brutas impresionaban a la gente, y las cifras infladas ofrecían una recompensa a corto plazo. Hoy, los motores de búsqueda, los anunciantes y los inversores miran la interacción, las conversiones y los ingresos, por lo que el volumen falso no compra nada y contamina los datos que necesitas.
Los reguladores ahora tratan la popularidad falsa como engaño. En agosto de 2024, la Comisión Federal de Comercio de Estados Unidos finalizó una norma que prohíbe vender o comprar indicadores falsos de influencia en redes sociales, como seguidores o visualizaciones generados por bots. La prohibición se aplica cuando el comprador sabía o debería haber sabido que los indicadores eran falsos y los utilizó con fines comerciales. Las políticas publicitarias de Google también prohíben promocionar servicios que venden actividad de usuario falsificada, como clics no válidos.
Los reguladores ahora tratan la popularidad falsa como engaño. En agosto de 2024, la Comisión Federal de Comercio de Estados Unidos finalizó una norma que prohíbe vender o comprar indicadores falsos de influencia en redes sociales, como seguidores o visualizaciones generados por bots. La prohibición se aplica cuando el comprador sabía o debería haber sabido que los indicadores eran falsos y los utilizó con fines comerciales. Las políticas publicitarias de Google también prohíben promocionar servicios que venden actividad de usuario falsificada, como clics no válidos.
Spam de referencia y tráfico fantasma
Un tercer motivo es la atención. Los bots de spam de referencia visitan tu sitio, o envían datos directamente a tu propiedad de analítica, con una URL de referencia falsa. Cuando ves un dominio desconocido en tu informe de referencias, la curiosidad hace el resto y el spammer consigue una visita o una venta. El artículo de Wikipedia sobre el spam de referencia describe cómo esta táctica pasó de los registros del servidor a las herramientas de analítica.
El coste real: decisiones basadas en datos falsos
El coste directo del tráfico de bots es gasto publicitario desperdiciado y carga del servidor. El coste indirecto suele ser mayor. Imagina una prueba A/B en la que la variante B recibe 600 sesiones adicionales de bots sin conversiones: la tasa de conversión de B baja, mantienes la página más débil y nadie llega a saber por qué. O imagina un equipo de contenido que redobla sus esfuerzos en un tema porque un scraper rastreó esos artículos cada hora.
Paso práctico: Una estimación del coste de contaminación hace el problema concreto. Multiplica la proporción de sesiones que fallaron dos o más de las cinco comprobaciones por tu inversión en medios de pago del trimestre. Después enumera cada decisión, como cambios de presupuesto, ganadores de pruebas y prioridades de contenido, que se basó en esos informes. Esto funciona porque convierte un problema abstracto de calidad de datos en una cifra presupuestaria, lo que facilita mucho más conseguir la aprobación de tiempo y herramientas.
Paso práctico: Una estimación del coste de contaminación hace el problema concreto. Multiplica la proporción de sesiones que fallaron dos o más de las cinco comprobaciones por tu inversión en medios de pago del trimestre. Después enumera cada decisión, como cambios de presupuesto, ganadores de pruebas y prioridades de contenido, que se basó en esos informes. Esto funciona porque convierte un problema abstracto de calidad de datos en una cifra presupuestaria, lo que facilita mucho más conseguir la aprobación de tiempo y herramientas.
Cómo detectar tráfico de bots en Google Analytics 4
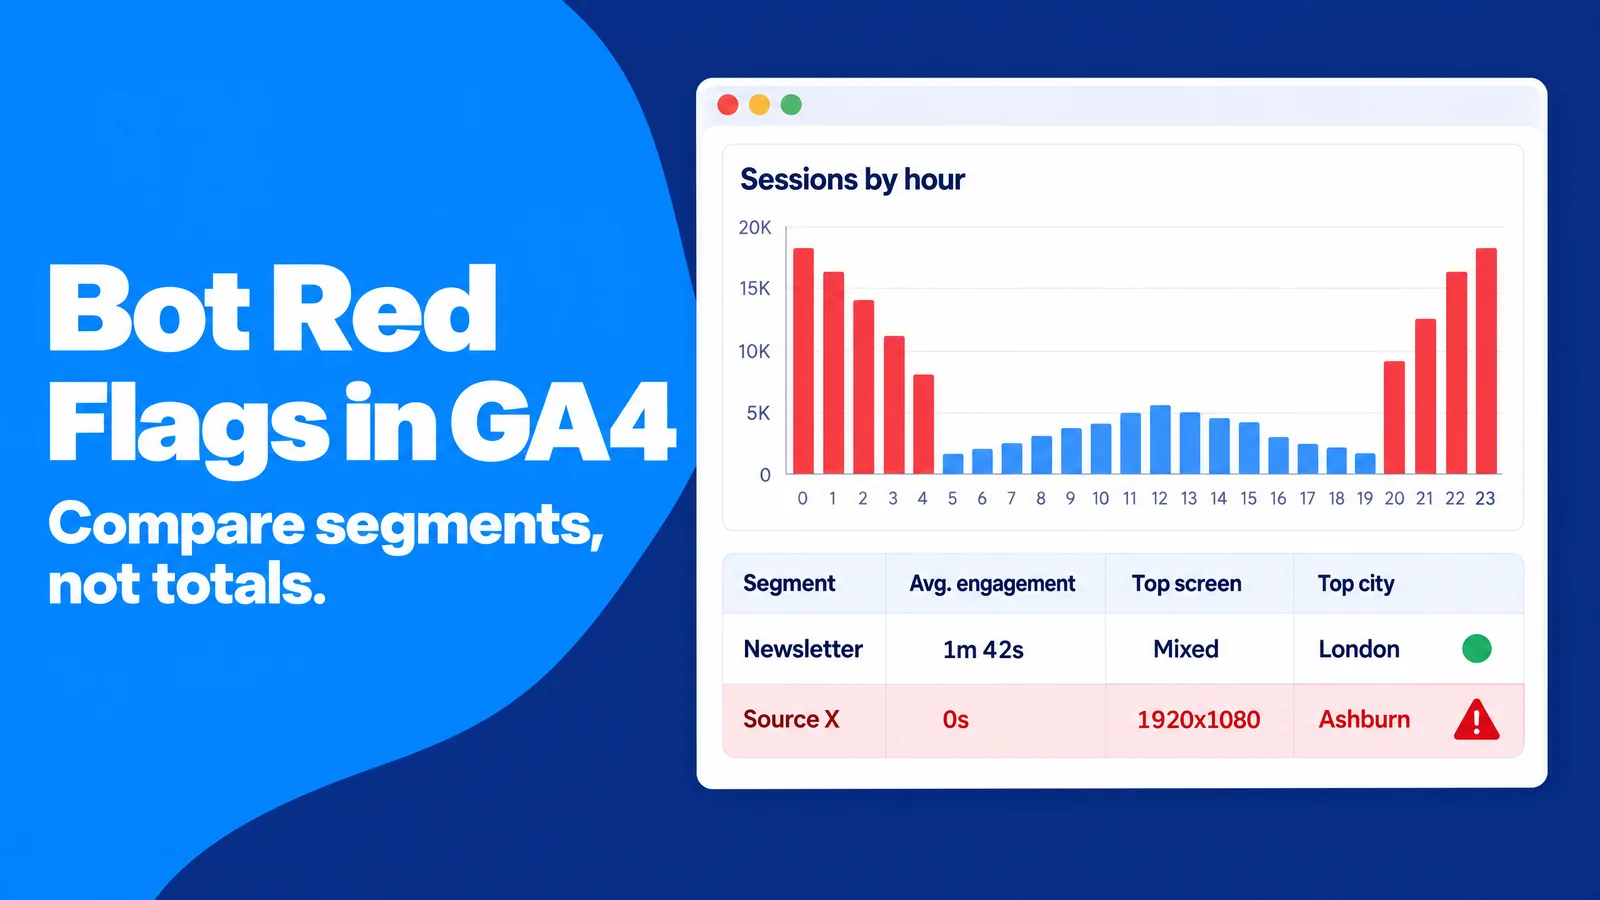
Google Analytics 4 (GA4) ya excluye automáticamente los bots conocidos mediante la propia investigación de Google y la IAB/ABC International Spiders and Bots List. No puedes desactivar esta función ni ver cuánto tráfico ha eliminado. Eso parece tranquilizador, pero significa que los bots que quedan en tus informes son, por definición, los que no aparecen en ninguna lista. Detectar tráfico de bots más allá de esa lista es tu trabajo.
La buena noticia es que los bots desconocidos siguen dejando patrones. Suelen llegar en ráfagas, usar un conjunto reducido de dispositivos, ignorar tus rutas de conversión y agruparse en lugares donde no viven tus clientes. Identificas el tráfico de bots comparando segmentos, no observando los totales.
La buena noticia es que los bots desconocidos siguen dejando patrones. Suelen llegar en ráfagas, usar un conjunto reducido de dispositivos, ignorar tus rutas de conversión y agruparse en lugares donde no viven tus clientes. Identificas el tráfico de bots comparando segmentos, no observando los totales.
Empieza por la forma del pico
Los picos naturales de tráfico tienen una causa y una forma. Una newsletter, una publicación social o una mención en prensa produce una subida pronunciada seguida de una caída gradual durante horas o días, y las conversiones aumentan con ella. Los picos de bots suelen ser distintos: mesetas con la parte superior plana, comienzos y finales a horas en punto y sesiones que suben mientras los eventos clave se mantienen planos.
Cuando aparece un pico, la primera pregunta es: "¿qué ocurrió en ese momento?" Si ninguna campaña, mención o evento estacional lo explica, lo mejor es tratar el pico como no verificado hasta que la comparación de segmentos que aparece más abajo indique lo contrario.
Cuando aparece un pico, la primera pregunta es: "¿qué ocurrió en ese momento?" Si ninguna campaña, mención o evento estacional lo explica, lo mejor es tratar el pico como no verificado hasta que la comparación de segmentos que aparece más abajo indique lo contrario.
Ocho señales de alerta en tus informes
Conviene revisar estos patrones siempre que una fuente o una página de destino parezca inusual:
- Tiempo de interacción cercano a cero: muchas sesiones con casi ningún tiempo de interacción, o duraciones agrupadas en los mismos pocos segundos.
- Picos de Direct o Unassigned: crecimiento repentino del tráfico Direct o Unassigned hacia una página de destino que no está enlazada en ningún lugar evidente.
- Nombres de host desconocidos: impactos registrados en dominios que no son tuyos, lo que ocurre cuando alguien copia tu ID de medición en otro sitio.
- Un solo perfil de dispositivo: una única resolución de pantalla, versión de navegador o sistema operativo domina una fuente.
- Ubicaciones de centros de datos: grupos en ciudades conocidas por sus granjas de servidores, como Ashburn, Virginia, en lugar de donde viven tus clientes.
- Tráfico nocturno: volumen local de la 1 a. m. a las 5 a. m. igual al volumen diurno.
- Referencias extrañas: dominios desconocidos, especialmente los que anuncian servicios de SEO o tráfico.
- Conversiones planas: las sesiones aumentan mientras los registros, las compras o los leads cualificados se mantienen planos, o los envíos de formularios están llenos de texto sin sentido.
Crea una exploración para investigar bots
La sección Explorar de GA4 te permite crear un informe reutilizable para este trabajo. Una exploración de formato libre con las dimensiones adecuadas responde a la mayoría de las preguntas en minutos, y una plantilla guardada significa que la siguiente investigación no empieza desde cero:
- Configuración: una exploración de formato libre con las dimensiones fuente/medio de la sesión, página de destino, nombre de host, resolución de pantalla, ciudad y hora.
- Métricas: sesiones, sesiones con interacción, tiempo medio de interacción por sesión y eventos clave.
- Segmentos: uno para la fuente sospechosa y otro para tu canal de referencia de confianza.
- Comparación: los dos segmentos uno junto a otro, dimensión por dimensión, usando las cinco comprobaciones como guía.
- Pruebas: una exportación de unas 20 sesiones sospechosas con sus atributos, lista para compartir con un proveedor o plataforma publicitaria.
Este enfoque funciona porque los bots rara vez fallan en una sola dimensión de forma aislada. Los segmentos en paralelo hacen visibles al mismo tiempo el perfil de dispositivo limitado, las horas extrañas y las conversiones ausentes. Nuestra guía sobre cómo usar la analítica para mejorar tu tráfico web cubre los informes principales de GA4, y la guía sobre atribución de tráfico de IA explica cómo interpretar el tráfico Direct sin sacar conclusiones precipitadas.
Usa los filtros de datos de GA4 con cuidado
Los filtros de datos son la forma principal de excluir el tráfico de bots en GA4 cuando ya sabes de dónde procede. Pueden eliminar el tráfico interno, el tráfico de desarrolladores y, más recientemente, los impactos de nombres de host que no posees. Un filtro de nombres de host que incluya solo tus propios dominios es una solución limpia para los ID de medición copiados en otros sitios. Los filtros son potentes, pero implacables: una vez que un filtro está activo, los datos excluidos desaparecen para siempre.
Paso práctico: El hábito más seguro es ejecutar cada filtro nuevo en modo de prueba durante al menos una semana y comparar los resultados filtrados y no filtrados antes de activarlo. Así evitas eliminar datos de clientes reales por un error tipográfico en un nombre de dominio o una regla demasiado amplia.
Paso práctico: El hábito más seguro es ejecutar cada filtro nuevo en modo de prueba durante al menos una semana y comparar los resultados filtrados y no filtrados antes de activarlo. Así evitas eliminar datos de clientes reales por un error tipográfico en un nombre de dominio o una regla demasiado amplia.
Cómo verificar bots a nivel de servidor
Las herramientas de analítica solo ven a los visitantes que ejecutan tu código de seguimiento. Muchos bots nunca ejecutan JavaScript, así que nunca aparecen en GA4, pero siguen consumiendo ancho de banda, extrayendo contenido y sondeando formularios de inicio de sesión. Los registros de tu servidor, los registros de CDN o el panel de tu hosting muestran cada solicitud, lo que los convierte en el lugar para confirmar quién te visita realmente.
Por qué los user agents no demuestran nada
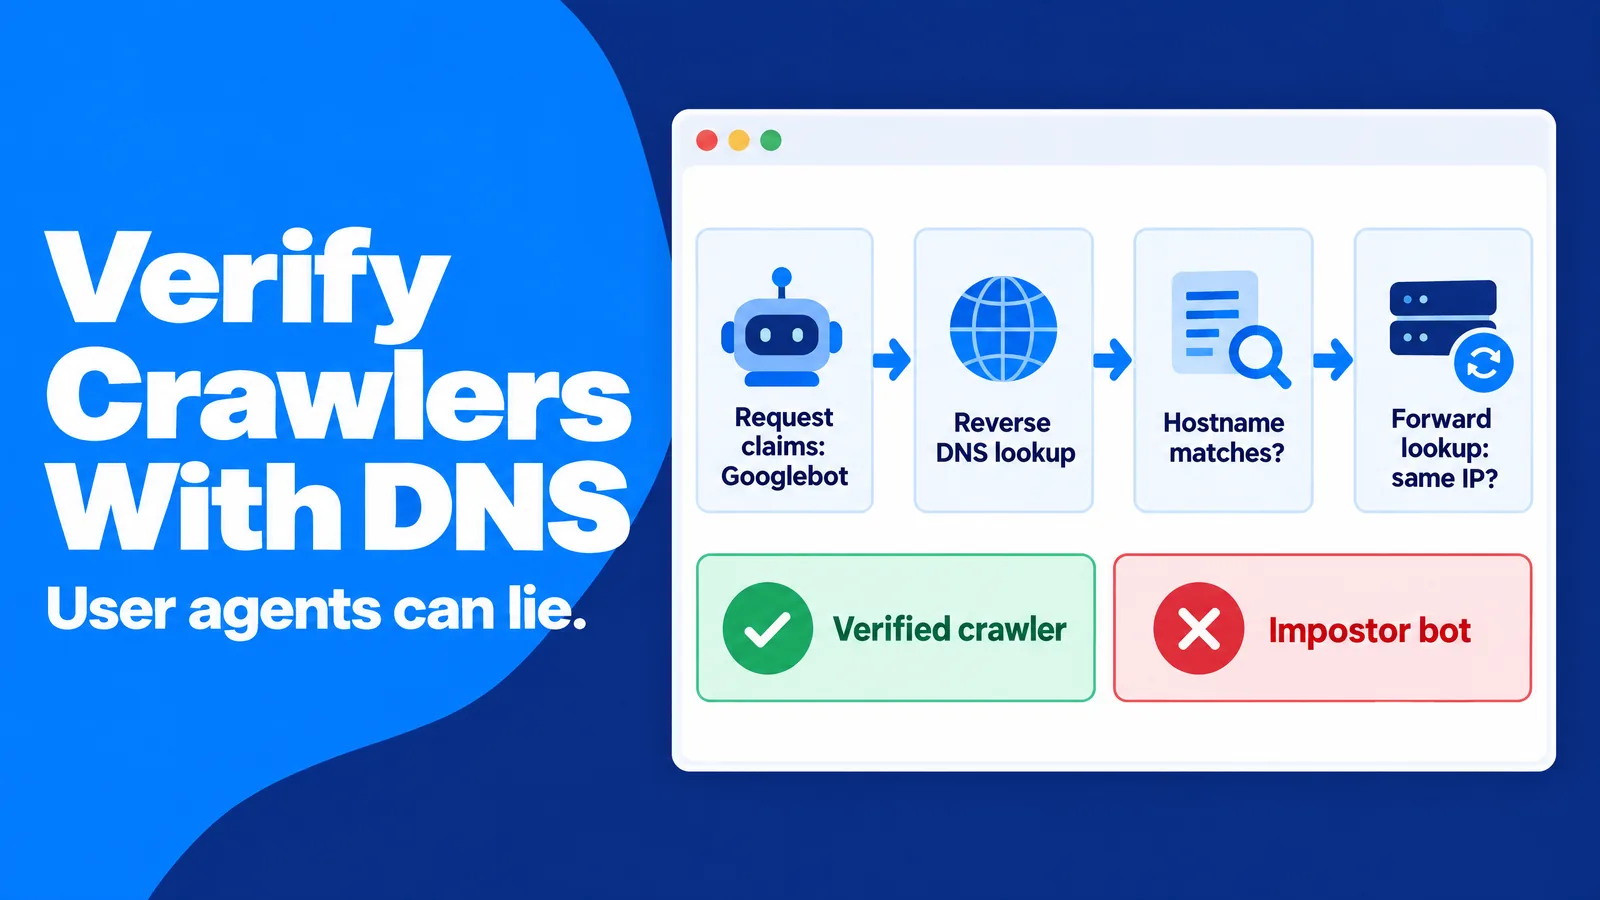
Cada solicitud lleva una cadena de user agent que identifica el navegador o bot. El problema es que la escribe el visitante. Un scraper puede afirmar ser Googlebot, Chrome en un iPhone o cualquier otra cosa con una línea de código, por lo que tratar el user agent como identidad es como aceptar una etiqueta con un nombre como si fuera un pasaporte.
Confirma rastreadores con DNS inverso con confirmación directa
La forma estándar de comprobar un rastreador que se declara a sí mismo es el DNS inverso con confirmación directa. Requiere dos consultas. Una consulta DNS inversa de la dirección IP del visitante devuelve un nombre de host, que debe pertenecer al dominio del operador declarado. Después, una consulta directa de ese nombre de host debe devolver la misma dirección IP, así que un Googlebot falso falla porque su dirección IP no se resuelve de vuelta a los dominios de Google.
Paso práctico: Una muestra mensual de los registros mantiene esto manejable. Extraer los 20 user agents que realizaron más solicitudes y comprobar los que afirman ser un motor de búsqueda o un gran rastreador de IA lleva unos minutos. Esto funciona porque los impostores se concentran donde la recompensa es mayor: hacerse pasar por un rastreador de confianza es la forma más fácil de superar los límites de velocidad y los cortafuegos.
Paso práctico: Una muestra mensual de los registros mantiene esto manejable. Extraer los 20 user agents que realizaron más solicitudes y comprobar los que afirman ser un motor de búsqueda o un gran rastreador de IA lleva unos minutos. Esto funciona porque los impostores se concentran donde la recompensa es mayor: hacerse pasar por un rastreador de confianza es la forma más fácil de superar los límites de velocidad y los cortafuegos.
Robots.txt es una solicitud, no un candado
El archivo robots.txt indica a los rastreadores a qué pueden acceder, y el formato está estandarizado en RFC 9309. El cumplimiento es voluntario. Los rastreadores que se comportan bien lo respetan, mientras que los bots de tráfico y muchos scrapers lo ignoran o cambian de nombre para eludir bloqueos.
Robots.txt sigue siendo útil porque separa a los bots que respetan tus reglas de los que no. Wikipedia señala que 306 de los 1.000 sitios web más visitados bloquearon el GPTBot de OpenAI en 2023, lo que demuestra cómo los propietarios de sitios usan ahora el archivo como declaración de política. Un bot que solicita páginas que has prohibido te dice algo importante sobre su intención.
Robots.txt sigue siendo útil porque separa a los bots que respetan tus reglas de los que no. Wikipedia señala que 306 de los 1.000 sitios web más visitados bloquearon el GPTBot de OpenAI en 2023, lo que demuestra cómo los propietarios de sitios usan ahora el archivo como declaración de política. Un bot que solicita páginas que has prohibido te dice algo importante sobre su intención.
Se acerca la identidad de bots firmada
La solución a largo plazo para la suplantación es la identidad criptográfica. El Internet Engineering Task Force (IETF) ha creado un grupo de trabajo Web Bot Auth para estandarizar cómo los bots pueden demostrar quiénes son, basándose en las firmas de mensajes HTTP. Un bot firmado adjunta una firma verificable a cada solicitud, de modo que un sitio web puede confirmar su operador sin depender de listas de IP. Seguir este trabajo ahora te ayuda a planificar qué visitantes automatizados permitirás cuando las firmas sean habituales.
Cómo detener el tráfico de bots sin bloquear a personas reales
Bloquear bots parece sencillo hasta que clientes reales quedan atrapados en la red. Las barreras CAPTCHA agresivas frustran a las personas con teléfonos lentos y crean obstáculos para los usuarios de tecnología de asistencia. Los bloqueos generales por país o centro de datos pueden dejar fuera a viajeros, usuarios de VPN corporativas y visitantes preocupados por la privacidad, y cada falso positivo es un lead perdido que nunca aparece en ningún informe.
Un enfoque moderno también debe tener en cuenta la automatización útil. Los asistentes de IA obtienen cada vez más páginas, comparan productos y completan formularios en nombre de una persona. Tratar cada solicitud no humana como hostil puede privarte de visitas que un cliente real pidió.
Un enfoque moderno también debe tener en cuenta la automatización útil. Los asistentes de IA obtienen cada vez más páginas, comparan productos y completan formularios en nombre de una persona. Tratar cada solicitud no humana como hostil puede privarte de visitas que un cliente real pidió.
Adapta la respuesta al bot
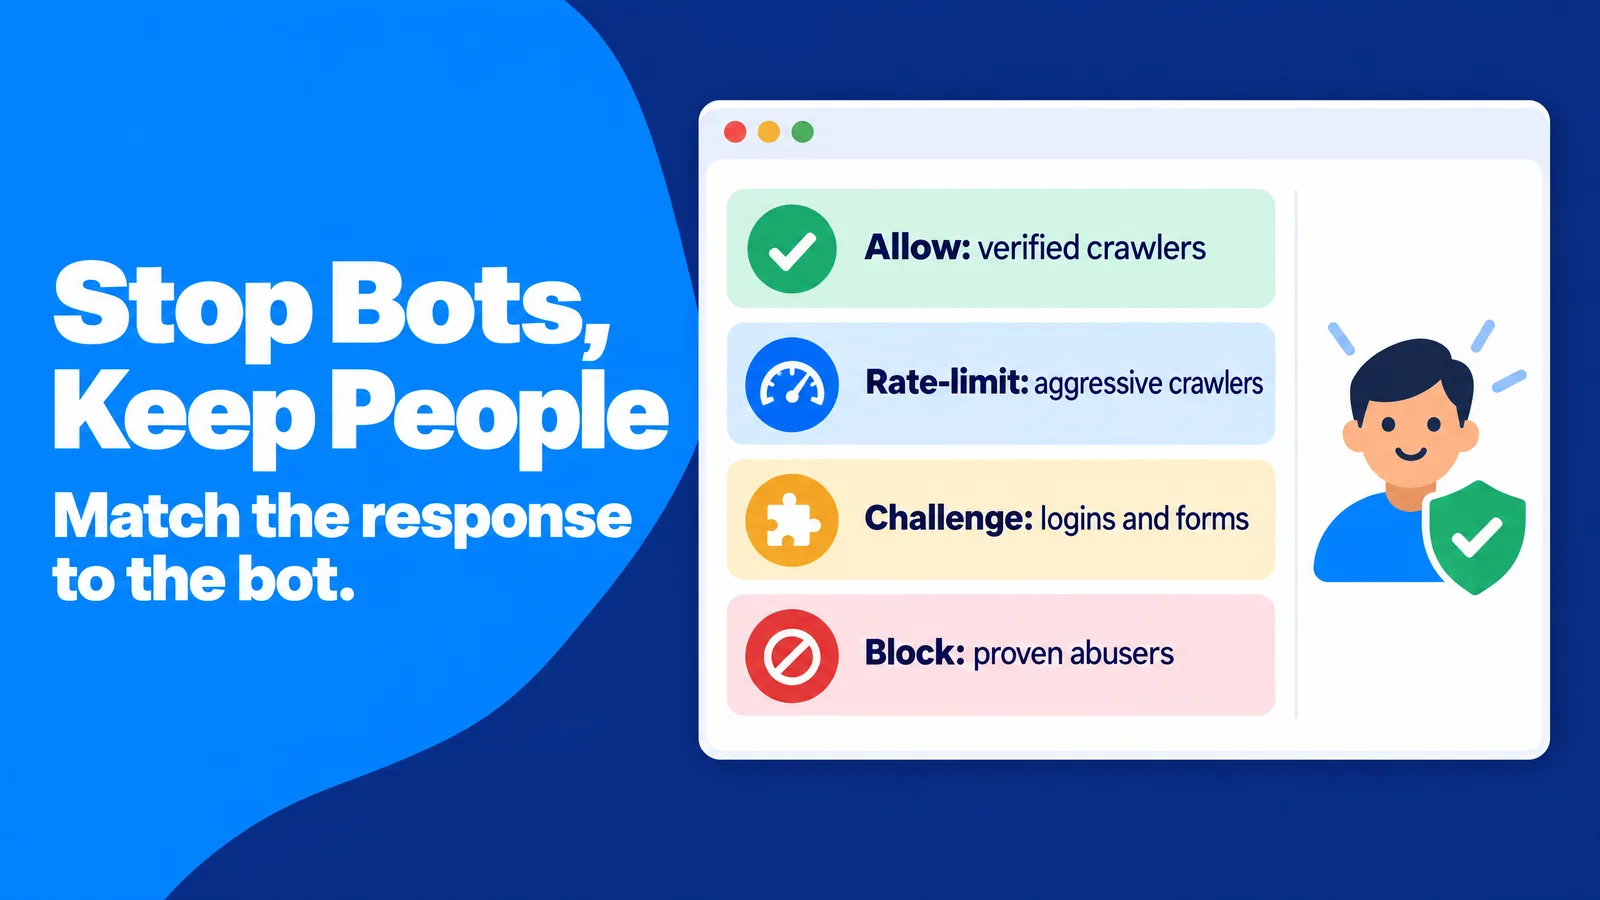
Las defensas más eficaces son graduadas, no de todo o nada. Cada tipo de visitante automatizado recibe la respuesta más leve que resuelve el problema:
- Rastreadores verificados que quieres: permitidos, porque aportan visibilidad en búsquedas y citas de IA.
- Rastreadores agresivos pero legítimos: limitados por velocidad, lo que protege el rendimiento del servidor sin interrumpir nada.
- Tráfico no verificado en páginas sensibles: sometido a un CAPTCHA o prueba similar solo en inicios de sesión, registros y proceso de compra, donde el coste del abuso es mayor.
- Abusadores demostrados: bloqueados por intervalo de IP, red o firma cuando las pruebas son claras.
Esta gradación funciona porque concentra la fricción donde el abuso causa daño real y mantiene el resto de tu sitio rápido y abierto para las personas.
Protege formularios, registros y el proceso de compra
Los formularios son donde los bots causan el daño más duradero. Los registros falsos contaminan tu CRM, activan correos de bienvenida a direcciones que rebotan y perjudican tu reputación como remitente. Los leads falsos desperdician tiempo de ventas y distorsionan los informes de coste por lead.
Paso práctico: Una primera capa sencilla es un campo honeypot: un campo de formulario oculto para las personas pero visible para los bots, de modo que cualquier envío que lo complete puede rechazarse. La validación del lado del servidor, los límites de velocidad por dirección IP y la doble confirmación para listas de correo añaden otras capas. Esta configuración funciona porque cada capa detiene un tipo distinto de bot, mientras que una persona real no nota ninguna de ellas.
Paso práctico: Una primera capa sencilla es un campo honeypot: un campo de formulario oculto para las personas pero visible para los bots, de modo que cualquier envío que lo complete puede rechazarse. La validación del lado del servidor, los límites de velocidad por dirección IP y la doble confirmación para listas de correo añaden otras capas. Esta configuración funciona porque cada capa detiene un tipo distinto de bot, mientras que una persona real no nota ninguna de ellas.
Deja una puerta abierta para los agentes de IA que actúan por personas
Algunas visitas automatizadas representan ahora demanda real. Un agente de IA que consulta tus precios o reserva una demo para un usuario es una interacción de cliente realizada por software. Bloquearlo de forma tajante puede costarte una venta, mientras que dejarlo pasar sin revisarlo puede distorsionar tus métricas de interacción.
El punto medio práctico es identificar estos agentes por separado, permitirlos en las páginas públicas y medirlos en su propio segmento. Nuestra guía sobre tráfico de IA agéntica explica cómo aparecen las visitas asistidas por agentes en la analítica y cómo preparar tus páginas para ellas.
El punto medio práctico es identificar estos agentes por separado, permitirlos en las páginas públicas y medirlos en su propio segmento. Nuestra guía sobre tráfico de IA agéntica explica cómo aparecen las visitas asistidas por agentes en la analítica y cómo preparar tus páginas para ellas.
Cómo mantener limpias las campañas de tráfico de pago
El tráfico de pago es donde el tráfico de bots perjudica tu presupuesto más directamente. Cada clic o impresión no válidos son dinero gastado en nadie. El riesgo es mayor con inventario barato y amplio y con proveedores que no pueden decir de dónde proceden sus visitas, porque su incentivo es el volumen, no los resultados.
Algunas ofertas son bots de tráfico disfrazados. Las señales de alerta incluyen promesas de visitas "indetectables" o que "parecen reales", mejoras garantizadas de posicionamiento en buscadores, visitantes ilimitados por una tarifa plana y redes de proxies residenciales presentadas como una característica. En cambio, las plataformas publicitarias legítimas hablan de segmentación, ubicaciones, revisión de la página de destino y medición. Comprar visitas de bots siempre sale mal: las visitas nunca convierten, contaminan tus pruebas, las redes publicitarias pueden vetar sitios monetizados que las reciben y la compra en sí puede infringir normas de protección al consumidor.
Algunas ofertas son bots de tráfico disfrazados. Las señales de alerta incluyen promesas de visitas "indetectables" o que "parecen reales", mejoras garantizadas de posicionamiento en buscadores, visitantes ilimitados por una tarifa plana y redes de proxies residenciales presentadas como una característica. En cambio, las plataformas publicitarias legítimas hablan de segmentación, ubicaciones, revisión de la página de destino y medición. Comprar visitas de bots siempre sale mal: las visitas nunca convierten, contaminan tus pruebas, las redes publicitarias pueden vetar sitios monetizados que las reciben y la compra en sí puede infringir normas de protección al consumidor.
Etiqueta cada fuente de pago
El tráfico de pago sin etiquetar se mezcla con Direct y Referral, donde los bots se ocultan fácilmente. Los parámetros UTM son etiquetas añadidas a un enlace que indican a tu herramienta de analítica exactamente qué fuente, campaña y ubicación enviaron una visita.
Paso práctico: Una regla UTM sencilla resuelve la mayoría de las brechas de atribución: cada campaña de pago recibe sus propios valores de fuente, medio y campaña, registrados en una hoja de nomenclatura compartida. Esto funciona porque la prueba de cinco comprobaciones necesita un segmento limpio para ejecutarse y, si las visitas de pago se mezclan con Direct, no puedes saber qué proveedor envió las sesiones sospechosas.
Paso práctico: Una regla UTM sencilla resuelve la mayoría de las brechas de atribución: cada campaña de pago recibe sus propios valores de fuente, medio y campaña, registrados en una hoja de nomenclatura compartida. Esto funciona porque la prueba de cinco comprobaciones necesita un segmento limpio para ejecutarse y, si las visitas de pago se mezclan con Direct, no puedes saber qué proveedor envió las sesiones sospechosas.
Haz una prueba pequeña antes de escalar
Un presupuesto de prueba pequeño te dice si una fuente se comporta como personas antes de que comprometas dinero real. Unos cientos de sesiones bastan para ejecutar las cinco comprobaciones y una semana de datos muestra los ritmos diarios. La misma disciplina mejora el trabajo de tu página de destino, como muestra nuestra guía sobre pruebas A/B de una página de destino con tráfico de pago.
Los formatos de anuncios también importan. El tráfico popunder, nativo y push produce patrones de interacción diferentes, porque un visitante de popunder se comporta de forma distinta de alguien que eligió hacer clic en un anuncio nativo. Juzgar cada formato frente a su propia referencia evita falsas alarmas.
Los formatos de anuncios también importan. El tráfico popunder, nativo y push produce patrones de interacción diferentes, porque un visitante de popunder se comporta de forma distinta de alguien que eligió hacer clic en un anuncio nativo. Juzgar cada formato frente a su propia referencia evita falsas alarmas.
Considera las políticas de reembolso y crédito como señales de calidad
Las plataformas reputadas esperan que compruebes su tráfico y explican qué ocurre cuando algo parece incorrecto. Una buena plataforma tiene un proceso claro: qué pruebas necesita, cómo revisa un informe y si acredita la actividad no válida. Un proveedor que rechaza toda revisión, o afirma que su tráfico es "100 % humano", te está diciendo algo. Incluso el MRC evita llamar "humano" al tráfico filtrado y prefiere la palabra "válido", porque ningún filtro puede garantizar que cada visita restante sea una persona.
Estrategia avanzada: realiza una auditoría mensual del tráfico de bots
Las investigaciones puntuales resuelven problemas puntuales. Los bots cambian, las campañas cambian y tus propias herramientas cambian, así que una breve rutina mensual detecta los problemas antes de que distorsionen un trimestre de decisiones. El objetivo no es tener cero tráfico de bots, lo cual es imposible. El objetivo es tener tráfico de bots conocido, medido y documentado.
Una rutina mensual de 30 minutos
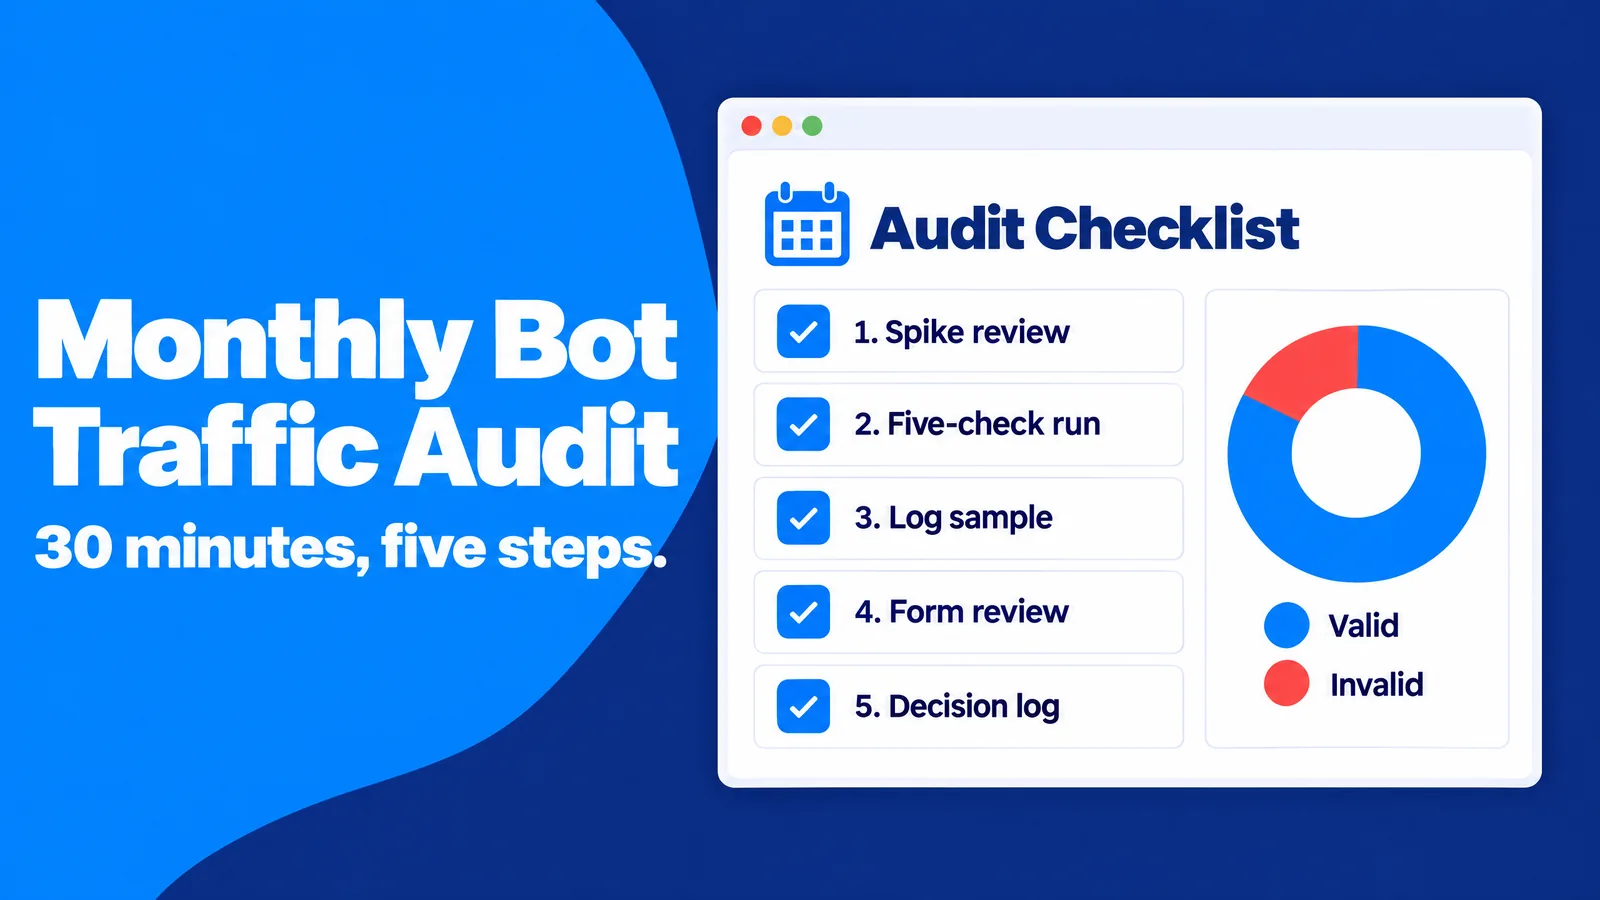
Una auditoría recurrente funciona mejor cuando sigue los mismos pasos cada vez, para que las tendencias se hagan visibles:
- Revisión de picos: cada pico de tráfico del último mes anotado con su causa o marcado como sin explicación.
- Ejecución de cinco comprobaciones: cada fuente y campaña principal evaluada según las cinco comprobaciones.
- Muestra de registros: los principales rastreadores declarados verificados con DNS inverso con confirmación directa.
- Revisión de formularios: registros y leads comprobados en busca de nombres idénticos, dominios de correo desechables o ráfagas repentinas.
- Registro de decisiones: un registro de lo que filtraste, bloqueaste o denunciaste y por qué.
Esta rutina funciona porque convierte la detección de bots en un hábito con un registro documental. Cuando una parte interesada pregunte por qué cambiaron las cifras de marzo, tendrás la respuesta.
Redacta una política de tráfico no válido de una página
Incluso los expertos tienen dificultades para definir con precisión el tráfico no válido. El Informe Tuzhilin, una revisión independiente de la detección de fraude de clics de Google descrita en el artículo de Wikipedia sobre el fraude de clics, concluyó que "no existe una definición conceptual de clics no válidos que pueda operacionalizarse" salvo en los casos obvios. Si el sector no puede acordar una definición, tu equipo se beneficia de tener la suya.
Paso práctico: Una política de una página resuelve la mayoría de las discusiones por adelantado. Indica qué visitantes automatizados permites, qué umbrales desencadenan una revisión, quién decide y cómo se comunican los hallazgos a agencias y proveedores. Esto funciona porque una regla escrita sustituye los debates caso por caso y ofrece a los socios un estándar claro que cumplir.
Paso práctico: Una política de una página resuelve la mayoría de las discusiones por adelantado. Indica qué visitantes automatizados permites, qué umbrales desencadenan una revisión, quién decide y cómo se comunican los hallazgos a agencias y proveedores. Esto funciona porque una regla escrita sustituye los debates caso por caso y ofrece a los socios un estándar claro que cumplir.
Vigila las métricas que los bots no pueden falsear de forma barata
Las páginas vistas y las sesiones son baratas de falsear. Los ingresos, los leads cualificados, las compras repetidas, los tickets de soporte y los usuarios recurrentes con sesión iniciada son caros o imposibles de falsear a escala. Una fuente de tráfico que añade sesiones pero nunca mueve estas cifras merece escrutinio, por muy buena que parezca su interacción.
Basar tus informes en estas métricas de resultados es la defensa más sólida a largo plazo. Alinea cada decisión de tráfico con lo que las personas hacen realmente y elimina el incentivo de que cualquiera en tu cadena de suministro infle las cifras.
Basar tus informes en estas métricas de resultados es la defensa más sólida a largo plazo. Alinea cada decisión de tráfico con lo que las personas hacen realmente y elimina el incentivo de que cualquiera en tu cadena de suministro infle las cifras.
Preguntas frecuentes sobre los bots de tráfico
¿Qué es un bot de tráfico en términos sencillos?
Un bot de tráfico es un software que visita sitios web o hace clic en anuncios automáticamente para que la actividad parezca proceder de personas reales. Normalmente infla métricas como las páginas vistas, los clics, las visualizaciones de vídeo o los seguidores.
¿Todo el tráfico de bots es malo?
No. Los rastreadores de los motores de búsqueda, los monitores de disponibilidad y muchos rastreadores de IA son útiles. El tráfico de bots se convierte en un problema cuando pretende ser humano, desperdicia gasto publicitario, extrae contenido contra tus reglas o distorsiona tus analíticas.
¿Puede el tráfico de bots perjudicar mi SEO?
Las visitas falsas no mejoran las clasificaciones, porque los motores de búsqueda se basan en muchas señales de calidad y no en el recuento bruto de visitas. El tráfico de bots aún puede perjudicarte indirectamente al ralentizar tu servidor, copiar tu contenido y llevarte a optimizar las páginas equivocadas con datos contaminados.
¿Google Analytics 4 filtra automáticamente el tráfico de bots?
Sí. GA4 excluye automáticamente los bots y arañas conocidos, y no puedes desactivar esta función ni ver cuánto ha eliminado. Los bots desconocidos y sofisticados aún pueden llegar a tus informes, por lo que las comparaciones de segmentos y las cinco comprobaciones siguen siendo necesarias.
¿Cuánto tráfico de bots es normal?
No hay una cifra universal. Más de la mitad de todo el tráfico web está automatizado, pero la mayor parte nunca ejecuta tu código de analítica. Una referencia práctica es tu propio canal de confianza: las fuentes que se desvían mucho de él merecen una revisión más detallada.
¿Cómo detengo el tráfico de bots en mi sitio web?
El enfoque más eficaz es graduado. Se permiten los rastreadores verificados, se limita la velocidad de los rastreadores agresivos, se somete a pruebas el tráfico no verificado solo en inicios de sesión y formularios, y se bloquea a los abusadores demostrados. Los campos honeypot, la validación del lado del servidor y los filtros de GA4 para nombres de host y tráfico interno mantienen limpios tanto tus formularios como tus informes.
¿Cómo puedo saber si el tráfico de mi sitio web procede de bots?
La forma más rápida es comparar una fuente sospechosa con un canal en el que confías en cinco dimensiones: duración de la sesión, resoluciones de pantalla, hora del día, ubicación e interacción. Dos o más fallos claros, como duraciones de sesión idénticas y volumen nocturno igual al volumen diurno, sugieren firmemente tráfico automatizado. Los registros del servidor y el DNS inverso con confirmación directa confirman después si los rastreadores que se declaran a sí mismos son auténticos.
¿Es legal comprar tráfico de bots?
Las normas varían según el país, pero comprar interacción falsa para uso comercial conlleva riesgos legales y empresariales reales. En Estados Unidos, la norma de la FTC de 2024 prohíbe comprar o vender indicadores falsos de influencia en redes sociales, como seguidores o visualizaciones generados por bots, con fines comerciales. Las redes publicitarias también prohíben el tráfico falso en sus políticas.
Conclusión: mide para las personas, no para los contadores
Los bots de tráfico existen porque la actividad falsa es barata de producir y fácil de vender. Tu defensa es tener una imagen clara de cómo son las personas reales en tu sitio. Las cinco comprobaciones, una referencia de confianza, la verificación a nivel de servidor y una auditoría mensual te dan esa imagen sin herramientas caras.
La web antigua recompensaba las cifras altas. La web actual recompensa la confianza: los motores de búsqueda, los anunciantes, los sistemas de IA y los clientes responden a una interacción genuina. Cuando proteges tus datos de los bots, proteges cada decisión que depende de ellos y mantienes la atención en el público que compra, se suscribe y vuelve: personas reales.
La web antigua recompensaba las cifras altas. La web actual recompensa la confianza: los motores de búsqueda, los anunciantes, los sistemas de IA y los clientes responden a una interacción genuina. Cuando proteges tus datos de los bots, proteges cada decisión que depende de ellos y mantienes la atención en el público que compra, se suscribe y vuelve: personas reales.