O tráfego de IA agêntica está se tornando uma questão real de mensuração para profissionais de marketing, pois uma visita pode agora ser realizada por um software a serviço da intenção de uma pessoa. Sua plataforma de análise pode registrar a solicitação, a visualização da página e os eventos, mas a pessoa que pediu a pesquisa talvez nunca veja a página em um navegador convencional. Tratar todas as sessões registradas como iguais pode obscurecer a diferença entre a atenção do público e um agente de navegador concluindo uma tarefa.
Essa questão importa mesmo antes de os agentes se tornarem um grande canal de aquisição. Em um estudo do Pew Research Center, usuários clicaram em um resultado tradicional em 8% das visitas ao Google com um resumo de IA, em comparação com 15% das visitas sem resumo. À medida que sistemas de IA respondem, pesquisam, comparam e agem, o caminho entre uma pergunta e seu site tem mais etapas. Uma boa mensuração permite enxergar essas etapas sem confundir a atividade assistida por agentes com um público humano.
Essa questão importa mesmo antes de os agentes se tornarem um grande canal de aquisição. Em um estudo do Pew Research Center, usuários clicaram em um resultado tradicional em 8% das visitas ao Google com um resumo de IA, em comparação com 15% das visitas sem resumo. À medida que sistemas de IA respondem, pesquisam, comparam e agem, o caminho entre uma pergunta e seu site tem mais etapas. Uma boa mensuração permite enxergar essas etapas sem confundir a atividade assistida por agentes com um público humano.
O que é tráfego de IA agêntica?
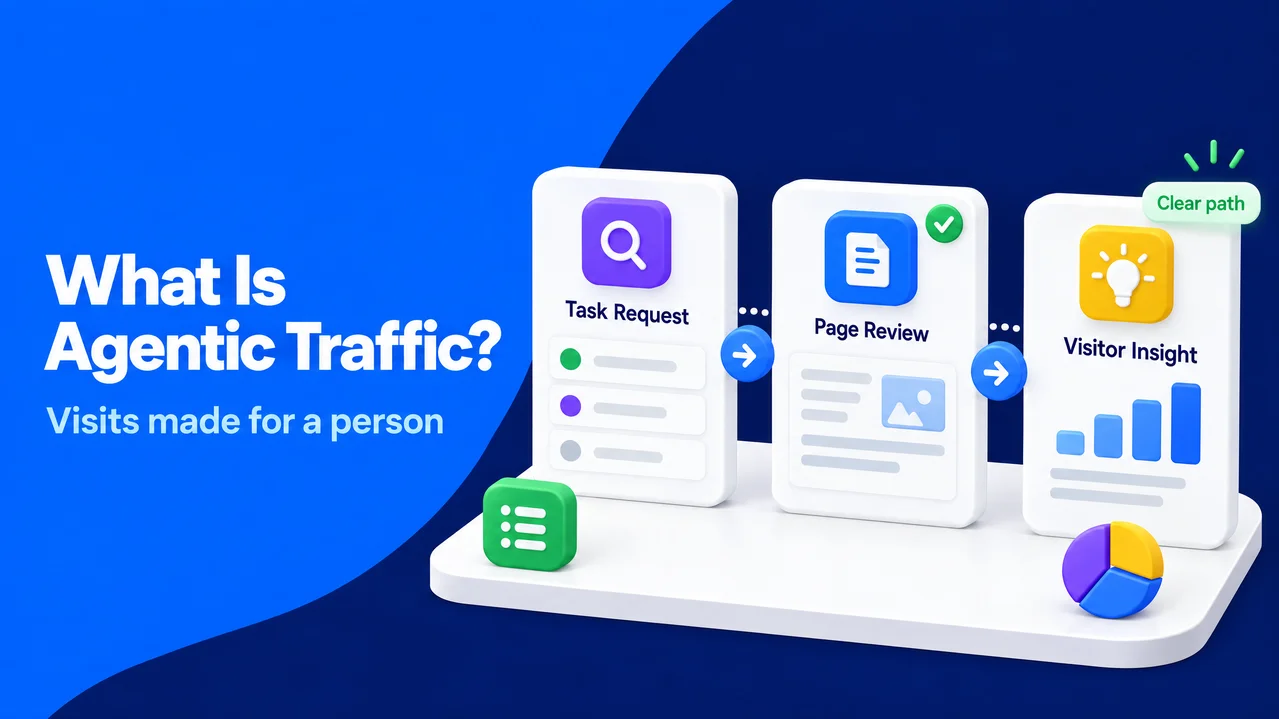
A resposta simples à pergunta o que é tráfego de IA agêntica é: visitas feitas por um agente ou navegador de IA que age em nome de uma pessoa. Um agente de IA pode tomar decisões, buscar objetivos, usar ferramentas e executar ações em várias etapas, em vez de apenas fornecer uma resposta. Essa descrição dos agentes de IA é útil para profissionais de marketing porque a característica importante é a ação. O sistema pode abrir páginas, comparar informações, executar parte de um fluxo de trabalho ou apresentar um resumo ao usuário.
O tráfego agêntico é diferente de uma visita humana por referência. Uma pessoa que segue um link de uma resposta de IA geralmente carrega o site no próprio navegador. Em uma sessão agêntica, o usuário pede a um software que investigue ou execute uma tarefa, e o software visita um site em nome desse usuário.
Dois exemplos de navegadores voltados ao consumidor tornam isso menos teórico. O ChatGPT Atlas foi lançado em outubro, no dia 21, de 2025, com um modo agêntico capaz de realizar ações online em nome de um usuário. A Perplexity lançou o Comet em julho de 2025, descrevendo-o como um navegador de IA. Esses produtos não significam que toda visita proveniente de seus ecossistemas seja agêntica. Eles mostram por que o tráfego de navegadores de IA precisa de um processo próprio de análise.
Uma medida prática é definir o tráfego agêntico pelo comportamento e pela finalidade, não pelo nome de um único produto. Você pode contabilizar uma busca de conteúdo no lado do servidor para uma tarefa do usuário, uma tarefa de pesquisa renderizada no navegador e uma revisão concluída de formulário como casos distintos. Essa distinção funciona porque a questão na análise é se o software recuperou uma página em nome de uma pessoa, renderizou essa página para uma tarefa ou trouxe um leitor humano capaz de fazer uma escolha informada.
SparkTraffic e uma referência de tráfego de pessoas reais
É mais fácil separar sessões de agentes das sessões de pessoas quando você também sabe como é a atividade humana genuína gerada por campanhas. SparkTraffic é uma plataforma de publicidade que entrega visitas ao site, segmentadas geograficamente, realizadas por pessoas reais por meio de uma rede de publishers verificada. Por isso, seu guia sobre tráfego de IA é relevante para equipes que precisam de uma referência clara enquanto avaliam novas visitas relacionadas à IA. Sua função aqui é prática: testes de tráfego de qualidade podem ajudar as equipes a validar a coleta de eventos, as páginas de destino e os relatórios, sem afirmar que visitas pagas alteram as classificações nos resultados de busca.
SparkTraffic também publica cinco verificações para confirmar se os visitantes são pessoas reais: distribuição da duração das sessões, resoluções de tela, horário do dia, localização e interações. Essas verificações são úteis porque qualquer sinal isolado pode induzir ao erro. Uma sessão curta pode ser de uma pessoa ocupada, uma tela pequena pode corresponder a tráfego móvel legítimo, e uma localização conhecida, por si só, não comprova quem visualizou uma página. Um padrão que combina vários sinais é mais informativo do que um alerta isolado.
Para garantir a qualidade da análise, você pode comparar uma campanha humana conhecida e alinhada ao consentimento com sessões que suspeita serem agênticas. Uma abordagem útil é usar páginas de teste com noindex para experimentos A/B, quando apropriado, rotular o tráfego com UTMs e comparar a sequência de eventos em vez dos totais gerais. Isso favorece um padrão que prioriza as pessoas: pessoas reais devem receber páginas relevantes e opções claras, enquanto a mensuração permanece transparente sobre o que o sistema observou.
Por que o tráfego agêntico cria um problema de mensuração
Uma métrica tradicional da web pressupõe uma relação direta: uma pessoa abre uma página, o navegador envia solicitações e a ferramenta de análise registra uma sessão. O tráfego de agentes de IA pode romper essa relação. O agente pode recuperar o HTML bruto, executar JavaScript em um ambiente de navegador, extrair conteúdo estruturado ou resumir uma página sem exibi-la em uma aba visível para o usuário. Portanto, uma única solicitação subjacente pode representar nenhum tempo de leitura humana, pesquisa humana assistida ou um agente executando uma instrução.
O Reuters Institute formulou bem a questão: se um navegador com IA resume conteúdo em nome de uma pessoa, isso conta como uma visita humana? Seu relatório de tendências de 2026 também observa que as indicações do ChatGPT estavam crescendo rapidamente, enquanto o Google ainda enviava muito mais indicações. A questão não é filosófica. Ela afeta os relatórios de público, as decisões de publicidade, as prioridades de conteúdo e a análise de conversões.
O próximo passo é separar dois resultados nos seus relatórios:
- Sessões indicadas por pessoas, nas quais uma pessoa acessa seu site depois que uma ferramenta de IA o cita ou recomenda.
- Sessões assistidas por agentes, nas quais um software renderiza ou lê páginas para uma tarefa específica do usuário e pode gerar eventos de análise.
Essas categorias separam a atenção do público dos sinais operacionais úteis. Uma pessoa que clica para ver mais detalhes pode estar altamente engajada; uma consulta à página de preços pode indicar interesse, mas não equivale a uma visita humana.
Como as sessões de agentes podem aparecer nas ferramentas de análise
Nem sempre será fácil distinguir sessões agênticas de sessões indicadas por pessoas. Alguns agentes executam JavaScript e usam uma pilha completa de navegador, então visualizações de página, eventos de rolagem e até tags do lado do cliente podem se parecer com uma sessão humana. Uma equipe que rotula toda visita rápida como assistida por agente classificará pessoas reais incorretamente.
Vale a pena procurar combinações de sinais, em vez de aplicar uma única regra. Uma sessão pode ter duração excepcionalmente curta, mas solicitar muitas páginas em intervalos regulares. Pode percorrer um formulário muito rapidamente, abrindo uma página de preços e outra de políticas antes de chegar a um formulário em segundos. Pode informar dimensões de tela incomuns, um endereço IP de data center, uma impressão digital de navegador limitada ou uma versão de navegador incompatível com o dispositivo declarado. São indícios, não veredictos.
As evidências do lado do servidor muitas vezes fornecem contexto que a análise do lado do cliente não consegue oferecer. Os logs da web podem preservar o horário da solicitação, o IP ou a classificação da rede, a string do agente do usuário, a URL solicitada, o código de status, o referenciador e o padrão dos cabeçalhos. Você pode associar esses dados a uma solicitação própria ou a um identificador de sessão quando suas regras de privacidade permitirem. Uma boa prática é limitar o período de retenção dos logs brutos e documentar os controles de acesso, especialmente se seu site opera sob o GDPR ou outro regime de privacidade.
Uma análise prática consiste em agrupar sessões por origem, agente do usuário, rede IP, tamanho da tela e sequência de eventos, e então inspecionar os casos atípicos. Por exemplo, você pode comparar o tempo mediano entre o carregamento da página e a interação com um campo do formulário em uma campanha normal com o de um grupo suspeito. O método funciona porque o percurso de uma pessoa apresenta variações naturais, enquanto os fluxos de tarefas assistidos por agentes podem repetir a mesma ordem e o mesmo tempo. Também evita reações exageradas: um caso atípico se torna uma pista para investigação, não um motivo para exclusão imediata.
Como identificar tráfego agêntico com evidências em camadas
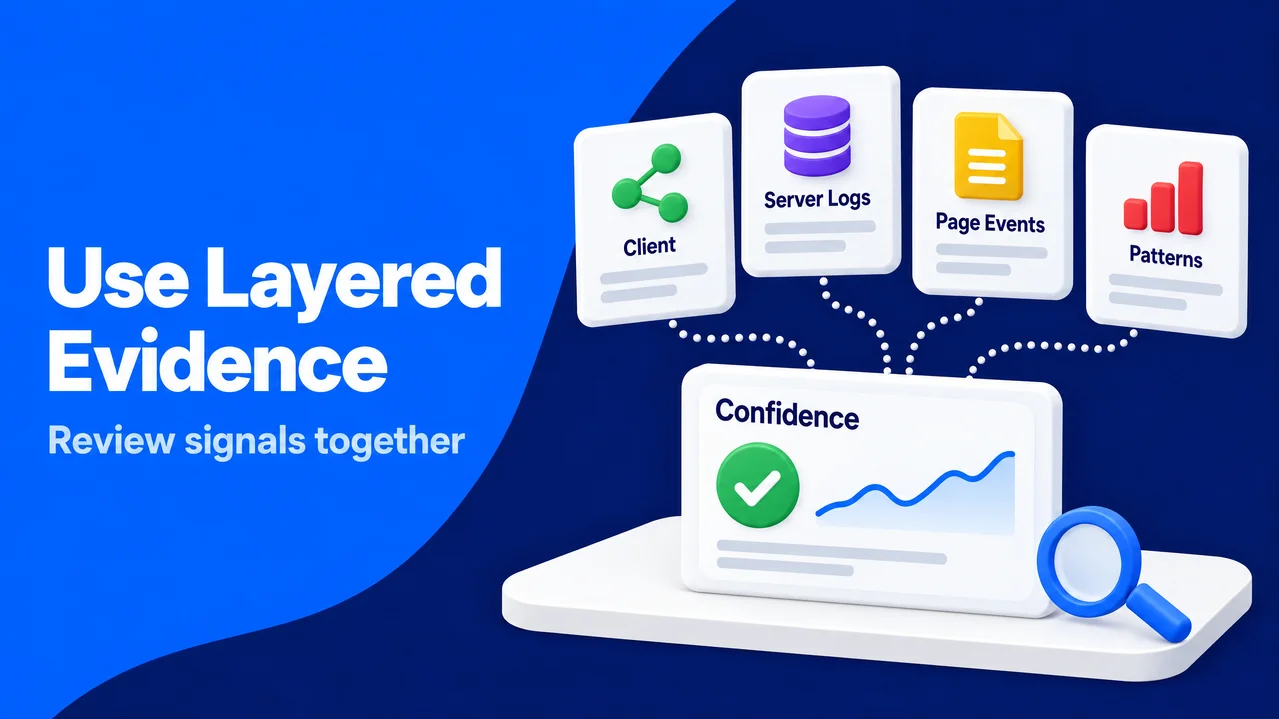
Uma identificação confiável usa camadas de evidências que respondem a perguntas diferentes. O agente do usuário informa o que o cliente declara ser. Os logs do servidor mostram o padrão das solicitações. Os eventos do navegador mostram como a página foi executada. Os sinais comportamentais indicam se a sequência se parece com o uso humano. Nenhum desses elementos, isoladamente, comprova a história completa, e strings de agente do usuário podem ser copiadas.
Um bom ponto de partida são os clientes de agentes conhecidos e declarados que atuam em nome de pessoas. Você pode manter uma lista monitorada de identificadores de agentes documentados e rotular as solicitações correspondentes como atividade declarada e assistida por agentes em uma dimensão derivada dos logs. Uma revisão mensal da lista é útil porque os identificadores dos clientes mudam. O valor está na consistência: sua equipe pode explicar por que uma sessão foi rotulada e corrigir uma correspondência incorreta sem reescrever conclusões históricas.
Em seguida, você pode comparar o comportamento por grupo. Percursos de navegação repetidos, solicitações espaçadas regularmente, preenchimento instantâneo de formulários com vários campos e muitas sessões provenientes de redes de hospedagem podem reforçar a hipótese de uso de um agente. Essas evidências, por si só, não justificam negar acesso. Ferramentas de acessibilidade, serviços de privacidade, redes corporativas compartilhadas e usuários muito eficientes podem parecer incomuns. Limites de taxa, proteções de formulários e análises manuais devem se concentrar em danos ou abusos claros, não na suposição de que rapidez equivale a má intenção.
A identidade de agente assinada é um sinal adicional emergente. O Internet-Draft em andamento da IETF descreve clientes HTTP que assinam solicitações criptograficamente para que os servidores possam verificar a identidade, incluindo um cabeçalho Signature-Agent. O trabalho ainda está em andamento, não é um padrão final, então vale registrar assinaturas válidas como um rótulo de alta confiança, sem tratar o tráfego não assinado como suspeito. A adoção será desigual, e uma assinatura identifica um cliente, não necessariamente o nível de atenção humana por trás dele.
Para um fluxo de trabalho de mensuração mais detalhado, você pode combinar essa abordagem com um guia sobre como rastrear tráfego de IA. É útil deixar as classificações resultantes visíveis para os analistas. Um filtro oculto pode fazer um painel parecer organizado enquanto remove sinais que as equipes de produto, conteúdo e segurança precisam examinar. Para visitas automatizadas que apenas fingem ser humanas, nosso guia sobre como identificar tráfego de bots explica quais sinais verificar primeiro.
Crie páginas que funcionem para navegadores com IA e pessoas
Um design adequado para agentes começa com as mesmas características que ajudam as pessoas. Um agente pode interpretar uma página com mais confiabilidade quando os títulos descrevem o conteúdo, o texto principal usa HTML semântico e os dados estruturados correspondem ao que um visitante consegue ver. Isso reduz a ambiguidade em tarefas de pesquisa ou comparação, enquanto as pessoas se beneficiam de uma estrutura de página mais clara e a tecnologia assistiva recebe um contexto melhor.
Os formulários exigem atenção especial porque agentes podem encontrá-los durante uma tarefa. Rótulos claros, campos obrigatórios visíveis, mensagens de erro úteis e uma página de confirmação criam uma experiência utilizável para as pessoas e um percurso mais fácil de interpretar para navegadores com IA que atuam em nome delas. Formulários acessíveis também reduzem falsos alertas na análise, porque uma sequência válida de conclusão tem estados explícitos, em vez de cliques vagos.
Preços, disponibilidade, devoluções, termos de privacidade e opções de contato devem ser fáceis de encontrar e coerentes entre si. Um agente que lê essas páginas pode resumir sua oferta com mais precisão, e uma pessoa pode verificar os detalhes sem dificuldade. A prioridade prática é a qualidade e a transparência do conteúdo, não tentativas de manipular a resposta de um agente. Texto oculto, dados estruturados enganosos, cliques forçados e páginas superficiais são contraproducentes porque prejudicam a confiança e tornam os dados menos confiáveis.
Defina uma política de mensuração antes que o volume cresça
A principal decisão de política é simples, mas importante: sua equipe pode decidir se as sessões de agentes contam como usuários. As renderizações de páginas assistidas por agentes devem ser rotuladas e relatadas separadamente das visitas de pessoas até que sua organização defina o que considera atenção qualificada. Visitas humanas provenientes de uma fonte de IA podem contar como visitas de usuários se atenderem às mesmas regras de consentimento e engajamento aplicadas a outros visitantes.
Uma medida prática é redigir a política em linguagem simples e aplicá-la a exportações, painéis e análises de desempenho. Ela pode especificar quais sinais acionam um rótulo de agente, quem pode alterar as regras, por quanto tempo os sinais brutos são retidos e se as sessões incertas permanecem em uma categoria separada. Isso funciona porque as mudanças nas métricas podem ser rastreadas. Você pode explicar uma alteração no número de usuários relatado sem ocultar a atividade subjacente.
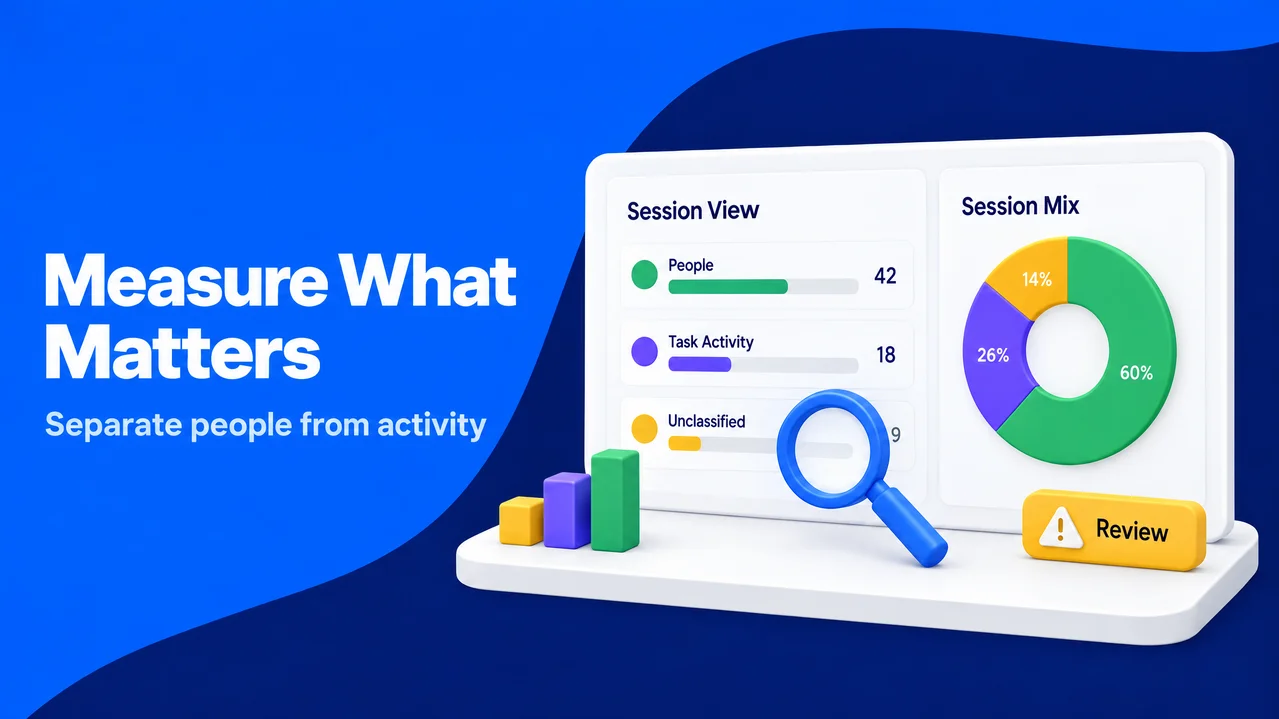
Uma visão útil para relatórios tem três linhas: sessões comprovadamente humanas ou provavelmente humanas, sessões agênticas rotuladas e sessões não classificadas. Você pode acrescentar conversões e inícios de preenchimento de formulário a cada linha, mas deve descrevê-los com cuidado. O envio de um formulário por um agente pode mostrar que um fluxo de trabalho é tecnicamente acessível; não equivale necessariamente a um lead qualificado. Em setores de alto risco, como finanças, saúde ou serviços jurídicos, consentimento, divulgação e padrões de revisão merecem atenção redobrada.
Uma análise prática do tráfego de IA agêntica
O tráfego de IA agêntica é um novo sinal útil quando você preserva a distinção entre a atividade do software e a atenção humana. Ele deve estimular melhor observabilidade, páginas mais claras e relatórios precisos sobre o público. Seu público continua sendo composto por pessoas, mesmo quando um agente de navegador as ajuda a fazer pesquisas.
Uma revisão mensal sensata pode incluir estas etapas:
Uma revisão mensal sensata pode incluir estas etapas:
- Comparação de grupos de tráfego indicado por IA, identificado como agêntico e de campanhas humanas conhecidas, considerando a sequência de eventos e a qualidade das conversões.
- Inspeção de uma amostra de logs incomuns antes de alterar uma regra de exclusão.
- Verificação de que HTML semântico, dados estruturados, formulários acessíveis, preços e políticas continuam de acordo com o conteúdo visível da página.
- Registro de quaisquer sinais de agente assinado em um campo de confiança separado enquanto o padrão é desenvolvido.
- Revisão da política de contagem de usuários com os responsáveis por análise, produto, privacidade e segurança.
Essa abordagem oferece uma resposta defensável à medida que as ferramentas mudam. Você pode permitir o acesso relevante de agentes, proteger formulários e infraestrutura contra abusos e relatar com honestidade quais visitas refletem uma pessoa interagindo ativamente com seu site.